단원 홈

Ⅲ. 데이터 모델링과 평가14차시

세 사람이 같은 데이터로
다른 것을 묻는다면

'가장 좋은 분석 방법'은 하나가 아니다

따릉이 표 한 장을 두고 의뢰 세 장이 같은 날 들어옵니다. 보고서에 쓸 한 문장, 내일 아침 트럭을 보낼 가장 덜 틀린 숫자, 그리고 아직 와 본 적 없는 더운 날. 같은 비교표를 놓고도 세 방의 1등이 다른 까닭을 따라가고, '답할 수 없다'가 답이 되는 자리를 만납니다.

  • [12데과03-06]
  • [12데과03-05]
  • 50분네 정거장
  • 새 도구랜덤 포레스트
  • 자료서울 따릉이 하루 단위 · 운영한 353일(훈련 264 · 시험 89)
Ⅲ 단원 지도14 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    분석 방법을 네 가지 자 — 성능 · 효율 · 설명 · 적용 범위 — 로 견줄 수 있다.

  2. 손으로

    세 방법을 같은 시험으로 돌려 비교표를 만들고, 무게를 바꿔 고른 방법이 바뀌는 것을 본다.

  3. 확인에서

    의뢰마다 고른 방법과 그 방법의 한계를 한 줄로 적고, '답할 수 없다'를 쓸 자리를 가린다.

1
여는 장면 · 5분

같은 날, 같은 표를 달라는 사람이 셋

여러분은 시청 데이터팀의 분석가입니다. 책상 위에는 지난 1년 따릉이 기록을 하루 단위로 정리한 표 한 장이 있습니다 — 날짜 · 기온 · 강수량 · 공휴일 · 그날 대여 수. 운영한 날만 세면 353일입니다.

오늘 아침, 이 표를 달라는 의뢰가 세 장 들어왔습니다. 세 사람이 원하는 것은 같은 표에서 나오는 서로 다른 것입니다. 보고서에 실을 문장, 내일 아침에 쓸 숫자, 그리고 아직 오지 않은 날에 대한 대비.

세 장을 한꺼번에 받았으니 방법도 한 가지로 정하면 편할 것 같습니다. 정말 그럴까요?

시청 데이터팀 · 가상 메모

따릉이 일자료, 오늘 안에 세 부서로 — 분석 방법은 팀에서 알아서 정해 주세요

보낸 사람: 데이터팀장 · 이 메모는 수업을 위해 지어낸 것입니다
표 1책상 위의 의뢰서 세 장같은 표 · 다른 물음 · 다른 쓰임
의뢰묻는 것결과로 하는 일틀리면 생기는 일
㉮ 시청 정책실 비가 오면 대여가 얼마나 주는가 — 보고서에 실을 한 문장으로 의회에 보고하고, 그 문장으로 예산을 설득한다 문장이 혼자 돌아다니며 여러 해 인용된다
㉯ 재배치 차고 내일 대여량을 가장 덜 틀리게 새벽에 트럭으로 자전거를 옮긴다 그날 아침 어느 대여소가 비거나 넘친다
㉰ 폭염 대책반 지금까지 관측한 가장 더운 날보다 3°C 더 더운 날이 오면? 그늘막·물병 배치와 안내 문자를 미리 준비한다 준비가 모자라거나, 쓰지 않을 곳에 예산이 간다

세 물음은 표에서 뽑아내는 것이 서로 다릅니다 — ㉮ 는 말을, ㉯ 는 숫자를, ㉰ 는 표 밖의 값을 원합니다. 자료: 서울 따릉이 일 단위 353일(UCI Seoul Bike Sharing, CC BY 4.0) · 의뢰 셋은 수업을 위해 지어낸 상황

먼저 예측

세 의뢰인 모두에게 한 가지 방법을 권한다면 무엇을 권하겠습니까? 그리고 그 방법이 세 방 모두에서 1등일 것 같은지, 1등이 갈린다면 어느 방에서 갈릴 것 같은지 적어 두세요. 2정거장 「파견 데스크」에서 여러분의 예측을 직접 채점하게 됩니다.

체크포인트 1

세 의뢰가 같은 표에서 서로 다른 것을 원한다는 것을 읽었고, 한 방법으로 셋을 다 덮을 수 있을지 짐작을 적어 두었다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

견주는 자 넷, 그리고 그 자에 매기는 무게

2-1한 표에 네 가지 자를 놓는다

지금까지 배운 방법 셋을 같은 자료·같은 시험으로 돌려 한 표에 모았습니다. 통계적 회귀(3·5차시) · 결정 트리(5차시) · 랜덤 포레스트 — 마지막 하나는 서로 조금씩 다른 나무 100그루를 길러 그 답을 평균 내는 방법으로, 오늘 처음 씁니다.

Ⅲ-12 에서 가져옴시간으로 이어지는 자료는 섞지 않습니다. 앞 264일로 배우고 뒤 89일을 맞히는 shuffle=False 나누기를 세 방법에 똑같이 씁니다 — 자가 같아야 비교표가 됩니다.

표 2세 방법을 한 표에같은 264일로 배우고 같은 89일을 맞혔다
방법성능
시험 89일 RMSE
효율
학습 ms
설명
한 문장으로 말할 수 있나
적용 범위
36.7°C 의 답
통계적 회귀6,3238.9기온 1°C +679대 · 비 1mm −285대 · 쉬는날 −2,431대34,498
결정 트리6,1497.8갈림 여덟 칸을 말로 읽는다 — 예: 11°C 아래 · 4°C 위 · 비 0mm 면 12,126대21,742
랜덤 포레스트5,833398.3나무 100그루의 평균 — 한 문장이 나오지 않는다22,103

네 칸의 1등이 서로 다릅니다 — 성능은 숲, 효율은 트리, 설명은 회귀(문장을 내는 것은 회귀와 트리 둘입니다). 적용 범위 칸에는 1등이 없습니다: 훈련 264일 가운데 36.7°C 이상인 날이 0일이라, 세 숫자 모두 기댈 근거가 없습니다. 자료: 서울 따릉이 353일 — 3정거장 코드 ①이 찍는 값과 같다(브라우저 Pyodide 실측)

효율을 잴 때 주의할 것이 하나 있습니다. 첫 학습에는 도구를 처음 준비하는 시간이 섞입니다. 같은 회귀인데 첫 fit 은 19.9ms, 두 번째는 8.9ms 였어요. 그래서 한 번 돌려 두고 두 번째 학습 시간을 재는 것이 정직한 방법입니다. 1차시부터 만나 온 '처음 몇 초'가 여기서도 숫자를 흔듭니다.

그리고 이 셋은 모두 scikit-learn 이라 fit 과 predict 두 함수가 똑같습니다. 한 반복문 안에서 이름만 바꿔 끼우면 되지요. 도구는 바꿔 보는 값을 싸게 만들어 주지만, 무엇으로 고를지는 주지 않습니다. 그것이 오늘의 일입니다.

2-2같은 표, 다른 1등 — 무게가 고른다

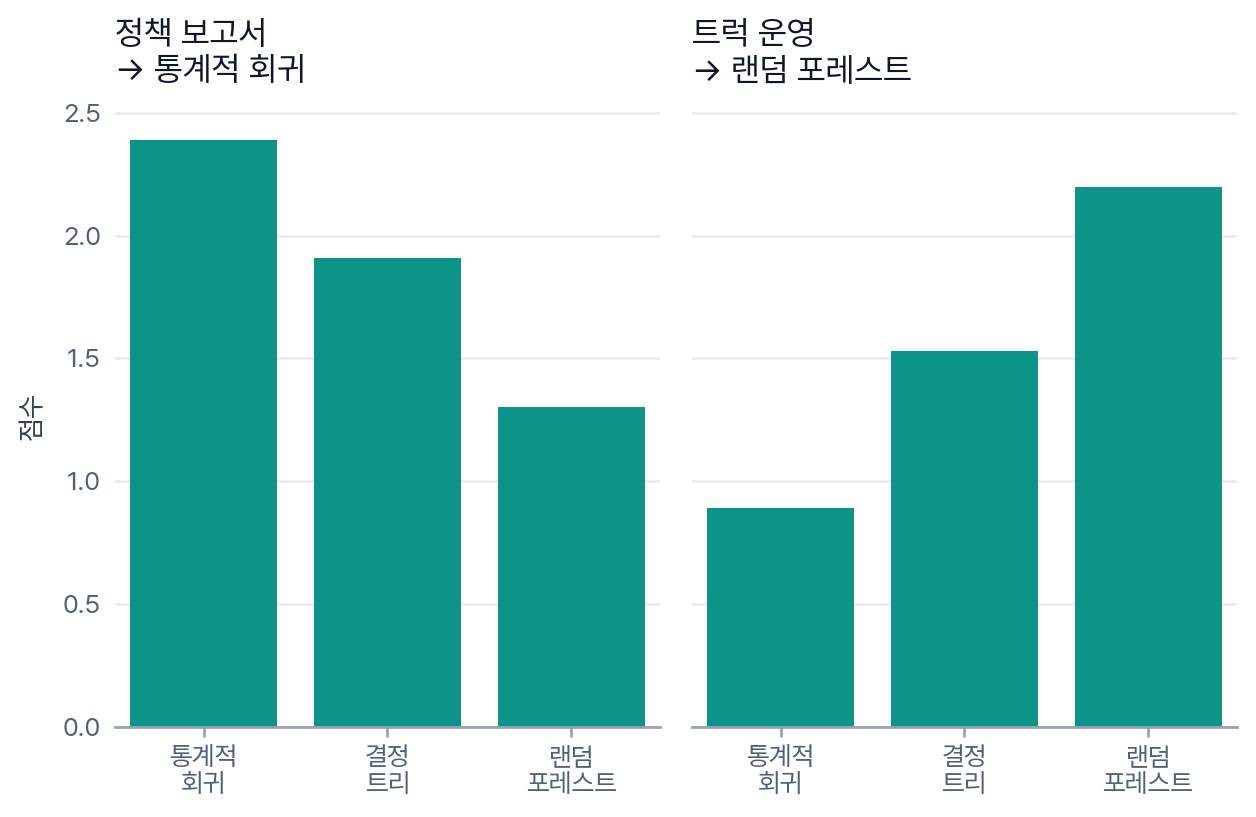
네 자의 점수를 그대로 더하면 모두에게 같은 답이 나옵니다. 그런데 의뢰인마다 중요한 자가 다릅니다. 그래서 자마다 무게를 매겨 곱한 뒤 더합니다 — ㉮ 는 설명에 0.7, ㉯ 는 성능에 0.7. 같은 표에서 ㉮ 는 회귀 2.39점, ㉯ 는 숲 2.20점이 1등이 됩니다. 무게를 정한 것은 표가 아니라 사람입니다.

㉯ 차고 · 그날 가장 가까웠던 날(시험 89일)
24랜덤 포레스트 — RMSE 1등
인데
33결정 트리

RMSE 1등이 이 잣대에서는 꼴찌 — 잣대가 등수를 만든다.

같은 통계적 회귀 · 방만 바뀌면
2.39㉮ 정책실 점수
→
0.89㉯ 차고 점수

방법은 그대로인데 점수가 바뀐다 — 무게가 곧 판단이다.

통계적 회귀 · 첫 학습과 두 번째 학습
19.9첫 fit(ms)
→
8.9두 번째 fit(ms)

첫 번에는 도구 준비가 섞인다 — 효율은 두 번째로 잰다.

㉰ 대책반 · 36.7°C 에 돌아온 답
21,742결정 트리(대)
vs
34,498통계적 회귀(대)

같은 기온을 물었는데 회귀만 3만 대를 넘는다 — 답이 아니라 가정이 갈린 것.

자료: 따릉이 353일 · 훈련 264일 / 시험 89일 — 위 네 쌍의 숫자는 모두 코드 ① · ③ · ④가 찍는 값이다.

2-3범위 밖에서는 방법이 아니라 가정이 답한다

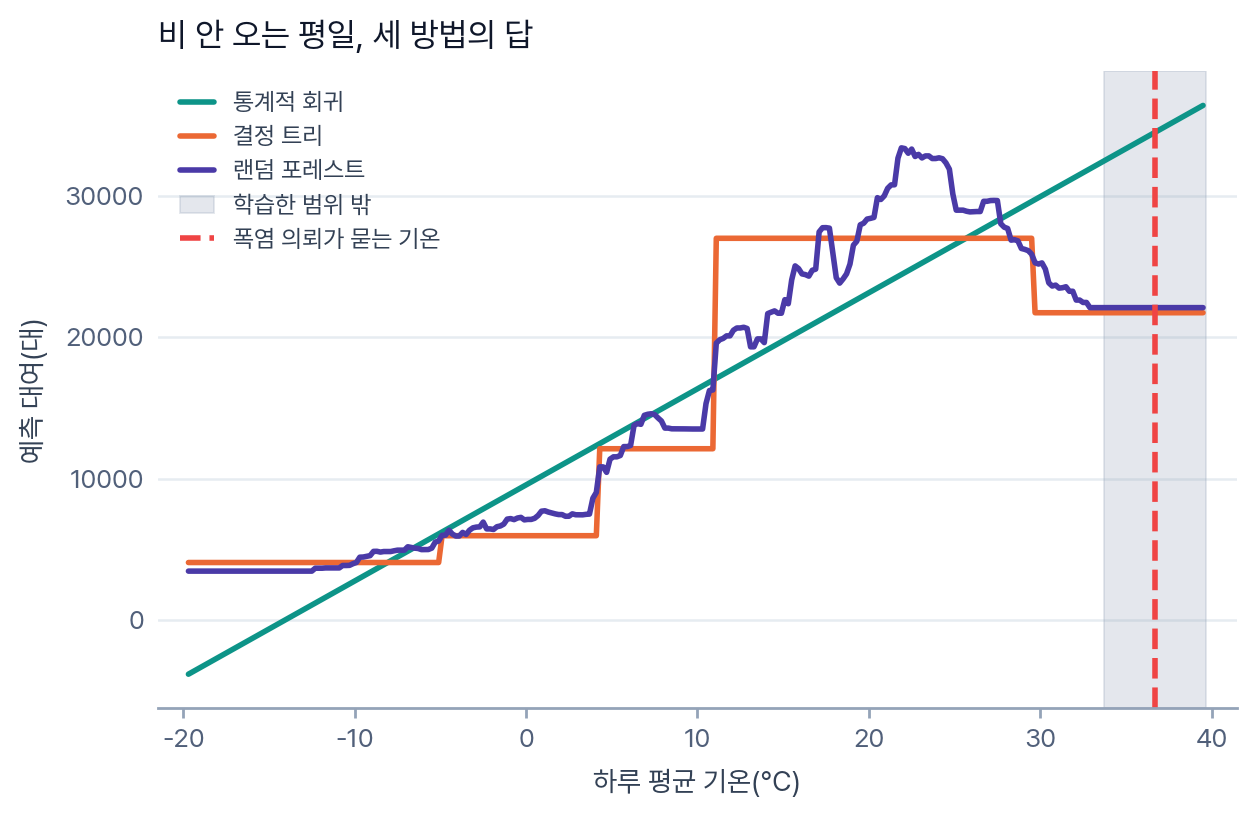
㉰ 가 묻는 36.7°C 는 훈련 자료에 단 하루도 없습니다. 그런데 세 방법 모두 숫자를 내놓았어요. 어떻게 냈을까요? 직선은 배운 기울기를 그대로 늘였고, 나무와 숲은 가장 더운 칸의 값을 그대로 냈습니다. 방법마다 다른 가정으로 빈 곳을 메운 것이지, 그 기온을 본 적이 있어서가 아닙니다.

그러니 세 숫자를 견주어 1등을 뽑는 일은 뜻이 없습니다. 견줄 것은 숫자가 아니라 가정이고, 가정을 고르는 근거는 이 자료 안에 없습니다. 이럴 때 가장 적합한 '방법'은 더 더운 날이 담긴 다른 자료를 구하거나, 범위를 밝히고 판단을 미루는 것입니다.

그림 1묻는 자리에는 배운 날이 없다왼쪽 = 36.7°C 의 세 답 · 오른쪽 = 훈련이 실제로 본 기온
010,00020,00030,00040,00034,498통계적회귀21,742결정트리22,103랜덤포레스트㉰ 가 묻는 36.7°C — 세 방법의 답훈련 264일 가운데 36.7°C 이상인 날 0일청록 띠 = 실제로 관측된 값32.5°C 이상 맑은 평일 4일 · 20,693~22,897대 훈련이 실제로 본 기온배운 기온 −14.7 ~ 33.7°C · 그 밖은 아무 날도 없다배운 기온 264일범위 밖36.7°C㉰ 가 묻는 자리-20-10010203040하루 평균 기온(°C)훈련 264일을 한 줄로 세우면31.7°C 아래 260일31.7°C 이상 4일36.7°C 이상 0일 010,00020,00030,00040,00034,498통계적회귀21,742결정트리22,103랜덤포레스트㉰ 가 묻는 36.7°C — 세 방법의 답훈련 264일 가운데 36.7°C 이상인 날 0일청록 띠 = 실제로 관측된 값32.5°C 이상 맑은 평일 4일 · 20,693~22,897대 훈련이 실제로 본 기온배운 기온 −14.7 ~ 33.7°C · 그 밖은 아무 날도 없다배운 기온 264일범위 밖36.7°C㉰ 가 묻는 자리-20-10010203040하루 평균 기온(°C)훈련 264일을 한 줄로 세우면31.7°C 아래 260일31.7°C 이상 4일36.7°C 이상 0일

회귀만 청록 띠를 훌쩍 넘습니다. 그렇다고 트리·숲이 맞다는 뜻은 아닙니다 — 둘은 가장 더운 칸의 값을 그대로 냈을 뿐이고, 그 값이 우연히 관측 띠 안에 떨어진 것입니다. 자료: 따릉이 353일 · 관측 띠는 32.5°C 이상 맑은 평일 4일(20,693~22,897대) — 원장 계산

규칙물음이 훈련 자료의 범위 밖에 서면, 숫자를 내기 전에 그 조건의 날이 훈련에 며칠 있었는지부터 센다. 0일이면 '답할 수 없다'가 답이다.

Ⅲ-5 에서 가져옴통계 모델의 직선과 기계학습 모델의 계단은 관측 범위 밖을 서로 다른 가정으로 메웁니다. 오늘은 그 두 가정에 나무 100그루의 평균이 하나 더 붙었을 뿐입니다.

2-4파견 데스크 — 세 방에 직접 보내 본다

표를 읽는 것만으로는 부족합니다. 8분 동안 여러분이 데스크에 앉습니다 — 분석가 카드를 골라 의뢰인의 방으로 파견하고, 까닭 칩으로 예측을 잠근 뒤, 그 방이 써 보낸 계산서를 받습니다. 계산서란 그 방의 의뢰인이 자기 잣대로 매긴 청구서예요. ★ 를 세 방에서 다 받으면 오늘의 일이 끝납니다.

시뮬레이터

파견 데스크

분석가를 의뢰인의 방으로 보내면, 그 방이 자기 잣대로 계산서를 써서 돌려준다

  1. 1분석가 카드를 고르고 의뢰인 문을 고른다
  2. 2까닭 칩을 눌러 파견을 잠근다 — 예측이 여기서 잠긴다
  3. 3계산서를 펴고 방 안의 손잡이를 돌려 본다
의뢰인 문
보낼 분석가 카드
까닭 칩 — 고르면 파견이 잠긴다
데스크 · 아직 아무도 보내지 않았다카드를 고르고 문을 고른 뒤 까닭 칩으로 잠근다

★ 조건 — ㉮ 는 문장을 낼 수 있는 카드에 까닭 칩 '설명' · ㉯ 는 새벽 300초 안에 드는 카드 가운데 지금 잣대의 1등에 '성능'(아무도 안 떨어졌을 때) 또는 '효율'(규모 때문에 떨어진 카드가 있을 때) · ㉰ 는 거절 카드에 '적용 범위'.

계산서 = 그 방의 의뢰인이 자기 잣대로 매긴 청구서. 커튼 = 어느 날짜까지만 자료를 보여 주고 그 뒤를 가리는 것. 되돌아온 파견은 청구가 0이고, 카드를 바꿔 다시 보낼 수 있다.

받은 ★0/ 3
지금 방㉮
보낸 카드—
이 방의 잣대설명
이 방의 1등—
되돌아온 파견0
도전 1

㉯ 차고에서 '덜 틀리게'의 뜻을 세 잣대로 모두 바꿔 계산서를 열어라 — 1등이 그대로인가?

도전 2

㉮ 정책실에 통계적 회귀를 보내고 비 2 · 10 · 40mm 세 자리를 모두 열어, 받은 문장이 1년 기록과 가장 크게 벌어지는 자리를 찾아라.

도전 3

㉰ 대책반의 커튼 두 날짜를 모두 열어 본 뒤, 이 방에서 ★ 를 받는 카드를 보내라.

자료: 쪽 안 JSON(#desk-data) — 서울 따릉이 353일을 브라우저 Pyodide 로 돌려 구운 값(원장 _ledger/u3/run/l14). 3정거장의 코드 ① · ④ · ⑤ · ⑥이 같은 숫자를 찍는다.

정리 앞 3분 — 선생님이 같은 판에서 커튼 성적표를 엽니다. 금요일마다 커튼을 치고 그 뒤 45일의 '범위 밖 1등'을 세어 둔 판이에요. 먼저 짐작해 두세요: 6월 1일 전 금요일 19곳 가운데 통계적 회귀가 1등인 칸은 몇 개일까요?

체크포인트 2

네 가지 자와 무게를 손에 넣었고, 세 방에 직접 파견해 보며 '1등은 방마다 다르다'와 '거절도 답이다'를 확인했다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

비교표를 직접 만들고, 세 의뢰에 답장한다

오늘의 장비

랜덤 포레스트 — 나무 100그루의 평균

5차시에서 예고만 했던 방법입니다. 결정 트리 한 그루 대신, 자료와 갈림을 조금씩 달리한 나무를 100그루 길러 그 답을 평균 냅니다. 처음 실행은 몇 초 멈춰요 — 고장이 아니라 scikit-learn 과 그림 도구를 그 칸에서 처음 준비하는 중입니다(쪽마다 한 번).

부르는 모양

from sklearn.ensemble import (
    RandomForestRegressor)

숲 = RandomForestRegressor(
    n_estimators=100,
    min_samples_leaf=3,
    random_state=0)
# 트리·회귀와 부르는 법이 같다
숲.fit(훈[열], 훈["rentals"])
숲.predict(시[열])

오늘 쓰는 함수 넷

fit
배운다 — 셋 다 이름이 같다
predict
답한다 — 셋 다 이름이 같다
export_text
트리의 갈림을 글자로 뽑는다
mean_squared_error
제곱 오차의 평균 — 제곱근이 RMSE

트리 한 그루와 다른 셋

  1. 그루가 100n_estimators=100 — 100개의 답을 평균
  2. 그루마다 다르게자료도 갈림도 조금씩 달리 뽑아 기른다
  3. 문장이 안 나온다export_text 를 100번 읽을 수는 없다

대가 — 학습이 40~50배 느려지고(8.9ms → 398.3ms), '비 1mm 당 몇 대'라는 문장을 주지 않습니다.

1

세 방법을 같은 시험으로 돌려 비교표를 받는다

4분

RMSE 1등은 어느 방법일까요? 그리고 학습 시간은 가장 빠른 것과 가장 느린 것 사이에 몇 배쯤 벌어질까요 — 2배 · 10배 · 50배 가운데 하나를 골라 두세요. 표를 받은 뒤 짐작과 맞대어 봅니다.

기본 빈칸 ①에 시간 순서 시험의 RMSE 를 채웁니다 — 12차시에서 쓰던 자예요. mean_squared_error 는 제곱한 오차의 평균이므로, 대여 대수와 같은 단위로 읽으려면 제곱근을 한 번 더 취합니다.

도전 max_depth 를 3 → 6 으로 바꿔 다시 돌려 보세요. 갈림이 늘면 트리의 RMSE 와 36.7°C 의 답이 어떻게 움직이나요? 바꾸기 전과 뒤의 두 숫자를 적어 두세요.

탐구 첫 fit 시간(19.9 · 10.4 · 433.1ms)을 효율 점수에 쓰면 어느 방법이 억울해지는지와 그 까닭을 한 줄로 적으세요.

㉮ 에 낼 수 있는 문장은 와 두 가지다. 랜덤 포레스트가 문장을 못 내는 까닭은 이고, 그래서 ㉮ 의 점수에서 숲은 가 된다.

확인 문제 2에 ㉮ 답장을 적어 제출 →
2

㉰ 가 묻는 기온이 데이터 안에 있는지 센다

3분

36.7°C 는 훈련 자료에 없는 기온입니다. 그런데도 세 방법은 숫자를 냅니다 — 세 답이 비슷할까요, 갈릴까요? 갈린다면 누가 가장 큰 값을 낼 것 같은지 짐작해 두세요.

기본 빈칸 ②에 기온이 (폭염기온 − 5)°C 이상인 훈련 날 수를 세는 한 줄을 채웁니다. 훈["temp"] >= 폭염기온 - 5 는 참·거짓 목록이고, 참을 세려면 .sum() 을 씁니다. 그림에서 회색 띠는 학습한 범위 밖, 빨간 점선은 ㉰ 가 묻는 기온이에요.

도전 촘촘 의 rain_mm 을 0.0 에서 20.0 으로 바꿔 다시 그려 보세요. 세 줄이 각각 어떻게 움직이나요? 내려간 폭이 셋 다 같은지를 보고 한 줄로 적으세요.

36.7°C 에서 직선은 를 그대로 늘였고, 나무와 숲은 을 그대로 냈다. 세 숫자가 다른 까닭은 방법이 달라서가 아니라 가 달라서다.

확인 문제 3에 ㉰ 답장을 적어 제출 →
3

무게를 매겨 점수를 내고, 무게를 우리 것으로 바꾼다

5분

표 2의 성능 1등은 랜덤 포레스트였습니다. 그 방법이 ㉮ 정책실에서도 1등일까요? 아니라면 몇 등이 될지 짐작해 두세요.

기본 코드 ③은 채워져 있습니다. 그대로 ▶ 실행해 두 칸 막대를 보세요. 성능·효율은 표 2의 숫자를 0~3점으로 고친 것이고, 설명은 사람이 매긴 점수입니다(회귀 3 · 트리 2 · 숲 1). 그다음 무게 를 우리 모둠 값으로 고쳐 다시 돌립니다 — 세 수의 합이 1이 되게 하세요.

도전 설명 의 결정 트리를 2 → 3 으로 바꾸면 ㉮ 가 회귀 2.39 대 트리 2.61 로 뒤집힙니다. 그렇게 고쳐도 되는 근거를 코드 ⑤의 계산서에서 찾아 한 줄로 적으세요.

탐구 무게를 모둠 값으로 고친 까닭을 한 줄로 적고, 옆 모둠의 무게·결과와 견주어 보세요 — 다른 답이 나왔다면 무엇이 달랐던 것인지까지 적습니다.

같은 표를 보고도 두 모둠이 다른 방법을 고를 수 있다. 갈린 곳은 이고, 그래서 보고서에는 고른 방법과 함께 를 반드시 적는다.

확인 문제 4에 적어 제출 →
4

세 계산서를 열어 근거를 모으고, 의뢰서에 답장한다

8분

시뮬레이터에서 받은 계산서를 이제 코드로 다시 확인합니다. 세 방의 1등이 같을까요, 다를까요? 다르다면 어느 방에서 가장 크게 갈릴 것 같은지 적어 두세요.

기본 세 칸은 채워져 있습니다. 칸마다 ▶ 한 번씩 눌러 ㉯ · ㉮ · ㉰ 의 계산서를 숫자로 받은 뒤, 답장 두 장(㉮ · ㉰)과 확인 문제 1(㉯)에 쓸 근거를 고르세요.

도전 문턱을 10000 에서 8000 으로 내려 세면 회귀와 숲이 19일로 같아집니다. '큰 실수'의 문턱을 누가 정해야 하는지 한 줄로 적으세요.

탐구 대여소 2,810곳마다 모델을 하나씩 만든다면 — 코드 ①의 학습 ms × 2,810 이 새벽 5분(300초) 안에 드는 방법은 무엇인가요?

도전 짝을 찾는 조건 ±2°C 를 ±1°C 로 좁히면 짝 없는 비 온 날이 몇 날 생기나요? 짝이 줄면 이 비교를 얼마나 믿을 수 있을지도 한 줄 덧붙이세요.

탐구 ㉮ 정책실에 '비가 10mm 오면 몇 대 줄까'를 한 문장으로 답하고, 그 문장을 어느 방법에서 가져왔는지와 까닭을 적으세요(확인 문제 2의 답 칸에 함께 씁니다).

도전 커튼 날짜를 다른 금요일로 바꿔 돌리고, 그때마다 '범위 밖 1등'을 적어 두세요. 선생님이 여는 커튼 성적표와 맞대어 봅니다.

탐구 '숲이 범위 밖에 강하다'가 왜 틀린 외움인지, 두 커튼의 숫자를 근거로 적으세요.

㉯ 에는 를 권한다 — 근거는 이고, 한계는 이다. ㉰ 에는 를 보낸다 — 이 자료로 말할 수 있는 것은 뿐이기 때문이다.

확인 문제 1에 ㉯ 답장을 적어 제출 →

㉮ 답장은 확인 문제 2, ㉰ 답장은 확인 문제 3에 이어 씁니다 — 세 장이 오늘의 본 과제입니다.

체크포인트 3

비교표를 직접 만들었고, 무게를 바꿔 1등이 뒤집히는 것을 보았고, 세 계산서에서 답장의 근거를 골랐다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

정리에 앞서 3분, 선생님이 파견 데스크의 커튼 성적표를 엽니다 — 금요일마다 커튼을 치고 그 뒤 45일의 '범위 밖 1등'을 세어 둔 판입니다. 6월 1일 전 금요일 19곳에서는 통계적 회귀가 14곳에서 1등이었는데, 뒤 9곳에서는 한 곳도 1등이 아니었습니다. 방법이 여름에 갑자기 나빠진 것이 아닙니다 — 커튼 뒤에 놓인 날들이 달라졌을 뿐이에요. 범위 밖의 1등은 방법의 성질이 아닙니다.

  1. 찾은 것

    같은 비교표 한 장인데 방마다 1등이 달랐다 — ㉮ 는 회귀(2.39점), ㉯ 는 숲(2.20점), ㉰ 는 거절.

  2. 도구의 한계

    세 방법이 fit·predict 두 함수를 똑같이 쓰는 덕에 바꿔 끼우는 값은 싸졌다. 그러나 도구는 무엇으로 고를지를 주지 않는다.

  3. 보고의 규칙

    고른 방법과 함께 잣대 · 무게 · 한계를 적는다. 훈련에 그 조건의 날이 0일이면 '답할 수 없다'고 적는 것이 답이다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. ㉯ 재배치 차고 팀장에게 답장한다. 비교표에서 랜덤 포레스트가 RMSE 1등(5,833), 학습 시간 꼴찌(398.3ms)였다. 매일 아침 5분 안에 예측을 받아야 한다면 이 학습 시간이 문제가 되는가? 권하는 방법과 근거, 그리고 그 방법의 한계를 한 줄씩 쓰시오.
📖 모범 답안

모델을 하나만 만든다면 문제가 되지 않는다. 353일 규모에서는 숲도 한 번 학습이 398.3ms(다른 실행에서는 217.7ms)라 0.2~0.4초면 끝난다. 성능이 가장 중요한 ㉯ 에는 랜덤 포레스트를 권한다(㉯ 점수 2.20 · RMSE 5,833).

효율이 결정적이 되는 것은 규모가 커질 때다. 대여소 2,810곳마다 모델을 만들면 숲은 612~1,119초로 새벽 5분(300초)을 넘고, 회귀·트리는 15~25초에 끝난다. 효율은 규모와 함께 판단하고, 시간은 도구 준비가 빠진 두 번째 fit 으로 잰다 — 첫 번의 몇 초를 숲의 탓으로 돌리지 않는다.

한계 — 그 전에 '덜 틀리게'의 뜻을 팀장에게 확인해야 한다. RMSE 로 재면 숲(5,833)이지만, '그날 가장 가까웠던 날'로 재면 트리(33일)가 1등이고 숲은 24일로 꼴찌다. '1만 대 넘게 빗나간 날'로 재면 다시 숲(4일)이다 — 같은 89일인데 잣대가 등수를 바꾼다.

2. ㉮ 시청 정책실에 답장한다. 팀 안에서 "성능이 가장 좋으니 랜덤 포레스트를 쓰자"는 의견이 나왔다. 반대 근거와 절충안을 쓰고, '비가 10mm 오면 몇 대 줄까'를 보고서에 실을 한 문장으로 적은 뒤 그 문장을 어느 방법에서 가져왔는지와 까닭을 쓰시오.
📖 모범 답안

반대 근거 — 숲은 '비 1mm 당 몇 대'라는 문장을 주지 않는다. 나무 100그루의 평균이라 export_text 로 읽을 갈림이 없다. ㉮ 의 점수도 회귀 2.39 · 트리 1.91 · 숲 1.30 으로 숲이 꼴찌다.

절충안 — 보고서 문장은 회귀(또는 트리)로 쓰고, 숲의 예측으로 그 문장이 크게 틀리는 조건을 함께 밝힌다.

한 문장(예) — “20°C 평일 기준, 비가 10mm 오면 대여가 약 1만 대 줄어든다(기온·요일이 같을 때).” 이 문장은 결정 트리에서 가져왔다. 회귀 문장은 10mm 를 −2,846대라 하지만 1년 기록의 짝 비교(7~15mm · 12일)는 −11,181대이고, 트리의 −9,954대가 그 기록과 1.12배로 가장 가깝다. 회귀는 2mm 에서 −569대 대 −4,235대(16일)로 7.4배나 작게 말한다.

이 근거로 설명 점수의 트리를 2 → 3 으로 올리면 ㉮ 의 1등이 회귀 2.39 대 트리 2.61 로 뒤집힌다. ‘㉮ = 회귀’는 정답이 아니라 무게와 점수에 대한 판단이었다는 뜻이다 — 그래서 보고서에는 점수와 함께 그 판단의 근거를 적는다.

3. ㉰ 폭염 대책반에 답장한다. 36.7°C 에 대해 직선은 34,498대, 트리는 21,742대, 숲은 22,103대라고 답했다. 아래 표에 데이터로 답할 수 있는지와 근거 숫자를 채우고, 그 아래에 답장을 쓰시오.
물음데이터로 답할 수 있나근거가 되는 숫자
30°C 위 맑은 평일의 대여는 그 아래 구간보다 많은가?
36.7°C 의 대여는 몇 대인가?
36.7°C 에 대비하려면 무엇을 해야 하나?
📖 모범 답안

표 — ① 답할 수 있다: 트리의 갈림에서 11°C 위·비 7mm 아래 구간은 30°C 아래가 27,006대, 30°C 위가 21,742대로 오히려 줄었다. ② 답할 수 없다: 훈련 264일 가운데 36.7°C 이상인 날은 0일이고 31.7°C 이상도 4일뿐이다. ③ 부분만: 관측된 32.5°C 이상 맑은 평일 4일의 실제 대여는 20,693~22,897대였다 — 이것은 사실이지만 3°C 더 더운 날의 값은 아니다.

답장(예) — 세 숫자 가운데 어느 것도 믿을 근거가 없습니다. 그 기온의 날이 자료에 하루도 없기 때문입니다. 직선은 배운 기울기를 그대로 늘여 34,498대를 냈고, 나무와 숲은 가장 더운 칸의 값(21,742 · 22,103대)을 그대로 냈습니다 — 셋은 서로 다른 가정이지 서로 다른 답이 아닙니다.

대신 할 일 — ① 더 더운 날이 담긴 다른 해·다른 도시 자료를 구한다 ② 관측 범위(−14.7~33.7°C)를 밝히고 “이 범위 안에서는 30°C 를 넘으면 오히려 줄었다”까지만 보고한다 ③ 한 숫자 대신 범위로 제시하고 가정을 함께 적는다.

왜 숲을 믿으면 안 되나 — 2018년 7월 20일까지의 자료로 같은 일을 해 보면 세 방법 모두 그 뒤 범위 밖 28일을 많게 불렀다(+13,194 · +7,308 · +5,006대). 그때는 숲이 가장 덜 틀렸지만, 커튼을 3월 9일로 옮기면 셋 다 적게 부르고 (−7,851 · −9,403 · −9,467대) 1등도 바뀐다. 금요일 커튼 28곳에서도 6월 1일 전에는 회귀가 14번 1등, 뒤로는 0번이었다 — 범위 밖 1등은 방법의 성질이 아니라 그때 커튼 뒤에 무엇이 있었느냐다.

4. 같은 비교표로 두 모둠이 서로 다른 방법을 골랐다. 둘 중 하나가 틀렸다고 해야 하는가? 그렇게 판단한 까닭과, 보고서에 무엇을 함께 적어야 하는지 쓰시오.
📖 모범 답안

아니다. 가중치(무엇을 중시하나)가 다르면 같은 표에서도 다른 방법이 뽑힌다. 실제로 무게 (0.2 · 0.1 · 0.7)인 ㉮ 에서는 회귀가 2.39점으로 1등이고, (0.7 · 0.2 · 0.1)인 ㉯ 에서는 숲이 2.20점으로 1등이다 — 표는 한 장인데 1등이 둘이다.

각자 가중치와 근거를 밝히면 둘 다 합리적일 수 있다. 다만 같은 의뢰에서 갈렸다면 의뢰인의 목적을 다시 확인해 가중치를 맞춘다. 설명 점수(회귀 3 · 트리 2 · 숲 1)처럼 사람이 매긴 점수가 섞여 있다면 그 근거도 함께 밝힌다 — 근거가 바뀌면 등수도 바뀐다(트리를 2 → 3 으로 고치면 ㉮ 는 2.61로 트리가 1등).

보고서에 함께 적을 것 — ① 쓴 잣대와 그 무게 ② 무게를 그렇게 준 까닭 ③ 고른 방법의 한계. 무게를 밝히지 않은 보고서에는 '고른 방법'만 남고 '고른 까닭'이 사라진다.

5. Ⅳ단원 프로젝트에서 어느 모둠이 "우리 학교 매점 판매량을 예측하겠다"고 한다. 방법을 고르기 전에 확인할 것 세 가지를 오늘의 네 가지 자와 이어서 쓰시오.
📖 모범 답안

① 목적이 설명인가 예측인가 — 매점 운영자에게 '무엇 때문에 늘었나'를 말해야 한다면 설명(회귀·트리), '내일 몇 개를 들여놓을까'라면 성능(숲도 후보)이다. 자와 방법이 함께 달라진다.

② 데이터가 시간으로 이어지는가 — 날짜별 판매라면 섞어서 나누면 안 된다. 앞 기간으로 배우고 뒤 기간을 맞히는 시간 순서 시험으로 평가한다(오늘의 264일 / 89일처럼).

③ 예측하려는 조건이 데이터 범위 안인가 — 시험 기간·방학·축제처럼 훈련에 없던 날을 물으면 오늘의 ㉰ 와 같은 자리에 선다. 그런 날이 훈련에 며칠 있었는지 먼저 세고, 0일이면 '답할 수 없다'를 답으로 적는다.

덧붙여 효율은 규모와 함께 본다 — 모델 하나면 몇 밀리초 차이는 문제가 아니지만, 품목마다 모델을 만든다면 달라진다.

+
더 알아보기

목적이 방법을 고른 이야기 셋

다섯 항목 · 0~2점태어난 지 1분 · 5분0점1점2점피부색맥박반사근육 긴장호흡0510다섯 항목을 더하면 0~10점 — 종이 한 장, 셈 한 번더 정밀한 방법이 있어도 분만실이 고른 것은 이 잣대였다
역사

30초 안에 쓰이는 모델

1952년, 마취과 의사 버지니아 아프가는 갓 태어난 아기의 상태를 재는 아주 간단한 점수표를 만들었습니다. 피부색 · 맥박 · 자극에 대한 반사 · 근육 긴장 · 호흡, 다섯 가지에 0 · 1 · 2점씩을 매겨 더하면 0~10점. 태어난 지 1분과 5분에 두 번 잽니다.

더 정밀한 검사는 그때도 있었습니다. 그런데 분만실에서 필요한 것은 정밀함이 아니라 누구나 몇 초 만에 셈하고, 옆 사람에게 말로 그대로 전할 수 있는 잣대였어요. 간호사와 의사가 같은 칸을 보고 같은 숫자를 말할 수 있어야 하고, 그 숫자가 바로 다음 처치로 이어져야 했습니다. 그 목적이 이 단순한 방법을 70년 넘게 살렸습니다 — 오늘 ㉮ 정책실이 '가장 잘 맞히는 방법' 대신 문장을 낼 수 있는 방법을 고른 것과 같은 이야기입니다.

도해: 다섯 항목 × 0~2점의 빈 점수표와 합계 0~10점 눈금을 그렸다. 실제 아기의 값은 넣지 않았다.

구멍은 둘, 안은 셋for 이름, m in 후보.items(): m.fit(…) → m.predict(…)통계적 회귀직선 하나fitpredict결정 트리예·아니오 갈림 셋fitpredict랜덤 포레스트나무 100그루의 평균fitpredict한 반복문바꿔 끼우는 값은 싸졌다 — 무엇을 고를지는 여전히 사람이 정한다
방법 더 깊이

구멍은 둘, 안은 셋 — 바꿔 끼우기가 싸진 까닭

오늘 코드에서 세 방법은 후보 라는 딕셔너리에 담겨 한 반복문으로 돌았습니다. 직선을 긋는 일, 갈림을 만드는 일, 나무 100그루를 기르는 일 — 속은 전혀 다른데도 바깥에 난 구멍은 fit(X, y) 와 predict(X) 둘뿐이라 그렇습니다.

scikit-learn 은 이 두 함수의 이름과 인자 모양을 모든 방법에 똑같이 맞추기로 정했습니다. 그래서 방법을 바꿔 보는 일이 한 줄 고치기가 되었고, 비교표를 만드는 값이 싸졌습니다. 값이 싸졌다는 것은 좋은 소식이지만 함정도 됩니다 — 바꿔 끼우기가 쉬우니 열 가지를 돌려 보고 가장 좋은 점수를 고르는 유혹이 생기지요. 그렇게 고른 점수는 그 시험에만 맞춰진 값입니다. 도구가 낮춰 준 것은 바꿔 보는 값이지 고르는 값이 아닙니다.

도해: 세 방법 상자가 같은 두 구멍(fit · predict)을 갖고 한 반복문에 꽂히는 모습. 상자 안의 설명은 오늘 쓴 설정 그대로다.

관측 밖에서는 무엇이 답하나자료 모델은 본 것만 말한다 · 물리 모델은 보지 못한 조건도 계산한다관측한 범위관측 밖자료 모델시나리오 · 높은 배출시나리오 · 가운데시나리오 · 낮은 배출㉰ 의 물음이 서는 자리 — 곡선이 끊긴 쪽여기서 나오는 숫자는 '답'이 아니라 '가정'이다. 그래서 하나가 아니라여러 갈래로 내놓고, 어느 가정 위의 값인지 함께 적는다.
현장

관측 밖을 묻는 질문들

㉰ 의 물음은 특별한 물음이 아닙니다. 기후가 바뀌면서 과거에 없던 조건을 다뤄야 하는 일이 늘었어요. 지금까지 겪어 본 적 없는 더위, 겪어 본 적 없는 강수. 과거 자료에서 규칙을 배우는 방법은 그 자리에서 배운 규칙을 연장할 뿐입니다 — 오늘 직선이 기울기를 늘이고 나무가 마지막 칸을 되풀이한 것처럼요.

그래서 이런 물음에는 자료 모델 대신 물리 모델을 씁니다. 공기와 물이 열을 주고받는 법칙을 식으로 세워 계산하면, 관측한 적 없는 조건도 계산 안으로 들어옵니다. 다만 그 계산에는 '앞으로 온실가스를 얼마나 내보낼까' 같은 가정이 필요하지요. 그래서 결과를 하나로 내놓지 않고 시나리오 여럿으로 내놓고, 어느 가정 위의 값인지를 반드시 함께 적습니다. 숫자 하나를 답으로 내미는 대신 가정을 드러내는 것 — 오늘 ㉰ 에게 쓴 답장과 같은 태도입니다.

도해: 관측한 범위에서 끊기는 자료 모델의 곡선과, 그 뒤로 부채처럼 갈라지는 시나리오 세 갈래. 갈래의 자리는 모양을 보인 예시다.