단원 홈

Ⅲ. 데이터 모델링과 평가13차시

정답지가 없는 분석은
어떻게 채점할까

정답 대신 쓰는 세 가지 자

12차시의 회귀 모델은 맞혀 볼 실제값이 있어서 시험 오차로 채점했습니다. 그런데 7·8차시에서 지하철 239역을 무리로 나눌 때는 맞혀 볼 정답이 없었어요. 그러면 "이 무리 나눔은 믿을 만하다"는 무엇으로 말할까요?

  • [12데과03-05]
  • 50분네 정거장
  • 새 도구계층적 군집 · 일치 지수
  • 자료지하철 239역 · 송장 4,000장
Ⅲ 단원 지도13 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    정답이 없는 분석을 채점하는 세 가지 자 — 내부 자 · 일치 · 외부 자 — 를 구별해 말할 수 있다.

  2. 손으로

    같은 표를 두 방법으로 나눠 엇갈려 센 표 · 짝 판정 · 일치 지수(ARI)로 견줄 수 있다.

  3. 확인에서

    흔들리는 결과의 까닭을 근거 숫자 하나로 기각하거나 유지해 적을 수 있다.

1
여는 장면 · 5분

두 사람이 같은 239역을 나눴다

7차시에서 우리는 서울 지하철 239역의 하루 승하차 구성비를 k-평균으로 네 무리로 나눴고, 8차시에서 그 무리에 혼합 · 업무 · 주거 · 번화·대학가라는 이름을 붙였습니다.

그런데 같은 표를 받은 다른 분석가가 다른 방법을 썼다고 해 봅시다. 가까운 둘을 하나씩 합쳐 올라가는 계층적 군집입니다. 두 사람의 결과를 나란히 놓으면 어떤 역은 두 사람이 같은 무리에 넣었고, 어떤 역은 갈립니다.

Ⅲ-12 에서 가져옴회귀 모델은 맞혀 볼 실제값이 있어서 시험 자료의 오차로 채점했습니다. 군집에는 그 실제값이 없습니다 — 채점지가 통째로 비어 있어요.

지역 · 가상 기사

"서울 지하철 239역은 네 유형으로 나뉜다" — 두 연구진이 같은 결론

같은 자료 · 다른 방법 · 이 기사는 수업을 위해 지어낸 것입니다
그림 1같은 239역, 두 장의 나눔칸 하나가 역 하나 · 두 장의 같은 자리가 같은 역
분석가 ㄱ — k-평균칸 하나가 역 하나 · 색이 무리 · 무리끼리 모아 늘어놓았다주거 92혼합 67번화·대학가 48업무 32색 넷 = 무리 넷 — 이 장을 기준으로 다른 장을 칠했다분석가 ㄱ — k-평균칸 하나가 역 하나 · 색이 무리 · 무리끼리 모아 늘어놓았다주거 92혼합 67번화 48업무 32색 넷 = 무리 넷 — 이 장을 기준으로 다른 장을 칠했다분석가 ㄴ — 계층적 군집(Ward)같은 자리 · 같은 역 · 짝지은 무리 색으로 칠했다주거 92혼합 67번화·대학가 48업무 32■ 먹 테두리 = 두 사람이 다른 무리에 넣은 역 42곳분석가 ㄴ — 계층적 군집(Ward)같은 자리 · 같은 역 · 짝지은 무리 색으로 칠했다주거 92혼합 67번화 48업무 32■ 먹 테두리 = 두 사람이 다른 무리에 넣은 역 42곳

두 장은 거의 같아 보입니다. 그러나 먹 테두리를 두른 42곳은 두 사람이 서로 다른 무리에 넣은 역입니다. 42곳이면 많은 걸까요, 적은 걸까요? "많다 · 적다"를 말하려면 자가 있어야 합니다. 자료: 서울교통공사, 역별 일별 시간대별 승하차인원 정보(2024), 공공데이터포털(15048032), 이용허락범위 제한 없음 — 2024년 11월 평일 하루 평균으로 가공 · 무리는 원장이 돌린 k-평균과 계층적 군집(Ward)

먼저 예측

아직 자를 꺼내기 전입니다. "이 나눔은 믿을 만하다"를 무엇으로 보이겠습니까? 정답이 없으니 "몇 % 맞혔다"는 쓸 수 없어요. 여러분이 쓸 수 있는 근거를 한 문장으로 적어 두세요. 3정거장 미션 ①에서 여러분의 문장과 이 차시가 꺼내는 자를 맞대어 봅니다.

체크포인트 1

정답지가 없는 분석이 있다는 것을 보았고, 무엇으로 채점할지 내 문장을 하나 적어 두었다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

정답이 없을 때 꺼내는 세 가지 자

2-1채점지가 비어 있어도 잴 것은 있다

정답이 없다고 아무 말이나 할 수 있는 것은 아닙니다. 정답 대신 결과 자체, 다시 해도 같은가, 분석에 쓰지 않은 정보 이 셋을 자로 씁니다.

정답 없는 결과를 채점하는 나침반 — 네 방향

  1. 내부 자결과 자체의 모양이 좋은가 — 실루엣(7차시). 무리 안은 가깝고 무리 사이는 먼가
  2. 다른 방법같은 표를 다른 방법으로 나눠도 같은 무리가 나오나 — 오늘의 k-평균 vs 계층적
  3. 다른 표본자료를 반만 써도 같은 무리가 나오나 — 3차시의 '다시 뽑기'를 군집에 쓴 것
  4. 외부 자분석에 넣지 않은 정보와 맞나 — 8차시의 주말 비율

가운데 둘을 묶어 일치라고 부릅니다. 회귀에는 시험 오차 하나로 끝나던 자리가, 군집에서는 이렇게 여러 장의 성적표가 됩니다.

표 1분석마다 쓰는 자같은 틀로 연관 규칙까지 읽힌다
분석내부 자일치 — 다시 해도 같은가외부 자
회귀(12차시) 훈련 오차시험 오차 · 접은 자리를 바꿔도 같은가실제값이 곧 외부 자다
군집(7·8차시) 실루엣다른 방법 · 다른 표본으로 나눠도 같은가주말 비율처럼 넣지 않은 정보
연관 규칙(9·10차시) 지지도 · 향상도다른 기간의 송장에도 그 규칙이 나오나매장 담당자의 판단

회귀만 맞혀 볼 실제값을 가졌습니다. 나머지 둘은 실제값이 없어서 내부 자 · 일치 · 외부 자 셋을 겹쳐 읽습니다. 오늘은 가운데 칸 일치를 손으로 잽니다.

2-2두 방법이 같은 답을 냈는지 숫자 하나로

계층적 군집은 k-평균과 전혀 다르게 일합니다. 중심을 찍고 당기는 대신, 가장 가까운 둘을 하나로 합치는 일을 되풀이하다 무리가 k 개 남으면 멈춥니다. 합쳐 온 차례가 나무 모양으로 남아서 덴드로그램이라 부르는 그림이 나오지요(더 알아보기 ①). 오늘 쓰는 Ward는 "합쳤을 때 무리 안의 흩어짐이 가장 조금 늘어나는 둘"을 고르는 방식입니다.

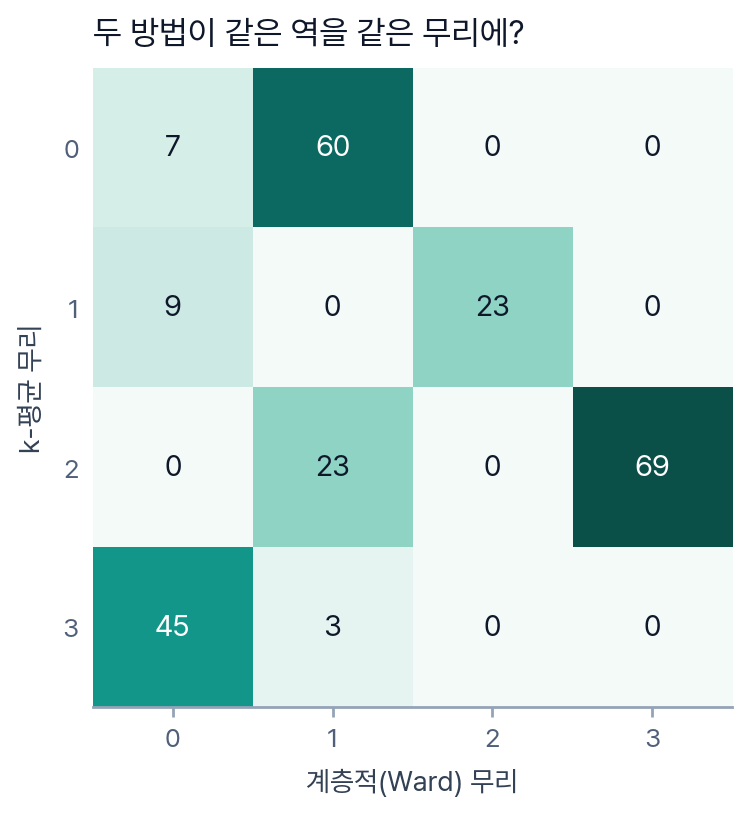
그림 2엇갈려 센 표 — 두 방법을 맞대는 첫 도구행 = k-평균 무리 · 열 = 계층적(Ward) 무리 · 칸 = 역 수
계층적(Ward) 무리 →0123혼합76000업무90230주거023069번화·대학가45300□ 먹 테두리 = 짝행에서 가장 큰 칸⌐ 주황 점선 = 갈린 칸7 + 9 + 23 + 3 = 42곳한 줄에 한 칸만 진하면 두 방법이 같은 무리를 찾은 것이다

행마다 가장 큰 칸이 짝입니다 — 혼합↔Ward 1(60), 업무↔Ward 2(23), 주거↔Ward 3(69), 번화·대학가↔Ward 0(45). 짝이 아닌 칸에 든 7 + 9 + 23 + 3 = 42곳이 그림 1의 먹 테두리입니다. 주거 92역 가운데 23곳이 Ward 에서는 혼합 쪽으로 갔다는 것이 한눈에 보입니다. 자료: 원장 실측 — 코드 ①이 찍는 표와 같은 값

표는 눈으로 읽기에는 좋지만 숫자 하나가 필요합니다. 그래야 "이 방법 쌍은 저 방법 쌍보다 더 닮았다"를 말할 수 있어요. 무리 번호는 방법마다 제멋대로 붙으니(Ward 의 0번이 k-평균의 0번일 이유가 없습니다) 번호를 직접 견줄 수는 없습니다.

그래서 짝 판정을 씁니다 — 역 두 곳을 짝지어, 두 나눔이 '같은 무리다 / 다른 무리다'를 똑같이 판정했는지 보는 것입니다. 번호가 무엇이든 상관없지요. 239역이면 짝은 28,441개입니다.

두 방법의 짝 판정이 같은 비율은 0.833이었습니다. 83%면 꽤 닮은 것 같지요? 그런데 아무렇게나 네 무리로 나눈 것과 견줘도 0.616이 나옵니다.

규칙어떤 자를 쓰든 아무렇게나 한 것과 견준 값을 함께 본다 — 그래야 그 숫자가 큰지 작은지 알 수 있다.

그래서 우연히 맞을 몫을 빼고 남은 일치만 세는 자를 씁니다. 일치 지수(ARI)입니다 — 1 이면 완전히 같고, 0 이면 아무렇게나 나눈 것과 다를 바 없다는 뜻이에요. 두 방법의 0.833 은 우연 몫을 빼면 0.588이 되고, 아무렇게나 나눈 것의 0.616 은 0.021로 주저앉습니다.

k-평균 vs 계층적 — 같은 일치를 두 자로
0.833짝 판정이 같은 비율
인데
0.588일치 지수(ARI)
0.8330.588

우연 몫을 빼면 0.245 가 사라진다 — 그만큼이 공짜였다.

아무렇게나 나눈 네 무리
0.616짝 판정이 같은 비율
인데
0.021일치 지수(ARI)
0.6160.021

ARI 는 거의 0 — 자가 제 일을 했다.

아래 판에서 직접 부풀려 보세요. 아무렇게나 나눈 무리를 잘게 쪼개기만 해도 짝 판정 일치율이 0.70 을 넘습니다. 그동안 ARI 가 어떻게 되는지가 오늘의 첫 반전입니다.

시뮬레이터

일치율 부풀리기

쪼개기만 해도 일치율은 오른다 — 그때 ARI 는 무엇을 하고 있나

  1. 1🎲 아무렇게나 나눈 네 무리의 일치율을 먼저 찍는다
  2. 2손잡이로 그 무리를 잘게 쪼개 일치율을 올린다
  3. 3우연 몫을 뺀 자(ARI)를 켜고 무엇이 남는지 본다
먼저 예측 — 🎲 아무렇게나 나눠도 몇 %나 같을까
견줄 나눔
쪼개는 손잡이 — 🎲 를 몇 무리로
k-평균 vs 계층적 군집(Ward)짝 28,441개를 한 칸씩

짝 모래판 = 짝 28,441개를 한 칸씩 늘어놓은 판(가로·세로가 역 239곳, k-평균 무리끼리 모아 놓았다) · 짝 판정 일치율 = (둘 다 같이 + 둘 다 따로) ÷ 28,441

ARI = (짝 판정 일치율 − 우연히 기대되는 일치율) ÷ (1 − 우연히 기대되는 일치율) — 아무렇게나 나눈 것이면 0 근처, 완전히 같으면 1

짝 판정 일치율0.833
둘 다 같이5,672
둘 다 따로18,008
엇갈린 짝4,761
견줄 나눔의 무리 수4
ARI—
도전 1

🎲 아무렇게나 네 무리의 짝 판정 일치율을 먼저 찍고, 실제 값을 확인하라.

도전 2

손잡이로 🎲 를 쪼개 일치율을 0.70 위로 올려라. 아무리 쪼개도 더 오르지 않는 자리가 있다 — 몇에서 멈추나?

도전 3

ARI 를 켜고 세 가지를 모두 보아라 — 계층적 군집 · 아무렇게나 네 무리 · 역마다 한 무리(239개).

자료: 원장이 구운 무리 번호 239개씩(k-평균 · 계층적 · 🎲 · 쪼갠 것 넷) — 짝 28,441개의 판정은 판이 그 번호로 그 자리에서 센다. 코드 ②가 찍는 0.833 · 0.588 · 0.616 · 0.021 과 같은 값이다.

2-3자료를 반만 써도 같은 무리가 나오나

다른 방법으로 견주는 것이 한 가지 자라면, 또 하나는 다른 표본입니다. 239역 가운데 무작위로 반(119역)만 뽑아 그 반쪽으로 무리를 나누고, 거기서 나온 중심으로 239역 전체를 다시 배정해 봅니다. 원래 나눔과 얼마나 같을까요?

3차시에서 "다른 1년이었다면 같은 답이 나왔을까"를 물었던 것과 같은 발상입니다. 표본이 조금 달라져도 같은 결론이 나와야 그 결론이 자료 한 벌의 우연이 아니지요.

다섯 번 해 보면 ARI 가 0.626 에서 0.983 까지 벌어집니다. 2회차는 바뀐 역이 2곳뿐인데 3회차는 42곳이에요. 같은 방식인데 왜 이렇게 다를까요? 자연스러운 첫 설명은 "3회차 반쪽에 어떤 유형이 덜 뽑혔겠지"입니다. 그런데 두 회차의 반쪽 구성을 나란히 놓으면 거의 똑같습니다.

규칙흔들린 결과는 흔들렸다고 적고 끝내지 않는다 — 무엇이 흔들리게 했는지까지 밝힌다.

반쪽 다시 나누기2회 vs 3회
0.9830.626
2회 바뀐 역 23회 바뀐 역 42

자료: 원장 실측 — 코드 ③의 다섯 줄 가운데 둘

반쪽에 든 무리 구성 — 2회와 3회
0.9832회 ARI · 구성 35·13·45·26
vs
0.6263회 ARI · 구성 33·14·47·25
2회3회

구성은 한두 역 차이인데 결과는 크게 갈렸다 — 범인은 구성이 아니다.

그러면 무엇이 범인일까요? 3정거장 미션 ③의 시뮬레이터 「칼자리 수사」가 용의자 셋을 놓고 300번 더 나눠 본 기록으로 하나씩 기각합니다. 먼저 손으로 다섯 줄을 찍어 보고, 판에서 수사합니다.

2-4규칙에도 '다시 해도 같은가'가 있다

같은 틀이 연관 규칙에도 그대로 걸립니다. 10차시의 송장 4,000장을 앞 6개월 · 뒤 6개월로 갈라 각각 규칙을 찾으면, 앞에서 찾은 규칙이 뒤에도 살아남는지를 셀 수 있어요. 군집의 '다른 표본'이 규칙에서는 '다른 기간'이 됩니다.

이 칸은 개념을 확인하는 곁 코드입니다(약 1분) — 「손으로」 정거장의 20분에는 들어가지 않습니다. 시간이 빠듯하면 아래 표만 읽고 넘어가도 됩니다.

앞 반기 1,632장에서 찾은 규칙 1,600개 가운데 1,556개(97%)가 뒤 반기 2,368장에서도 살아남았습니다. 안정적이라고 할 만하지요.

그런데 앞 반기에서 향상도가 가장 높던 규칙들을 따라가 보면 이야기가 달라집니다. 머핀컵(빈티지성탄) & 종이냅킨(빈티지성탄)은 앞 반기 28.71 에서 뒤 반기 8.60 으로 내려앉았어요. 사라진 것이 아니라 낮아진 것입니다.

까닭은 9차시의 '드문 것의 함정'입니다. 빈티지성탄 상품이 든 송장은 앞 반기에 1,632장 중 62장(3.8%)뿐이었는데, 뒤 반기에는 2,368장 중 313장(13.2%)이 되었습니다. 드물던 둘이 함께 나오면 향상도가 크게 뜁니다 — 흔해지자 그 값이 내려온 것이지요.

규칙규칙을 보고할 때는 언제의 규칙인지를 함께 적고, 평가도 같은 계절끼리 한다.

빈티지성탄이 든 송장앞 → 뒤
앞 반기 3.8%뒤 반기 13.2%
앞 반기 62장뒤 반기 313장

자료: 원장 실측 — 위 곁 코드가 찍는 값

앞 반기 1위 규칙의 향상도
28.71앞 반기
→
8.60뒤 반기
앞 반기뒤 반기

위 여섯이 모두 내려앉았다 — 계절 상품은 사라지지 않고 흔해진다.

✍️ 여기까지 읽고 확인 문제 6에 '그 시기의 규칙'과 '틀린 규칙'을 가르는 기준을 적어 제출 →

체크포인트 2

세 가지 자를 구별할 수 있고, 짝 판정 일치율이 왜 부풀고 ARI 가 왜 필요한지 말할 수 있다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

두 번째 방법을 불러 성적표를 채운다

오늘의 장비

계층적 군집과 일치 지수 — 두 번째 방법, 그리고 그 둘을 맞대는 자

7차시의 KMeans 옆에 AgglomerativeClustering 을 하나 더 놓습니다. 처음 실행은 몇 초 멈춥니다 — 고장이 아니라 scikit-learn 과 그림 도구를 처음 받는 중이에요(쪽마다 한 번).

부르는 모양

from sklearn.cluster import AgglomerativeClustering

계층 = AgglomerativeClustering(
        n_clusters=4, linkage="ward")
hc = 계층.fit_predict(X)

오늘 쓰는 함수 넷

AgglomerativeClustering
가까운 둘을 합쳐 올라가는 군집 — linkage="ward"
silhouette_score
내부 자 — 결과 자체의 모양(7차시)
rand_score
짝 판정이 같은 비율 — 0 ~ 1
adjusted_rand_score
우연 몫을 뺀 일치 지수(ARI)

k-평균과 다른 셋

  1. 중심이 없다합쳐 온 차례만 남는다 — 그래서 predict 가 없다
  2. 시작을 안 뽑는다random_state 가 없다 — 돌릴 때마다 같은 답
  3. 나무가 남는다k 를 바꾸려면 나무를 다른 높이에서 끊으면 된다

대가 — 역이 수만 곳이면 모든 쌍의 거리를 봐야 해서 느려집니다. 239역이라 괜찮아요.

1

두 번째 방법으로 다시 나눈다 — 같은 역을 같은 무리에?

8분

여는 장면에 적어 둔 내 문장입니다. 오늘 꺼낸 자 가운데 어느 것과 가까운가요?

두 방법이 다른 무리에 넣는 역은 239곳 중 몇 곳일까요? 숫자 하나를 먼저 짐작해 두세요.

기본 빈칸 ①에 계층적 군집을 부르는 이름을 채우고 ▶ 실행합니다. 앞의 [준비] 구간은 7차시의 구성비 표와 k-평균을 그대로 다시 만드는 부분이니 고치지 마세요.

도전 linkage="ward" 를 "average" 나 "complete" 로 바꿔 보세요. 합칠 둘을 고르는 기준이 달라지면 엇갈려 센 표가 어떻게 달라지나요? 방법을 하나 더 늘리면 '일치'는 더 믿을 만해질까요?

탐구 실루엣은 k-평균 0.324, Ward 0.281 로 k-평균이 조금 높습니다. 그렇다고 k-평균이 '더 옳은' 나눔일까요? 실루엣이 높다는 것이 무엇을 뜻하는지(7차시)로 돌아가 생각해 보세요.

두 방법이 똑같이 찾은 무리는 이므로 그 이름을 . 섞인 두 무리의 경계는 이므로 거기 선 역은 .

확인 문제 1에 적어 제출 →
2

일치를 숫자 하나로 — 손으로 센 값과 도구의 값

4분

먼저 손으로 셉니다 — 역 두 곳씩 짝지어 두 나눔의 판정이 같은 짝을 numpy 로 세지요. 그 값이 scikit-learn 의 rand_score 와 같을까요? 그리고 🎲 아무렇게나 나눈 네 무리와 견준 값은 얼마가 나올까요? 판에서 찍어 본 값을 떠올려 보세요.

기본 코드 ②는 채워져 있습니다. 그대로 ▶ 실행해 네 줄의 숫자를 확인하세요. 손으로 센 값과 rand_score 가 소수 셋째 자리까지 같은지가 첫 확인입니다.

도전 마지막 줄의 아무렇게 를 np.arange(n)(역마다 한 무리)으로 바꿔 보세요. 짝 판정 일치율은 0.718 로 오히려 더 오르는데 ARI 는 0.000 입니다. 239무리로 쪼갠 것이 네 무리보다 k-평균과 닮았을 리 없지요 — 판에서 본 부풀리기가 코드로도 나옵니다.

탐구 '둘 다 따로'인 짝이 18,008개였습니다. 무리를 넷이 아니라 둘로 나눴다면 이 숫자는 늘까요, 줄까요? 그때 짝 판정 일치율은 어느 쪽으로 움직일지 먼저 말해 보고 확인해 보세요.

짝 판정 일치율이 높게 나오는 까닭은 이다. 그래서 보고할 때는 를 앞에 쓰고 는 곁들인다.

확인 문제 2에 적어 제출 →
3

반으로 나눠 다시 — 그리고 흔들림의 범인을 찾는다

4분

역을 무작위로 반만 뽑아 다시 나눈 뒤 전체를 배정합니다. 다섯 번 해 보면 다섯 번의 일치 지수(ARI)가 모두 0.9 를 넘을까요? 넘는다 · 넘지 못한다 가운데 하나를 골라 두세요.

기본 코드 ③은 채워져 있습니다. 그대로 ▶ 실행해 다섯 줄을 적고(1분), 가장 낮은 회차와 그때의 반쪽 구성을 표시해 두세요.

도전 rng = np.random.default_rng(0) 의 0 을 다른 숫자로 바꾸면 다섯 줄이 통째로 달라집니다. 몇 번을 돌려야 '흔들린다'고 말할 수 있을까요? 아래 판의 [300번 더]가 그 답입니다.

탐구 마지막 줄의 여유(첫째와 둘째로 가까운 중심까지 거리의 차)가 가장 작은 여섯 역이 찍힙니다. 이 여섯이 흔들리는 역과 같을까요? 판의 [반쪽 알리바이]로 확인해 보세요.

다섯 줄만으로는 범인을 못 잡습니다. 판에서 용의자 셋을 놓고 300번 더 나눠 본 기록으로 하나씩 기각합니다. 판의 사건 기록부 다섯 장이 방금 코드 ③이 찍은 다섯 줄과 같은 값인지부터 맞대어 보세요.

시뮬레이터

칼자리 수사

3회차는 왜 0.626 이었나 — 범인은 반쪽 구성이 아니라 칼이 지나간 자리다

  1. 1사건 기록부에서 가장 낮은 회차를 열고 용의자를 하나 잠근다
  2. 2줄다리기 렌즈로 역을 들여다보고 카드 10장을 흔들릴 순서로 세운다
  3. 3반쪽 알리바이(300번)와 띠로 펼치기로 용의자를 기각한다
사건 기록부 — 반쪽으로 다시 나눈 다섯 회
용의자 판 — 고르면 예측이 잠긴다
원래 나눔 — 239역점 하나가 역 하나 · 7차시의 주성분 지도

흔들림 = 반쪽으로 300번 다시 나눴을 때 그 역이 원래와 다른 무리로 간 비율 · 20% 이상이면 흔들린 역으로 센다

여유 = (둘째로 가까운 중심까지 거리 − 첫째까지 거리) ÷ 첫째까지 거리 · 작을수록 두 중심이 팽팽히 당기는 매듭이다

이 회차의 ARI—
바뀐 역—곳
반쪽 구성—
300회 평균—
20% 이상 흔들린 역—
줄 세우기 순위 상관—
도전 1

용의자 (가) 어떤 유형이 덜 뽑혔다를 반쪽 알리바이로 기각하라 — 반쪽 구성이 범인이 아니라는 근거 숫자는 무엇인가?

도전 2

역 카드 10장을 흔들릴 것 같은 순서로 세워라. 순위 상관 ρ 0.5 ★ · 0.7 ★★ · 0.85 ★★★.

도전 3

띠로 펼쳐 네 무리가 네 섬인지 한 줄의 네 토막인지 보고, 흔들리는 역이 어디에 모여 있는지 확인하라.

자료: 원장이 구운 239역의 무리 번호 · 주성분 좌표 · 여유 · 300회 흔들림과 반쪽 다섯 회 기록 — 판의 사건 카드 다섯 장은 코드 ③이 찍는 다섯 줄과 같은 값이다. 300회는 다시 계산하지 않고 재생만 한다.

3회차가 흔들린 까닭으로 나는 를 골랐고, 라는 숫자 때문에 그것을 . 흔들림은 에서 온다.

확인 문제 3에 적어 제출 →
4

네 무리는 네 섬일까 — 그리고 성적표를 채운다

4분

판에서 본 띠를 코드로 확인합니다. 출근 방향(7~10시 하차 몫 − 승차 몫)으로 네 무리를 줄 세우면 네 무리의 값 범위가 겹칠까요, 갈릴까요? 겹친다면 무리 사이에 빈 땅이 없다는 뜻입니다.

기본 코드 ④는 채워져 있습니다. 그대로 ▶ 실행해 네 줄의 최소 · 가운데 · 최대를 보세요.

도전 네 무리의 범위가 이웃끼리 맞닿아 있습니다(주거 −0.180 / 혼합 −0.176, 혼합 +0.062 / 번화 −0.031). 빈 땅이 없다는 것은 칼자리를 조금만 옮겨도 소속이 바뀌는 역이 있다는 뜻이에요 — 판에서 본 75역이 그들입니다.

탐구 첫 주성분 하나가 흩어짐의 81.2%를 설명하고 출근 방향과 상관이 0.999입니다. 그렇다면 "네 유형"이라는 이름표는 무엇을 더해 주고 무엇을 숨길까요? 8차시의 이름 붙이기로 돌아가 생각해 보세요.

네 무리가 한 줄로 눕는다면 무리 이름은 로 읽어야 하고, 경계에 선 역의 이름표는 . 이것을 성적표의 칸에 적는다.

확인 문제 4의 성적표를 채워 제출 →
체크포인트 3

두 방법·두 표본으로 같은 표를 나눠 보았고, 흔들림의 까닭을 숫자 하나로 기각했으며, 성적표 네 줄을 채웠다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    정답이 없어도 세 가지 자로 채점할 수 있다 — 내부 자(실루엣) · 일치(다른 방법 · 다른 표본) · 외부 자(넣지 않은 정보).

  2. 도구의 한계

    짝 판정 일치율은 쪼개기만 해도 오른다(0.616 → 0.718). 우연 몫을 뺀 ARI 는 그때 0.000 이었다.

  3. 보고의 규칙

    흔들린 결과는 흔들렸다고 적고 끝내지 않는다 — 무엇이 흔들리게 했는지까지 밝힌다(구성이 아니라 칼자리였다).

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. k-평균과 계층적 군집의 엇갈려 센 표에서 한 무리는 두 방법이 거의 똑같이 찾았고, 두 무리는 섞였다. 이 표에서 할 수 있는 해석 두 가지를 쓰시오.
📖 모범 답안

① 두 방법이 똑같이 찾은 무리는 방법과 상관없이 뚜렷한 집단이다. 주거 92역 가운데 69곳, 혼합 67역 가운데 60곳, 번화·대학가 48역 가운데 45곳을 Ward 도 같은 짝에 넣었다. 이렇게 서로 다른 방법이 같은 덩어리를 집어낸다면 그 무리의 이름(주거형 · 혼합형)은 믿고 보고할 만하다.

② 섞인 자리의 경계는 방법이 정한 것이다. 주거 92역 가운데 23곳은 Ward 에서 혼합 쪽 열로 갔고, 업무 32역 가운데 9곳도 갈렸다. 두 방법이 다르게 놓은 42곳은 어느 이름으로도 확신하기 어려운 역이다 — 보고서에서 이런 역은 "경계에 있다"고 따로 적거나 이름표를 붙이지 않는 편이 정직하다.

2. 두 방법의 짝 판정이 같은 비율은 0.833인데 일치 지수(ARI)는 0.588이었다. ① 왜 두 숫자가 이렇게 다른지 쓰고, ② 보고서에 어느 쪽을 쓰겠는지 까닭과 함께 쓰시오.
📖 모범 답안

① 역 짝 28,441개 가운데 18,008개는 두 방법이 모두 '다른 무리'라고 한 짝이다. 무리가 넷이면 아무 짝이나 대개 따로이므로, 이 공짜 일치가 비율을 끌어올린다. 실제로 아무렇게나 네 무리로 나눈 것과 견줘도 0.616 이 나오고, 그것을 잘게 쪼개면 0.718 까지 오른다. ARI 는 그 우연히 맞을 몫을 빼고 남은 일치만 세기 때문에 낮아진다 — 아무렇게나 나눈 것의 ARI 는 0.021, 239무리로 쪼갠 것은 0.000 이다.

② ARI 0.588 을 앞에 쓴다. 짝 판정 일치율 0.833 은 곁들이되, 같은 자료를 아무렇게나 나눈 것과 견준 값(0.616)을 반드시 함께 적는다. 그래야 0.833 이 큰 숫자인지 아닌지 읽는 사람이 판단할 수 있다. 0.588 은 "상당히 닮았지만 같지는 않다"로 읽는다 — 갈린 42곳이 그 차이다.

3. 반쪽으로 다시 나눈 다섯 회차의 ARI 가 0.626 에서 0.983까지 벌어졌다. "3회차에는 어떤 유형이 덜 뽑혔을 것"이라는 설명이 맞는가? 판에서 찾은 근거 숫자 하나를 들어 기각하거나 유지하고, 흔들림이 어디에서 오는지 쓰시오.
📖 모범 답안

기각한다. 반쪽의 유형 구성은 회차마다 거의 같다 — 3회차가 [33, 14, 47, 25], 2회차가 [35, 13, 45, 26]으로 한두 역 차이인데 ARI 는 0.626 과 0.983 으로 갈렸다. 300번을 돌려 반쪽 구성으로 ARI 를 설명해 보면 R² 0.005 이고, ARI 가 가장 낮은 10%의 평균 구성 [32.9, 15.7, 46.8, 23.7]과 가장 높은 10%의 [33.2, 15.8, 46.5, 23.5]가 거의 같다. 구성은 범인이 아니다.

흔들림은 경계에 선 역이 어느 쪽에 붙느냐에서 온다. 네 무리는 네 섬이 아니라 출근 방향 한 줄(띠)의 네 토막이고(첫 주성분이 흩어짐의 81.2% · 출근 방향과 상관 0.999), 그 띠를 자른 칼자리 ±12칸에 든 75역이 흔들림 합의 74%를 진다. 여유(첫째와 둘째로 가까운 중심까지 거리의 차)가 가장 작은 10역은 10곳 모두 20% 이상 흔들렸다 — 아무렇게나 10역을 고르면 1.9곳인데 말이다. 역의 크기는 상관이 없다(순위 상관 0.04) — 사당·신도림은 큰 환승역인데 300번 내내 0%였다.

4. 이 과제의 성적표를 채우시오. 네 줄의 값은 이미 적혀 있다 — 각 값이 말해 주는 것과 말해 주지 않는 것을 칸에 쓰시오. 그리고 아래 답 칸에 회귀 모델을 평가할 때와 군집을 평가할 때 쓰는 자가 다른 까닭을 한 문장으로 쓰시오.
분석 · 쓴 자값이 값이 말해 주는 것말해 주지 않는 것
내부 자 — 실루엣k-평균 0.324 · Ward 0.281
일치 — 방법 간(k-평균 vs Ward)ARI 0.588 · 짝 판정 0.833 · 갈린 역 42곳
일치 — 반쪽 표본 안정성5회 0.626~0.983 · 300회 평균 0.828 · 20% 이상 흔들린 역 46곳
외부 자 — 주말 비율(8차시)중앙값 업무 0.54 · 번화·대학가 0.80 · 주거 0.64 · 혼합 0.66
📖 모범 답안

실루엣 0.324 / 0.281 — 말해 주는 것: 무리 안이 무리 사이보다 가까운 정도. k-평균 쪽이 조금 낫다. 말해 주지 않는 것: 그 무리가 뜻이 있는지. 점수는 무리 수를 줄이기만 해도 오른다(k=2 가 0.507).

방법 간 일치 ARI 0.588 — 말해 주는 것: 방법을 바꿔도 큰 덩어리 셋은 그대로 선다. 말해 주지 않는 것: 옳은지. 두 방법은 같은 표·같은 구성비를 썼으므로 같은 편향을 공유한다. 갈린 42곳이 어디인지도 숫자 하나로는 안 보인다.

반쪽 안정성 300회 평균 0.828 — 말해 주는 것: 표본이 반으로 줄어도 대체로 같은 나눔이 나온다. 말해 주지 않는 것: 어느 역이 흔들리는지. 평균 뒤에는 내내 그대로인 99역과 20% 이상 흔들린 46역이 함께 있고, 흔들리는 역은 칼자리 ±12칸에 몰려 있다(75역이 흔들림의 74%).

주말 비율(외부 자) — 말해 주는 것: 군집에 넣지 않은 정보가 업무(0.54)와 번화·대학가(0.80)를 갈라 준다 — 이름이 맞았다는 바깥 증거다. 말해 주지 않는 것: 주거(0.64)와 혼합(0.66)은 가르지 못한다. 외부 자 하나가 모든 이름을 보증하지는 않는다.

회귀와 군집의 자가 다른 까닭 — 회귀에는 맞혀 볼 실제값이 있어 시험 오차 하나로 채점할 수 있지만, 군집에는 정답이 없어 결과의 모양(실루엣) · 다시 해도 같은가(다른 방법 · 다른 표본) · 밖의 정보와 맞나(주말 비율)로 간접적으로, 여러 장의 성적표로 잰다.

5. "두 방법이 같은 결과를 냈으니 이 군집은 옳다"는 주장의 약점을 쓰고, 그 약점을 메우려면 어떤 다른 종류의 자가 필요한지 예를 들어 쓰시오.
📖 모범 답안

두 방법은 같은 표를 썼다. 승차·하차 시간 칸 40개를 구성비로 바꾼 같은 숫자, 같은 거리 재는 법(유클리드), 같은 k=4 다. 입력이 같으면 입력이 가진 편향도 같이 물려받는다 — 예를 들어 교통카드 자료는 개찰구를 드나든 사람만 세고 역 안에서 갈아탄 사람은 세지 않으므로, 두 방법 모두 '환승형'을 찾아내지 못한다. 둘이 같다고 이 한계가 사라지지 않는다.

게다가 '같은 결과'도 사실이 아니다 — ARI 0.588 이고 42곳이 갈렸다.

메우려면 종류가 다른 자가 필요하다. ① 입력을 바꿔 본다 — 구성비 대신 인원 그대로 쓰면 무리가 달라진다(6차시의 척도). ② 외부 자 — 군집에 넣지 않은 주말 비율과 맞는지 본다(8차시). ③ 현장의 판단 — 역무 담당자가 읽어도 그 이름이 말이 되는지 묻는다.

6. 앞 반기 송장에서 찾은 규칙 1,600개 가운데 1,556개(97%)가 뒤 반기에도 남았지만, 앞 반기에서 향상도가 가장 높던 머핀컵(빈티지성탄) & 종이냅킨(빈티지성탄)은 28.71 에서 8.60 으로 내려앉았다. 이 규칙은 '틀린' 규칙인가? '그 시기의 규칙'과 '틀린 규칙'을 가르는 기준을 한 문장으로 쓰고, 보고 방법을 덧붙이시오.
📖 모범 답안

틀린 규칙이 아니다. 두 상품은 뒤 반기에도 함께 팔렸다 — 향상도 8.60 은 여전히 1 보다 훨씬 크다. 달라진 것은 규칙이 아니라 그 상품이 얼마나 드문가다. 빈티지성탄 상품이 든 송장은 앞 반기 1,632장 중 62장(3.8%)뿐이었는데 뒤 반기에는 2,368장 중 313장(13.2%)이 되었다. 향상도는 드문 것끼리 함께 나올 때 크게 뛰므로(9차시), 흔해지면 값이 내려온다.

가르는 기준 — 조건을 같게 맞췄을 때도 관계가 사라지면 '틀린 규칙'이고, 조건(계절 · 지역 · 손님층)이 달라져서 값이 달라진 것이면 '그 시기의 규칙'이다.

보고 방법 — 규칙에 언제의 규칙인지를 붙여 적는다("2010년 12월 · 성탄 시즌"). 평가도 같은 계절끼리 한다(앞 반기 규칙은 다음 해 같은 반기와 견준다). 두 기간에 걸쳐 재려면 향상도와 함께 각 상품이 얼마나 흔했는지를 같이 적는다.

+
더 알아보기

탐험 밖의 이야기 셋

① 239역을 Ward 로 합친 마지막 열두 번여기서 끊으면 네 무리3435362111181211101815108아래 숫자 = 그 가지에 든 역 수 · 세로 = 합칠 때 치른 값② 1837년 다윈의 공책 — 가지 뻗는 나무I think— 다윈의 공책 B(1837)에적힌 두 낱말갈라진 끝마다 오늘의 한 종 · 만나는 자리가 공통 조상
역사

다윈의 'I think' — 가지 뻗는 나무

1837년, 비글호 항해에서 막 돌아온 찰스 다윈은 공책 B 한 면에 가지가 갈라지는 그림을 그리고 그 위에 두 낱말을 적었습니다 — I think. 종들이 사다리처럼 아래에서 위로 줄지어 선 것이 아니라, 공통 조상에서 갈라져 나온 나무라는 생각이었지요.

오늘 쓴 계층적 군집은 그 나무를 거꾸로 올라갑니다. 끝에 있는 239역이 각각 제 가지이고, 가장 가까운 둘을 하나로 합치기를 되풀이해 위로 올라가다가, 우리가 원하는 높이에서 끊으면 그만큼의 무리가 됩니다. 이 기록이 곧 덴드로그램입니다. 위 그림은 239역을 Ward 로 합친 마지막 열두 번만 그린 것으로, 가로선의 높이는 그 둘을 합칠 때 무리 안의 흩어짐이 얼마나 늘었는지를 뜻합니다. 낮은 자리에서 합쳐진 가지는 서로 닮은 역이고, 높은 자리에서야 겨우 합쳐지는 가지는 억지로 한 무리가 된 것이지요.

k-평균에는 이 기록이 없습니다. k 를 바꾸면 처음부터 다시 나눠야 하고, 이전 답과 새 답이 어떤 관계인지도 남지 않아요. 계층적 군집은 나무 하나로 k=2 부터 k=239 까지의 모든 답을 한꺼번에 갖고 있습니다 — 끊는 높이만 고르면 되니까요. 대신 값을 치릅니다. 모든 쌍의 거리를 봐야 하므로 대상이 수만 개가 되면 감당하기 어려워집니다.

도해: ① 239역을 Ward 로 합친 마지막 열두 번을 scipy 로 계산해 그렸다(아래 숫자 = 그 가지에 든 역 수). ② 다윈의 공책 스케치를 본떠 그린 그림이며 원본을 옮긴 것이 아니다. · 출처: C. Darwin, Notebook B(1837), 케임브리지 대학 도서관 소장

① 역 두 곳씩 짝지어 네 칸으로 — 짝 28,441개Ward 가 같이Ward 가 따로k-평균이 같이k-평균이 따로5,672판정 같음2,349엇갈림2,412엇갈림18,008판정 같음② 우연 몫을 빼면 남는 것판정 같은 짝0.833아무렇게나 나눠도0.616우연 몫을 뺀 자 ARI0.588ARI = (판정 같은 몫 − 우연히 기대되는 몫) ÷ (1 − 우연히 기대되는 몫)
방법 더 깊이

우연 몫을 빼는 식 — ARI 는 어떻게 만들어졌나

과학이 어떤 주장을 받아들이기 전에 먼저 묻는 것이 재현성입니다 — 다른 사람이, 다른 표본으로, 다른 방법으로 해도 같은 결과가 나오는가. 오늘 한 반쪽으로 나눠 다시 하기는 그 물음을 군집에 옮긴 것입니다.

일치를 숫자로 만드는 출발점이 위 그림의 네 칸 표입니다. 역 짝 28,441개를 두 나눔의 판정으로 갈라 둘 다 같이 5,672 · k-평균만 2,349 · Ward 만 2,412 · 둘 다 따로 18,008 로 셉니다. 판정이 같은 짝의 비율 (5,672 + 18,008) ÷ 28,441 = 0.833 이 랜드 지수(rand_score)예요.

문제는 아래 막대가 보여 줍니다. 아무렇게나 나눠도 0.616 이 나오니, 0 이 기준선이 아니라 0.6 쯤이 기준선인 셈입니다. 1985년 허버트와 아라비는 그 기준선을 아예 식에 넣어 버렸습니다 — (실제 일치 − 우연히 기대되는 일치) ÷ (가능한 최대 − 우연히 기대되는 일치). 두 나눔의 무리 크기만 고정하고 짝을 마구 섞었을 때 기대되는 일치를 빼는 것이지요. 그래서 조정된 랜드 지수(Adjusted Rand Index, ARI)는 아무렇게나 나눈 것이면 0 근처, 완전히 같으면 1 이 되고, 우연보다 못하면 음수도 나옵니다. 오늘 쪼개기 실험에서 24열일 때 −0.000 이 나온 것이 그 자리입니다.

도해: ① 네 칸의 숫자는 원장이 브라우저에서 센 값(코드 ②의 짝 28,441개). ② 막대 셋은 같은 실험의 실측값이다. · 출처: L. Hubert & P. Arabie, "Comparing partitions", Journal of Classification 2(1), 1985

① 앞 반기에 향상도가 가장 높던 여섯 — 뒤 반기에는?0102030앞 반기뒤 반기향상도8.6028.715.7428.715.2225.396.1622.204.2921.097.1020.19앞에서 가장 강했던 여섯 — 머핀컵 & 종이냅킨 · 점보가방 · 도시락가방 등거의 모두 빈티지성탄 계열이다② 왜 내려앉았나 — 드물던 것이 흔해졌다앞 반기 62장 / 1,632장 = 3.8%뒤 반기 313장 / 2,368장 = 13.2%
현장

규칙에도 계절이 있다

10차시의 송장 4,000장을 앞 6개월 · 뒤 6개월로 갈라 따로 규칙을 찾아 보면, 앞에서 찾은 규칙 1,600개 가운데 1,556개(97%)가 뒤에도 살아남습니다. 그런데 앞 반기에서 가장 강했던 여섯 규칙을 따라가면 하나도 빠짐없이 아래로 내려앉아요 — 28.71 → 8.60, 25.39 → 5.22 같은 식입니다.

내려앉은 규칙은 거의 모두 빈티지성탄 계열(머핀컵 · 종이냅킨 · 종이사슬)이었습니다. 사라진 것이 아니라 흔해진 것입니다. 이 상품이 든 송장은 앞 반기 1,632장 중 62장(3.8%)뿐이었지만 뒤 반기에는 2,368장 중 313장(13.2%)이 되었어요. 향상도는 드문 둘이 함께 나올 때 크게 뛰므로, 앞 반기의 28.71 은 "이 둘의 관계가 특별히 강하다"기보다 "둘 다 드물었다"는 말에 가까웠던 것이지요(9차시의 드문 것의 함정).

그래서 유통 현장은 규칙표에 언제의 규칙인가를 반드시 함께 적습니다. 매대를 바꾸거나 묶음 상품을 만들 때 지난 시즌의 규칙을 이번 달에 그대로 쓰면 팔리지 않는 조합을 나란히 놓게 되니까요. 뒤 반기에만 새로 나타난 규칙도 1,506개나 됩니다 — 규칙표는 한 번 만들고 끝내는 자산이 아니라 기간마다 다시 재는 관측값에 가깝습니다.

도해: ① 앞 반기 향상도 상위 여섯 규칙을 뒤 반기 값과 이었다(원장이 브라우저에서 돌린 곁 코드의 출력). ② 빈티지성탄 상품이 든 송장의 비율. · 자료: UCI Online Retail(CC BY 4.0) — 10차시와 같은 파일, 반기 경계 2011-06-01