단원 홈

Ⅲ. 데이터 모델링과 평가1차시

365개의 숫자를 12개로
줄이면 무엇이 남는가

모델은 줄인 것, 잔차는 남은 것

따릉이 1년치 기록 365개를 달마다 평균 하나로 줄이면 숫자가 12개만 남습니다. 줄이는 순간 무엇이 버려지고, 버려진 나머지는 무엇을 말할까요? 오늘은 모델을 '데이터를 줄여 쓴 것'으로 보고, 줄이고 남은 잔차를 읽는 법을 손에 넣습니다.

  • [12데과03-01]
  • 50분네 정거장
  • 새 도구scikit-learn
  • 자료UCI 따릉이 365일(2017-12 ~ 2018-11)
Ⅲ 단원 지도1 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    데이터를 모델 + 잔차로 갈라 보고, 모델의 세 부분(목적 · 형태 · 매개변수)을 짚을 수 있다.

  2. 손으로

    잔차를 구해 그림과 표로 읽고, 가장 크게 빗나간 날의 까닭을 날씨 · 운영 기록에서 찾을 수 있다.

  3. 확인에서

    숫자 1개 모델과 견주어 어떤 모델이 쓸 가치가 있는지 한 줄로 적을 수 있다.

1
여는 장면 · 5분

같은 따릉이인데 하루 평균이 7배 다르다

오늘부터 자료를 갈아탑니다. Ⅱ 단원에서 쓰던 따릉이는 서울 열린데이터광장이 공개한 2024년 대여 이력이었고, 날씨는 우리가 기상청 자료를 찾아 이어 붙였습니다. 오늘부터 쓸 따릉이는 연구용으로 공개된 2017년 12월 ~ 2018년 11월 자료로, 기온 · 강수 · 습도 · 휴일 · 운영 여부가 이미 붙어 있습니다. 붙이는 수고를 덜었으니 모델에 집중할 수 있습니다.

그런데 편한 만큼 보지 못하는 것도 생깁니다. 누군가 이미 합치고 다듬은 자료라, 그 손질을 우리가 확인할 수 없어요. 자료를 갈아탈 때는 늘 다섯 칸을 먼저 읽습니다 — 출처 · 기간 · 한 행은 무엇인가 · 붙어 있는 열 · 무엇을 셌나.

표 1두 따릉이 자료의 신상갈아타기 전에 읽는 다섯 칸
읽을 칸Ⅱ 단원에서 쓰던 자료오늘부터 쓸 자료
출처서울 열린데이터광장 · 따릉이 대여 이력UCI 기계학습 저장소 · 연구용 자료(CC BY 4.0)
기간2024-01-01 ~ 2024-12-31 · 366일2017-12-01 ~ 2018-11-30 · 365일
한 행은 무엇인가하루 — 우리가 대여 이력을 날짜별로 셌다원본은 1시간(8,760행) — 우리가 하루로 묶었다
붙어 있는 열대여 건수뿐 — 날씨는 우리가 이어 붙였다기온 · 강수 · 습도 · 휴일 · 운영 여부가 이미 붙어 있다
하루 평균119,814건16,910대 (운영한 353일만 보면 17,485대)

마지막 칸이 7.1배 차이 납니다(119,814 ÷ 16,910). 그렇다고 '따릉이 이용이 7배로 늘었다'고 써도 될까요? 해가 다르고, 대여소와 자전거 수가 달라졌고, 무엇보다 두 자료가 같은 것을 셌는지 아직 확인하지 않았습니다. 자료: 서울 열린데이터광장 따릉이 대여 이력 2024 · UCI Seoul Bike Sharing Demand(CC BY 4.0, DOI 10.24432/C5F62R) — 원장 계산

자료를 읽었으니 이제 오늘의 일입니다. 아래 두 그림은 같은 1년을 두 가지로 적은 것이에요. 왼쪽은 하루도 빠뜨리지 않고 365개를 그대로 적었고, 오른쪽은 달마다 평균 하나로 줄여 12개만 남겼습니다.

그림 1같은 1년, 숫자 365개와 숫자 12개세로는 하루 대여(대) · 두 그림의 눈금이 같다
그대로 — 숫자 365개하루에 하나씩 다 적는다01만2만3만17.1218.0118.0318.0518.0718.0918.11365개를 다 기억해도 내일은 말하지 못한다 줄여서 — 숫자 12개달마다 평균 하나(모델 A)01만2만3만12월4,8391월2월3월4월5월29,8966월7월8월9월10월11월12개만 기억하면 내일도 답할 수 있다 그대로 — 숫자 365개하루에 하나씩 다 적는다01만2만3만17.1218.0318.0618.09365개를 다 기억해도 내일은 말하지 못한다 줄여서 — 숫자 12개달마다 평균 하나(모델 A)01만2만3만12월4,8392월4월29,8966월8월10월12개만 기억하면 내일도 답할 수 있다

막대 12개는 365개가 말하던 것을 거의 다 잃었습니다 — 비 오던 날, 운영하지 않아 0대였던 날, 주말과 평일의 차이가 모두 뭉개졌어요. 그런데도 우리는 오른쪽을 '모델'이라 부르고 왼쪽을 그렇게 부르지 않습니다. 왜일까요? 자료: UCI Seoul Bike Sharing Demand 365일 — 달 평균은 3정거장 코드 ①이 찍는 값과 같다(원장 계산)

먼저 예측

그림 1의 막대 12개가 버린 것을 한 문장으로 적어 보세요 — "비 온 날이 사라졌다"처럼 구체적으로요. 그리고 버려진 그것을 다시 찾으려면 어떤 그림을 그려야 할지도 한 줄 덧붙여 두세요. 3정거장 미션 ②에서 여러분의 문장과 실제 잔차 그림을 맞대어 봅니다.

체크포인트 1

자료를 갈아타며 다섯 칸을 읽었고, 같은 1년을 숫자 365개와 12개로 적은 두 그림을 보았다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

모델은 줄인 것, 잔차는 남은 것

2-1데이터 = 모델 + 잔차

데이터 모델은 데이터 속의 관계를 수식 · 규칙 · 구조로 줄여 쓴 것입니다. 그림 1의 오른쪽 — 달마다 평균 하나, 숫자 12개 — 도 어엿한 모델이에요. 이 모델을 오늘 모델 A라고 부릅니다.

줄였으니 맞지 않는 날이 생깁니다. 어느 날의 실제 대여에서 그날에 대한 모델의 답을 뺀 것을 잔차라고 합니다. 그러면 데이터는 늘 두 조각으로 갈립니다.

이 차시의 식데이터 = 모델(요약) + 잔차(나머지) — 잔차 = 실제 − 모델의 답.

그러면 숫자를 늘릴수록 좋은 모델일까요? 365개를 그대로 적은 표는 단 하루도 틀리지 않습니다(잔차가 모두 0). 그런데도 그것을 모델이라 부르지 않는 까닭이 옆 판에 있습니다.

2-2모델의 세 부분, 그리고 남는 것

어떤 모델이든 뜯어보면 세 부분입니다. 여기에 '줄이고 남은 것' 하나를 더해 넷으로 읽으면, 이 단원 14차시에서 만날 모든 모델을 같은 자리에서 볼 수 있습니다.

모델을 읽는 나침반 — 네 방향을 차례로

  1. 목적무엇을 묻는가 — 수를 맞힐까, 무리로 묶을까, 규칙을 찾을까
  2. 형태어떤 모양으로 줄일까 — 평균 하나? 달마다 하나? 직선?
  3. 매개변수형태 안의 숫자 — 모델 A의 달 평균 12개가 이것이다
  4. 잔차줄이고 남은 것 — 아직 규칙이 남아 있을 수 있다

형태는 내가 고르고, 매개변수는 데이터가 정합니다. 모델 A에서 '달마다 하나'는 사람이 고른 형태이고, 12개의 높이는 우리가 정한 것이 아니라 그 달의 값들이 정한 것이에요. 아래 칸막이 판에서 이 둘을 손으로 가릅니다.

2-3손으로 형태를 고른다 — 칸막이 판

칸막이 판은 1년 365일을 날짜 순서대로 눕혀 놓고, 그 위에 칸막이를 꽂아 몇 토막으로 자르는 판입니다. 칸막이를 어디에 몇 개 꽂느냐가 모델의 형태이고, 토막마다의 평균 높이가 매개변수예요. 칸막이를 놓는 순간 양옆 계단이 그 칸의 평균으로 가라앉는데, 이것이 바로 도구가 말하는 fit입니다.

판에는 장치가 셋 더 있습니다. 성적 자취는 칸막이를 하나만 꽂았을 때 그것을 날마다 옮겨 보면 나오는 빗나감을 레일 아래에 그린 곡선입니다. 도구에게 맡기기는 지금 칸막이는 그대로 두고 오차를 가장 많이 줄이는 자리 하나를 기계가 꽂아 주는 단추입니다. 다른 해 창은 2024년 따릉이 기록을 덮어 둔 창으로, 2018년으로 만든 모델을 한 번도 본 적 없는 해에 대어 봅니다.

시뮬레이터

칸막이 판

1년을 숫자 몇 개로 말할까 — 줄이지 않은 것은 다른 해가 벌한다

  1. 1레일을 톡 쳐 예측 핀을 꽂고 잠근다
  2. 2칸막이를 꽂고 끌어 계단을 가라앉힌다(레일 아래로 끌면 뺀다)
  3. 3다른 해 창을 열어 내 모델을 시험한다
① 예측 — 칸막이 하나를 어디에?
② 칸막이 — 손으로, 그리고 도구에게
③ 다른 해 창 — 2024년을 가장 잘 말할 모델은?
1년 판 — 숫자 1개(1년 평균 16,910대)① 예측부터 — 네 자리 가운데 하나를 고르거나 레일을 톡 치세요.

빗나감 = 날마다 |실제 − 그 칸의 평균| 을 365일에 걸쳐 평균한 값 · 기억하는 숫자 k개 = 칸이 k개(칸막이 k−1개) · 칸 높이는 놓는 순간 그 칸의 평균으로 정해진다(= fit)

다른 해 창 — 두 자료는 센 것이 달라 '그 해 평균의 몇 배'로만 견준다. 같은 월 · 일에 대므로 윤년인 2024년은 3월부터 요일이 하루 밀린다(2월 29일은 뺐다)

파이썬으로 — 지금 꽂은 칸막이를 코드 한 줄로. 3정거장 미션 ④의 코드 ⑤에 있는 경계 = […] 줄에 붙여 넣으면 이 계기판과 같은 숫자가 나온다

경계 = []
평균 빗나감9,154대
기억하는 숫자1
숫자 1개 모델(대)9,154
달력 12개 모델(대)4,691
2018 빗나감(%)54.1
2024 빗나감(%)—
도전 1

칸막이 하나로 평균 5,545대 이하까지 내려라. 1년에서 가장 큰 갈림은 어디인가?

도전 2

숫자 6개 이하로 달력 12개(4,691대)를 이겨라 — 숫자를 절반으로 줄이고도.

도전 3

숫자 5개로 도구가 낸 4,703대도 이겨라. 도구는 한 번에 하나씩 고르느라 놓치는 답이 있다.

자료: UCI Seoul Bike Sharing Demand 365일 + 서울 열린데이터광장 2024 따릉이 366일(2월 29일은 뺐다) — 쪽 안에 실은 값은 원장이 구운 것이다. 두 자료는 센 것이 달라 '그 해 평균의 몇 배'로만 견준다. 같은 월 · 일로 대므로 2024년은 윤년이라 3월부터 요일이 하루 밀린다.

2-4잔차를 읽는 것이 모델링의 절반

판에서 본 대로, 좋은 모델을 한 번에 세우는 방법은 없습니다. 대신 되돌이 고리가 있어요 — 세우고 → 잔차에서 남은 규칙을 찾고 → 고치고 → 그래도 남는 것은 '사건'으로 따로 적습니다. 3정거장에서 이 고리를 한 바퀴 돌립니다. 아래 네 쌍은 그 고리가 지나가는 자리들이에요.

1년 평균 하나 · 달 평균 열둘
9,154숫자 1개 · 빗나감(대)
→
4,691숫자 12개 · 빗나감(대)
9,154숫자 1개4,691숫자 12개

숫자를 12배 늘려 빗나감을 절반으로 줄였다.

달력이 정한 칸 · 데이터가 정한 칸
4,691달력 12개(대)
vs
4,632칸막이 5개(대)
4,691달력 12개4,632칸막이 5개

더 적은 숫자가 더 낫다 — 달의 경계는 데이터의 경계가 아니다.

잔차 속의 요일 · 토요일과 일요일
+103토요일 잔차 평균(대)
인데
−1,903일요일 잔차 평균(대)
월화수목금토일+−일 −1,903

같은 주말인데 다르다 — 모델 A가 놓친 규칙.

잔차 속의 비 · 온 날과 안 온 날
+1,904비 안 온 날 253일(대)
vs
−4,818비 온 날 100일(대)
−4,818비 온 날 100일+1,904비 안 온 날 253일

부호가 갈린다 — 잔차에 날씨가 아직 들어 있다.

자료: 위 네 쌍의 숫자는 모두 3정거장 코드 ② · ④ · ⑤ · ⑥이 찍는 값이다(운영한 353일로 다시 만든 모델 A 기준 — 넷째 쌍).

Ⅱ-3 에서 가져옴자료를 받으면 먼저 신상명세서를 쓴다고 배웠습니다. 오늘 표 1의 다섯 칸이 그것이고, 모델을 세우기 전에 다시 한 번 씁니다 — 분석 대상이 아닌 행이 섞이면 모델부터 오염되기 때문입니다.

체크포인트 2

모델의 네 방향(목적 · 형태 · 매개변수 · 잔차)을 말할 수 있고, 형태를 손으로 바꿔 보며 '줄이지 않은 것은 모델이 아니다'를 다른 해가 벌하는 것을 보았다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

잔차를 구하고, 가장 크게 빗나간 날을 찾는다

오늘의 장비

scikit-learn — 모델을 세우는 도구

Ⅱ 단원에서 pandas 로 평균을 계산했다면, 오늘부터는 scikit-learn 으로 모델을 세웁니다. 이 도구의 모델은 크든 작든 동작이 둘뿐이에요 — fit(데이터로 숫자를 정한다 = 배우기)과 predict(답하기). 처음 실행은 몇 초 멈춥니다 — 고장이 아니라 도구를 처음 받는 중이에요(쪽마다 한 번).

부르는 모양

from sklearn.dummy import DummyRegressor

모델 = DummyRegressor(strategy="mean")
모델.fit(X, y)           # 배우기
답 = 모델.predict(X)     # 답하기

오늘 쓰는 함수 넷

DummyRegressor
가장 작은 모델 — strategy 로 평균 · 중앙값
fit
데이터로 매개변수를 정한다(배우기)
predict
새 입력에 답한다(답하기)
mean_absolute_error
평균 몇 대 빗나가는지 재는 자

pandas 와 다른 셋

  1. 모델이 남는다pandas 는 값을 돌려주고, 여기서는 fit 한 모델이 남아 새 입력에 답한다
  2. 어떤 모델이든 같은 두 동작평균이든 직선이든 나무든 fit · predict
  3. 자를 함께 준다mean_absolute_error 같은 채점 함수가 한 벌로 들어 있다

대가 — 도구는 답을 주지만 그 답이 쓸 만한지는 말해 주지 않습니다. 그래서 늘 '숫자 1개 모델'과 견줍니다.

1

자료의 신상을 찍고, 숫자 12개짜리 모델을 만든다

2분

12달 가운데 하루 대여가 가장 적은 달은 언제일까요? 대부분 12월이나 2월에 걸기 쉽습니다. 그리고 가장 많은 달도 하나 짚어 두세요 — 7·8월을 고를 것 같지만 아닐 수도 있습니다.

기본 코드 ①은 채워져 있습니다. 그대로 ▶ 실행해 표 1의 오른쪽 칸(기간 · 365일 · 운영한 날 · 하루 평균)이 맞는지 확인하고, 달 평균 12개를 예측과 맞대어 보세요.

도전 마지막에서 셋째 줄 f"{m[2:]} …" 의 m[2:] 를 m 으로 바꿔 보세요. 줄 폭이 넘쳐 한 줄에 넷이 들어가지 않습니다 — 출력도 읽히게 짓는 것이 코드의 일부입니다.

이 자료의 하루 평균은 대이고 Ⅱ 단원 자료는 119,814건이라 배다. 이 배수를 '이용이 그만큼 늘었다'로 읽기 전에 와 를 먼저 확인해야 한다.

확인 문제 1에 적어 제출 →
2

잔차를 만든다 — 데이터에서 모델을 빼면

7분

여는 장면에 적어 둔 내 예측입니다. 잔차 그림에서 정말 그것이 보일까요? 그리고 잔차 막대가 가장 크게 흔들리는 철은 언제일지 먼저 짐작해 두세요.

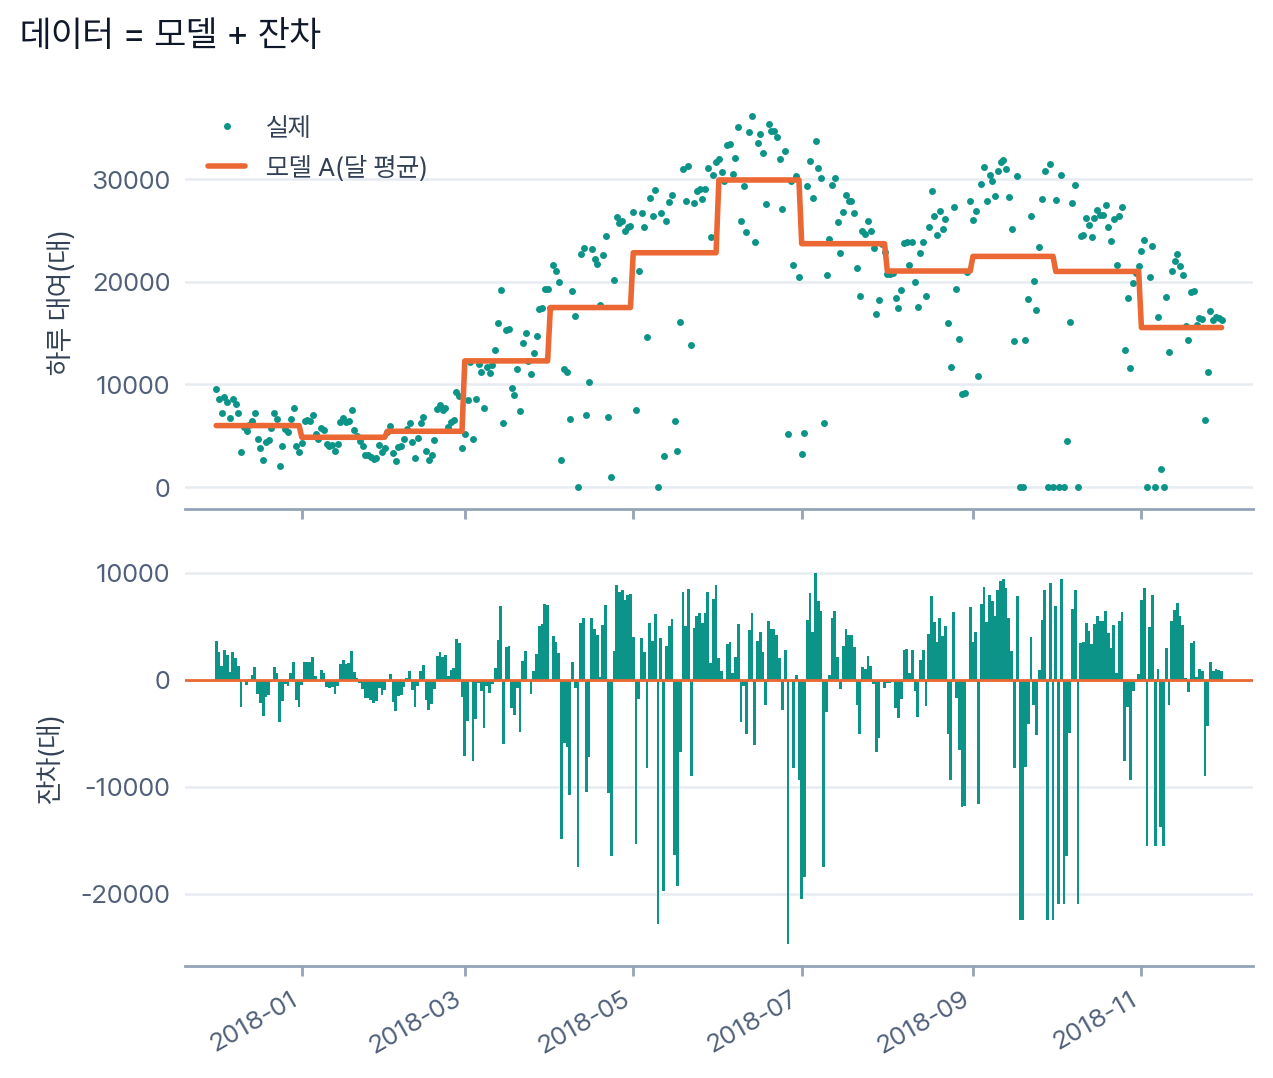
기본 빈칸 ①에 잔차를 만드는 한 줄을 채우고 ▶ 실행합니다. 이 차시의 핵심이 이 뺄셈 한 줄이에요 — 실제에서 모델의 답을 뺀다. 그림은 위 칸에 실제(점)와 모델 A(계단), 아래 칸에 잔차(막대)가 나옵니다.

도전 요일 줄의 .mean() 을 .median() 으로 바꿔 보세요. 평일 다섯이 모두 +로 바뀝니다(목 +936 ~ 금 +2,128, 일 −1,516). 평균은 운영하지 않은 날의 0대에 끌리지만 중앙값은 덜 끌립니다.

탐구 겨울(12~2월)보다 여름 · 가을의 잔차가 크게 흔들립니다. 대여량 자체가 커서일까요, 비 때문일까요? 둘을 가르려면 무엇을 재면 될지 짝과 말해 보세요 — 3차시에서 기온을 넣은 모델로 실제로 가릅니다.

요일별 잔차 평균이 0에서 가장 먼 요일은 이고, 그 값은 대다. 이것은 모델 A가 를 놓쳤다는 뜻이므로, 모델을 고치려면 를 칸으로 더하면 된다.

확인 문제 4에 적어 제출 →
3

탐정표 — 가장 크게 빗나간 10일에 무슨 일이 있었나

4분

모델보다 훨씬 적게 빌린 날 10일을 뽑으려 합니다. 그 10일 가운데 비가 온 날은 며칠일까요? 숫자 하나를 짐작해 두고 시작하세요.

기본 빈칸 ②에 '잔차가 가장 작은 10행'을 뽑는 함수 이름을 채웁니다. '적게 빌린 쪽으로 빗나감'은 잔차가 가장 작은(가장 큰 음수) 쪽이에요 — 방향을 고르는 자리입니다.

도전 nsmallest 를 nlargest 로 바꿔 '훨씬 많이 빌린 날'을 보세요. 1위 7월 6일 +9,984, 2위 10월 3일(개천절, 표에 공휴 1) +9,359 — 공휴일이 늘 적은 날은 아닙니다.

10일 가운데 8일은 이라 수요가 0이 아니라 이다. 그러므로 이 날들은 모델을 고칠 근거로 쓰지 않고 해야 한다.

확인 문제 2에 적어 제출 →
4

숫자 1개 모델 — 손으로 한 번, 같은 일을 도구로

3분

가장 추운 날(−14.7°C)과 가장 더운 날(33.7°C)의 기온을 도구에 넣어 줍니다. 도구는 두 날에 각각 몇 대라고 답할까요? 두 숫자를 짐작해 두세요.

기본 코드 ④는 채워져 있습니다. 그대로 ▶ 실행해 손(pandas)으로 낸 값과 도구(scikit-learn)가 낸 값이 같은지 먼저 보고, 두 날의 답을 예측과 맞대어 보세요.

도전 strategy="mean" 을 "median" 으로 바꾸면 답은 17,730대, 빗나감은 9,134대가 됩니다 — 평균일 때(9,154)보다 작아요. 절대 오차를 가장 작게 만드는 한 숫자는 평균이 아니라 중앙값입니다.

도전 한 걸음 더 코드 ⑤에는 경계 넷이 이미 들어 있습니다. 먼저 그대로 ▶ 실행해 칸 다섯의 평균과 빗나감을 보고, 그다음 위 칸막이 판에서 [경계 한 줄 복사]를 눌러 내가 꽂은 칸막이로 바꿔 넣어 보세요. 판의 계기판과 같은 숫자가 나온다면, 판은 답을 '보여 준' 것이 아니라 같은 계산을 한 것입니다.

도구가 대신해 준 것은 이고, 말해 주지 않은 것은 이다. 365개 표는 빗나감이 0인데도 모델이 아닌 까닭은 이기 때문이다.

확인 문제 3에 적어 제출 →
5

분석 대상이 아닌 행을 걸러 내고 모델 A를 다시 세운다

4분

운영하지 않은 날 12일을 빼고 달 평균을 다시 구하면, 이제 맨 위로 올라올 날은 어떤 날일까요? 미션 ③의 탐정표를 떠올리며 짐작해 두세요.

기본 빈칸 ③에 '운영한 날만' 고르는 조건을 채웁니다. 분석 대상이 아닌 행이 섞이면 달 평균(모델)부터 오염됩니다 — Ⅱ 단원 전처리와 모델링이 한 고리인 까닭이에요.

도전 비 = 운영["rain_mm"] > 0 을 >= 10 으로 바꾸면 32일이 되고, 그 32일의 잔차 평균은 −10,561대(나머지 +1,053)가 됩니다. 많이 오는 비일수록 더 깎입니다.

탐구 모델 A에 칸을 하나만 더한다면 무엇을 더하겠습니까 — 요일 · 비 · 기온 가운데 하나를 고르고, 고른 까닭과 그 칸으로 줄어들 것 같은 잔차를 확인 문제 6의 답 칸에 적으세요.

비 온 날의 잔차 평균이 대라고 해서 곧바로 '비가 대여를 줄인다'고 쓸 수 없다. 잔차는 만 뺀 것이라 가 아직 섞여 있기 때문이다.

확인 문제 6에 적어 제출 →
체크포인트 3

잔차를 직접 만들어 그림 · 표 · 요일별 평균으로 읽었고, 가장 크게 빗나간 날들의 까닭을 찾아 걸러 낼 것과 모델에 더할 것으로 갈랐다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    데이터는 모델 + 잔차로 갈린다. 365개를 12개로 줄이자 빗나감이 9,154 → 4,691대가 되었고, 남은 잔차에는 요일(일요일 −1,903대)과 비(−4,818대)가 아직 들어 있었다.

  2. 도구의 한계

    DummyRegressor 는 기온을 받고도 보지 않는다. 도구는 답을 주지만 그 답이 쓸 만한지는 말해 주지 않는다 — 기준 모델과 견주는 것은 사람 몫이다.

  3. 보고의 규칙

    모델을 보고할 때는 기억하는 숫자의 개수와 숫자 1개 모델보다 얼마나 덜 틀리는지를 함께 적는다. 그리고 분석 대상이 아닌 행은 모델을 세우기 전에 걷어 낸다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. Ⅱ 단원 따릉이(2024)의 하루 평균이 오늘 자료(2017–18)의 7.1배로 나왔다(119,814 ÷ 16,910). "따릉이 이용이 7배로 늘었다"고 써도 되는가? 먼저 확인할 것 둘을 들어 답하시오.
📖 모범 답안

아직 아니다.

① 두 자료가 같은 것을 셌는지 설명 페이지로 확인한다 — 한쪽은 '대여 건수', 다른 쪽은 연구용으로 묶인 '대여 수'다. 모든 대여소를 셌는지, 한 번의 이용을 몇 건으로 세는지가 다르면 배수는 뜻이 없다.

② 해와 규모가 다르다 — 2017–18년과 2024년 사이에 대여소와 자전거 수가 크게 늘었다. 서울시가 해마다 내는 통계와 견주고, 같은 해를 두 자료로 잴 수 있다면 그것부터 한다. 배수는 '이용이 얼마나 늘었나'가 아니라 '무엇을 셌나가 얼마나 다른가'를 먼저 가리킨다.

2. 어느 날 모델 A의 답이 2만 1천 대인데 실제 대여가 0대였다. 이 날을 모델을 고칠 근거로 쓸지, 표에서 걸러 낼지 — 확인할 열과 판단을 쓰시오.
📖 모범 답안

functioning 열을 본다.

운영하지 않은 날이면 그 0은 '수요가 0'이 아니라 '측정이 없는 날'이다. 분석 대상에서 빼고 달 평균을 다시 구한다 — 빼지 않으면 그 달의 평균(모델)부터 낮게 끌려 내려간다. 실제로 12일을 빼자 평균 빗나감이 4,691대에서 3,908대로 줄었고, 가장 크게 빗나간 8일이 모두 비 온 날로 바뀌었다.

운영했는데도 0이면 그때는 기록 오류를 의심하고, 같은 날 다른 자료(날씨 · 사고 기록)와 맞대어 본다.

3. DummyRegressor 에 기온을 넣어 주었는데 가장 추운 날과 가장 더운 날의 답이 똑같았다. 고장인가? 그리고 '365일 표 그대로'(숫자 365개, 빗나감 0)와 견주어 이 모델은 왜 모델인가 쓰시오.
📖 모범 답안

고장이 아니다. 평균 하나만 기억하고 입력을 보지 않는 모델이라, −14.7°C 에도 33.7°C 에도 16,910대라고 답한다.

표 그대로는 빗나감이 0이지만 아무것도 줄이지 않아 표에 없는 날(내일)에는 한마디도 하지 못한다. 숫자 1개 모델은 잘 맞든 아니든 내일에도 답한다 — 그래서 모델이다. 판의 다른 해 창에서 표 그대로는 41.2%, 숫자 1개는 35.1%로, 줄이지 않은 쪽이 더 크게 틀렸다.

그래서 어떤 모델이든 이 '숫자 1개'보다 덜 틀려야 쓸 가치가 있다 — 이것을 기준 모델이라 하고, 12차시 성적표의 첫 줄이 된다.

4. 요일별 잔차 평균에서 일요일만 −1,903대로 0에서 가장 멀었다(토요일은 +103). 그런데 .mean() 을 .median() 으로 바꾸자 평일 다섯이 모두 +936 ~ +2,128로 바뀌었다. ① 모델 A는 무엇을 놓쳤는가 ② 평균과 중앙값이 이렇게 다른 까닭은 무엇인가 쓰시오.
📖 모범 답안

① 일요일 효과(쉬는 날)를 놓쳤다. 잔차에 아직 요일 규칙이 남아 있다는 뜻이므로, 달마다 '평일 · 일요일' 두 칸을 두어 모델을 키우고 빗나감이 줄었는지 확인한다.

② 평균은 운영하지 않은 날(0대)과 폭우가 온 날처럼 크게 빗나간 몇 날에 끌린다. 그래서 평일끼리도 부호가 들쭉날쭉했다(화 −448 · 목 −369). 중앙값은 그런 몇 날에 덜 흔들려 평일이 모두 +로 선다. 운영하지 않은 날을 걸러 낸 뒤 다시 재는 것이 먼저다 — 미션 ⑤에서 걸러 내자 평균 빗나감이 3,908대로 줄었다.

5. 다음 물음마다 필요한 모델의 출력 모양(수 / 무리 번호 / 'A→B' 규칙)을 고르고, 그렇게 고른 까닭을 한 줄씩 쓰시오.
물음출력 모양고른 까닭
㉠ 다음 주 월요일의 대여량
㉡ 하루 이용 모양이 비슷한 역끼리 묶기
㉢ '비 오는 날엔 대여가 적다'가 자주 함께 일어나는가
📖 모범 답안

㉠ 수(회귀) — 답이 '몇 대'라는 숫자 하나다. 3~5차시에서 다룬다.

㉡ 무리 번호(군집) — 정답표가 없고, 비슷한 것끼리 묶는 것이 답이다. 6~8차시.

㉢ 'A→B' 규칙(연관) — 함께 일어나는 정도를 재는 것이 답이다. 9~11차시.

같은 따릉이 표에 네 가지를 물으면 네 모델이 나온다 — 좋은 모델은 데이터가 아니라 물음이 정한다.

6. 운영한 날만으로 다시 만든 모델 A에서 가장 크게 빗나간 8일이 모두 비 온 날이었다. 여기서 "비가 대여를 줄인다"고 결론 내려도 되는가? 무엇을 더 확인해야 하는지 쓰시오. 그리고 미션 ⑤의 탐구 — 모델 A에 칸을 하나 더한다면 무엇을(요일 · 비 · 기온) 고를지 까닭과 함께 덧붙이시오.
📖 모범 답안

아직 아니다. 잔차는 달 평균만 뺀 것이라, 같은 달 안의 기온 차이가 그대로 섞여 있다. 비 온 날이 특정 시기(장마철)에 몰려 있을 수도 있어, 지금 보이는 −4,818대에는 비의 몫과 기온·계절의 몫이 섞여 있다. 기온을 함께 넣은 모델(3차시)로 비의 몫을 따로 재야 한다.

칸을 하나 더한다면(예) — 비를 고른다. 비 온 날 −4,818 / 안 온 날 +1,904로 부호가 갈리고, 강수 10mm 이상으로 좁히면 −10,561대까지 벌어져 효과가 가장 또렷하기 때문이다. 달마다 '비 온 날 · 안 온 날' 두 칸을 두면 숫자가 12개에서 24개로 늘지만, 위 8일의 잔차가 크게 줄어들 것이다. (요일을 고른다면 일요일 −1,903을, 기온을 고른다면 같은 달 안의 더위·추위 차이를 근거로 들면 된다.)

+
더 알아보기

탐험 밖의 이야기 셋

입력근거출력수치예보모델물리 모델지금의 대기관측값대기의 운동방정식을 푼다내일의 기온· 강수따릉이 대여 모델데이터 모델지난 365일의기록자료에서 찾은관계(모델 A)내일의대여량예보 기온을 대여 모델의 입력으로 넣는다근거물리 모델은 사람이 세운 방정식, 데이터 모델은 자료에서 찾은 관계자료가 없으면물리 모델은 여전히 답한다 · 데이터 모델은 답하지 못한다규칙이 바뀌면물리 모델은 그대로 · 데이터 모델은 다시 배워야 한다
방법 더 깊이

방정식으로 푸는 모델, 데이터에서 찾는 모델

기상청의 일기예보는 오늘 우리가 만든 것과 전혀 다른 종류의 모델에서 나옵니다. 수치예보모델은 대기를 잘게 나눈 격자마다 지금의 기온 · 기압 · 바람을 넣고, 공기의 운동과 열을 적은 방정식을 시간에 따라 풀어 내일의 값을 계산합니다. 근거가 데이터가 아니라 물리 법칙이에요. 그래서 한 번도 겪어 보지 못한 날씨에도 답을 내놓고, 관측이 적은 바다 위에서도 계산이 이어집니다.

오늘의 대여 모델은 반대입니다. 법칙을 세운 적이 없고, 지난 365일이 어떠했는지만 압니다. 그래서 자료가 없으면 아무 말도 못 하고, 대여소가 두 배로 늘어 세상의 규칙이 바뀌면 다시 배워야 합니다. 대신 방정식을 몰라도 세울 수 있고, 사람이 미처 적지 못한 관계까지 자료에서 주워 옵니다.

둘은 경쟁하지 않고 이어 붙습니다. 실제 따릉이 수요 예측은 수치예보모델이 낸 내일의 기온과 강수를 데이터 모델의 입력으로 받아 대여량을 냅니다. 한쪽이 물리로 내일의 날씨를 만들고, 다른 쪽이 데이터로 그 날씨에 사람들이 어떻게 움직일지를 답하는 것이지요. 3차시부터 우리 모델에 기온을 넣기 시작하면, 그 기온이 어디에서 오는지도 함께 생각해 보세요.

도해: 두 모델을 입력 · 근거 · 출력 세 칸으로 나란히 그리고, 예보 기온이 대여 모델의 입력으로 들어가는 자리를 표시했다.

천왕성 — 계산한 자리와 관측한 자리뉴턴 역학으로 계산한 궤도● 실제로 관측한 자리 — 조금씩 벗어난다그 나머지(잔차)만 따로 그리면한쪽으로만 쌓인다 — 우연이 아니다같은 물음, 다른 답 둘1846 · 해왕성✓르베리에가 그 나머지를 만들 보이지않는 행성의 자리를 계산했고,갈레가 그 자리에서 찾아냈다.잔차가 숨은 원인을 가리켰다1859 · 벌칸✕수성 궤도의 나머지로도 같은 방법을썼지만 그런 행星은 없었다.끝내 새 이론이 설명했다.잔차가 모델 자체의 한계를 가리켰다잔차는 숨은 원인을 가리키기도, 모델이 틀렸음을 가리키기도 한다
역사

잔차에서 찾은 행성, 잔차에서 찾지 못한 행성

1781년에 발견된 천왕성은 곧 천문학자들을 괴롭혔습니다. 뉴턴 역학으로 계산한 궤도와 실제로 관측한 자리가 해마다 조금씩 어긋났거든요. 오늘 우리 말로 하면 잔차가 0으로 흩어지지 않고 한쪽으로 쌓인 것입니다. 1845~46년, 프랑스의 르베리에와 영국의 애덤스는 그 나머지를 관측 오차로 버리는 대신 '그 나머지를 만들려면 보이지 않는 행성이 어디에 있어야 하는가'를 거꾸로 계산했습니다. 르베리에가 보낸 좌표를 받은 베를린 천문대의 갈레는 그날 밤 그 자리 가까이에서 해왕성을 찾아냈습니다.

같은 사람이 같은 방법을 한 번 더 썼습니다. 수성의 궤도에도 설명되지 않는 나머지가 있었고, 르베리에는 태양에 더 가까운 행성 '벌칸'을 예언했습니다. 이번에는 아무도 그것을 찾지 못했어요. 수성의 나머지는 숨은 행성이 아니라 뉴턴 역학 자체의 한계였고, 1915년 아인슈타인의 일반 상대성 이론이 그 값을 정확히 설명하고 나서야 끝났습니다.

잔차를 읽는 일에는 늘 이 두 갈래가 함께 있습니다. 남은 것이 아직 넣지 않은 원인을 가리킬 수도 있고, 모델의 형태 자체가 틀렸음을 가리킬 수도 있어요. 오늘 우리가 찾은 일요일과 비는 첫째 갈래입니다 — 모델에 칸을 더하면 됩니다. 그러나 칸을 아무리 더해도 남는 것이 있다면, 그때는 형태를 바꿔야 합니다.

도해: 위는 천왕성의 계산 궤도와 관측 자리의 차이, 가운데는 그 차이만 따로 그린 막대, 아래는 같은 방법의 두 결말(해왕성 ✓ · 벌칸 ✕). 자리와 크기는 이야기를 보이기 위한 예시다.

우리가 받은 표는 이미 한 번 손질된 것원본(UCI)8,760행 × 14열1시간 = 한 행우리 표365행 × 7열하루 = 한 행손질보이지 않는 손질 — 우리가 하지 않았고 볼 수도 없다시간 → 하루24행을 하나로 묶었다날씨를 붙였다어느 관측소 값인지 표에 없다휴일을 표시했다우리 달력과 다른 날이 8일그래서 설명 페이지에서 먼저 읽을 넷① 누가 · 왜 모았나② 한 행은 무엇인가③ 날씨는 어떻게 붙였나④ 라이선스(CC BY 4.0)출처를 밝히면 고쳐 써도 된다
현장

연구용으로 다듬은 데이터를 쓸 때

오늘 우리가 받은 표는 UCI 기계학습 저장소에서 왔습니다. 1987년 캘리포니아 대학교 어바인에서 연구자들이 알고리즘을 같은 자료 위에서 견주어 보려고 만든 창고인데, 지금은 전 세계가 쓰는 공공 저장소가 되었어요. 덕분에 우리는 대여 기록과 날씨를 직접 합치는 수고 없이 곧바로 모델을 세울 수 있었습니다.

편한 만큼 보이지 않는 손질이 들어 있습니다. 원본은 1시간마다 한 행씩 8,760행인데 우리가 그것을 하루로 묶었고, 기온 · 강수 · 습도는 누군가가 어느 관측소의 값을 골라 붙인 것입니다. 휴일 표시도 마찬가지예요 — 이 표가 '휴일'이라 적은 18일에는 2018년 5월 1일(근로자의 날)이 들어 있고, 반대로 어린이날과 추석 대체공휴일은 표시가 없습니다. 우리 달력과 8일이나 다릅니다. 고치지 않고 그대로 두되, 그 사실을 알고 쓰는 것과 모르고 쓰는 것은 전혀 다릅니다.

그래서 남이 다듬은 자료를 받으면 설명 페이지에서 넷을 읽습니다 — 누가 · 왜 모았나, 한 행은 무엇인가, 다른 자료는 어떻게 붙였나, 라이선스는 무엇인가. 이 자료는 CC BY 4.0 이라 출처를 밝히면 고쳐 써도 됩니다. 넷 가운데 답을 못 찾는 칸이 있다면, 그 칸이 곧 우리 분석이 짊어질 위험입니다.

도해: 원본 8,760행 × 14열이 우리 표 365행 × 7열로 오는 사이에 들어간 손질 셋과, 설명 페이지에서 읽을 넷. · 출처: UCI Machine Learning Repository, Seoul Bike Sharing Demand(CC BY 4.0, DOI 10.24432/C5F62R) — 라이선스 확인 2026-09-22