단원 홈

Ⅱ. 데이터 준비와 분석14차시

한 질문에
스물네 개의 답

선택을 모두 돌려 보고, 보고서에 적는다

두 모둠이 같은 366일로 같은 물음에 답했는데 한쪽은 −22.1%, 다른 쪽은 −74.6%라고 적어 왔습니다. 둘 다 계산 실수는 없습니다. 무엇이 답을 이렇게 벌려 놓았는지 가능한 선택을 모두 돌려 확인하고, 숫자 하나가 아니라 반박당하지 않는 한 문장으로 보고하는 법을 배웁니다.

  • [12데과02-04]
  • [12데과02-02]
  • 50분네 정거장
  • 새 도구itertools.product — 선택을 모두 짝짓는 법
  • 자료10차시가 이은 날씨 + 대여 366행
Ⅱ 단원 지도14 / 14차시
  1. 1
  2. 2
  3. 3
  4. 4
  5. 5
  6. 6
  7. 7
  8. 8
  9. 9
  10. 10
  11. 11
  12. 12
  13. 13
  14. 14

학습 목표

  1. 개념에서

    같은 물음에도 분석 선택마다 다른 답이 나오는 까닭을 방법과 이어서 말할 수 있다.

  2. 손으로

    선택을 모두 돌려 답의 분포를 그리고, 어느 선택이 답을 가장 크게 흔드는지 잴 수 있다.

  3. 확인에서

    숫자 하나 대신 범위 · 대푯값 · 흔드는 선택 · 날 수를 담은 한 문단 보고서를 쓸 수 있다.

1
여는 장면 · 5분

같은 366일, 두 모둠의 답이 세 배 넘게 다르다

10차시에서 우리는 날씨와 따릉이 대여를 날짜로 이어 366행짜리 표 한 장을 만들었습니다. 그 표를 두 모둠에게 똑같이 나눠 주고 같은 물음을 냈습니다 — “비 오는 날 따릉이 이용은 얼마나 줄어드나?”

돌아온 답은 ㄱ 모둠 −22.1%, ㄴ 모둠 −74.6%였습니다. 코드를 펼쳐 한 줄씩 맞춰 보았지만 계산 실수는 양쪽 다 없었습니다. 다른 것은 분석하면서 내린 선택 네 칸뿐이고, 그나마 셋은 같았습니다.

그림 1두 모둠이 고른 길과 그 답같은 표 366행 · 같은 물음
ㄱ 모둠네 칸 가운데 한 칸만 다르다비 온 날0.1mm대푯값중앙값비교 범위15~25°C요일평일만−80−60−40−200비 오는 날 이용 변화(%)−22.1%10차시의 우리 답 −53.2%계산 실수는 없다 — 고른 길이 다를 뿐이다ㄴ 모둠네 칸 가운데 한 칸만 다르다비 온 날5mm대푯값중앙값비교 범위15~25°C요일평일만−80−60−40−200비 오는 날 이용 변화(%)−74.6%10차시의 우리 답 −53.2%계산 실수는 없다 — 고른 길이 다를 뿐이다ㄱ 모둠한 칸만 다르다비 온 날0.1mm대푯값중앙값비교 범위15~25°C요일평일만−80−60−40−200비 오는 날 이용 변화(%)−22.1%10차시의 우리 답 −53.2%계산 실수는 없다 — 고른 길이 다를 뿐이다ㄴ 모둠한 칸만 다르다비 온 날5mm대푯값중앙값비교 범위15~25°C요일평일만−80−60−40−200비 오는 날 이용 변화(%)−74.6%10차시의 우리 답 −53.2%계산 실수는 없다 — 고른 길이 다를 뿐이다

네 칸 가운데 다른 것은 '비 온 날'을 몇 mm부터로 보았나 하나뿐입니다. 그 한 칸이 답을 52.5%p 벌려 놓았고, 10차시에 우리가 얻은 −53.2%는 그 사이 어디쯤에 있습니다. 자료: 10차시가 이은 366행(기상청 ASOS 서울 108 + 서울시 따릉이 대여이력 2024) — 원장 실측

표 1두 모둠의 분석 선택다른 칸은 주황
모둠'비 온 날'의 기준대푯값비교 범위요일답비 온 날
ㄱ 모둠0.1mm 이상중앙값15~25°C평일만−22.1%16일
ㄴ 모둠5mm 이상중앙값15~25°C평일만−74.6%6일

청록 칸 셋은 같고, 주황 칸 하나만 다릅니다. 맨 오른쪽 비 온 날 칸도 눈여겨보세요 — ㄴ 모둠의 −74.6%는 엿새로 낸 답입니다. 자료: 3정거장 코드 ①이 찍는 값과 같다(원장 실측)

먼저 예측

네 칸 가운데 어느 칸이 답을 가장 크게 흔들었을까요? 그리고 네 칸을 모두 바꿔 가며 돌려 보면 답은 몇 개가 되고, 그 답들의 양 끝은 얼마와 얼마일까요? 3정거장에서 실제로 다 돌려 보고 맞대어 봅니다.

체크포인트 1

같은 표 · 같은 물음인데 답이 세 배 넘게 다르고, 다른 것은 분석 선택 한 칸뿐이라는 것을 확인했다.

다음 정거장 · 개념 15분 →
2
개념 · 15분

갈림길 넷, 그리고 스물네 개의 답

2-1한 물음이 스물네 갈래로 갈린다

분석은 갈림길의 연속입니다. 오늘의 물음에서 반드시 정하고 넘어가야 하는 갈림길은 넷이고, 어느 쪽을 골라도 틀린 선택이 아닙니다. 그래서 3 × 2 × 2 × 2 = 24가지 답이 모두 '합리적인 답'이 됩니다.

그림 2한 물음이 갈라지는 길왼쪽은 갈림길 나무 · 오른쪽은 갈림길 넷과 선택지
0.1mm1mm5mm3 × 2 × 2 × 2 = 24물음 하나가 갈림길 넷을 지난다답 24개아직 뒤집혀 있다갈림길 넷 — 어느 하나도 틀린 선택이 아니다그래서 24개가 모두 '합리적인 답'이다비 온 날의 기준×3얼마나 와야 '비 온 날'인가0.1mm 이상1mm 이상5mm 이상대푯값×2하루하루를 한 숫자로 줄이는 법평균중앙값비교 범위×2무엇과 견주나1년 전체15~25°C 인 날만요일×2주말을 넣나 빼나모든 요일평일만3 × 2 × 2 × 2 = 24가지 길0.1mm1mm5mm3 × 2 × 2 × 2 = 24물음 하나가 갈림길 넷을 지난다답 24개아직 뒤집혀 있다갈림길 넷 — 어느 하나도 틀린 선택이 아니다그래서 24개가 모두 '합리적인 답'이다비 온 날의 기준×3얼마나 와야 '비 온 날'인가0.1mm 이상1mm 이상5mm 이상대푯값×2하루하루를 한 숫자로 줄이는 법평균중앙값비교 범위×2무엇과 견주나1년 전체15~25°C 인 날만요일×2주말을 넣나 빼나모든 요일평일만3 × 2 × 2 × 2 = 24가지 길

두 모둠은 이 24갈래 가운데 둘을 걸었을 뿐입니다. 그런데 하필 그 둘이 양 끝이었습니다 — 24개 답은 −74.6%부터 −22.1%까지 52.5%p에 걸쳐 있고, 가운데는 −43.9%, 10차시에 우리가 얻은 답 −53.2%는 센 쪽에서 일곱째입니다(더 크게 준 답이 여섯). 자료: 원장 실측(Pyodide 0.26.4) — 3정거장 코드 ①·②가 찍는 값과 같다

Ⅱ-10 에서 가져옴오늘 쓰는 표는 10차시에서 날씨와 대여를 날짜로 이어 만든 366행 그대로입니다. 그때도 우리는 이 넷을 골랐습니다 — 다만 고른 줄 알지 못한 채 골랐지요.

2-2왜 갈리나 — 결과의 차이를 방법과 잇는다

답이 다르면 먼저 어느 선택이 달랐는지를 찾고, 그다음 그 선택이 데이터에 무슨 일을 했는지로 차이를 설명해야 합니다. 설명이 붙지 않으면 그것은 '다른 답'이 아니라 '알 수 없는 답'입니다.

'비 온 날'의 기준은 세 무리를 만듭니다. 강수량이 0인 날은 '안 온 날', 문턱을 넘은 날은 '비 온 날', 그리고 0보다 크지만 문턱보다 작은 날은 어느 쪽에도 안 셉니다. 문턱을 올릴수록 '비 온 날'에는 제대로 온 비만 남아 줄어든 폭이 커지고, 0.1mm로 내리면 잠깐 뿌린 날까지 섞여 효과가 옅어집니다.

규칙답이 다르면 어느 선택이 달랐는지와 그 선택이 데이터에 한 일을 한 문장으로 함께 적는다.

그림 3기준 하나가 답을 이만큼 움직인다왼쪽은 답의 평균 · 오른쪽은 그 까닭
답의 평균이 이만큼 움직인다기준마다 24개 가운데 여덟 답의 평균−60%−50%−40%−30%0.1mm−34.3%1mm−45.0%5mm−59.2%24.9%p나머지 세 갈림길은 3정거장에서 직접 잰다왜 기준이 답을 가르나문턱 하나가 366일을 세 무리로 나눈다안 온 날 0mm비 온 날가운데 회색 — 어느 쪽에도 안 세는 날0.1mm 이상 — 잠깐 뿌린 날까지 '비 온 날'에 넣어 효과가 옅어진다1mm 이상 — 어느 정도 온 날부터 센다5mm 이상 — 제대로 온 날만 남아 줄어든 폭이 커진다0.1151020300하루 강수량(mm) — 제곱근 눈금답의 평균이 이만큼 움직인다기준마다 24개 가운데 여덟 답의 평균−60%−50%−40%−30%0.1mm−34.3%1mm−45.0%5mm−59.2%24.9%p나머지 세 갈림길은 3정거장에서 직접 잰다왜 기준이 답을 가르나문턱 하나가 366일을 세 무리로 나눈다안 온 날 0mm비 온 날가운데 회색 — 어느 쪽에도 안 세는 날0.1mm 이상 — 잠깐 뿌린 날까지 '비 온 날'에 넣어 효과가 옅어진다1mm 이상 — 어느 정도 온 날부터 센다5mm 이상 — 제대로 온 날만 남아 줄어든 폭이 커진다0.1151020300하루 강수량(mm) — 제곱근 눈금

기준마다 여덟 답의 평균은 0.1mm −34.3% · 1mm −45.0% · 5mm −59.2%로 24.9%p나 벌어집니다. 나머지 세 갈림길이 얼마나 흔드는지는 3정거장에서 직접 재어 봅니다. 자료: 원장 실측 — 코드 ③이 찍는 값과 같다

2-3다중 분석 — 하나만 고르지 말고 모두 돌린다

갈림길마다 하나씩 골라 답 하나를 내는 대신, 가능한 길을 모두 걸어 보고 답의 분포를 보는 것을 다중 분석(multiverse analysis — Steegen 등, 2016)이라고 합니다. 답이 한 덩어리로 모이면 그 결론은 선택에 덜 휘둘리는 결론이고, 넓게 흩어지면 '선택이 곧 결론'인 셈이라 숫자 하나로는 보고할 수 없습니다.

선택을 모두 돌리면 좋은 점이 하나 더 있습니다. 선택지마다 답의 평균을 내어 견주면 어느 갈림길이 답을 가장 크게 흔드는지가 드러납니다. 흔드는 갈림길은 보고서에 꼭 적어야 하고, 거의 안 흔드는 갈림길도 적어야 합니다 — 무엇을 재어 보았는지가 곧 근거이기 때문입니다.

규칙답이 하나가 아닐 수 있으면 모두 돌려 분포를 보고, 숫자 하나가 아니라 범위로 보고한다.

답 24개아직 뒤집혀 있다
가장 센 답 −74.6%가장 약한 답 −22.1%

하나하나가 어디에 서 있는지는 3정거장 시뮬레이터에서 연다.

그림이 없을 때도 두 숫자를 나란히 놓으면 보고서가 빠뜨린 것이 보입니다. 같아야 할 것 같은 두 숫자가 다르면, 그 차이가 곧 고른 손의 흔적입니다.

10차시의 답 · 24개의 가운데
−53.210차시의 답(%)
vs
−43.924개의 가운데(%)

우리가 걸은 길은 센 쪽이었다 — 더 크게 준 답이 여섯.

답 하나가 쓴 날 수
1100.1mm · 1년 전체 · 모든 요일(일)
인데
6ㄴ 모둠의 답(일)

같은 366일인데 근거로 쓴 날은 18배가 넘게 차이 난다.

'비 안 온 날'을 어떻게 셀까
256강수량이 0인 날
vs
206강수 계속시간까지 0(일)

우리가 세지 않은 다섯째 갈림길이 여기 있다(Ⅱ-4).

자료: 위 세 쌍의 숫자는 모두 원장이 실측한 값이고, 3정거장 코드 ① · ②와 시뮬레이터가 같은 값을 찍는다.

2-4보고서에 적는 네 가지

답이 24개라는 사실을 알고 나면 보고서 문장이 달라집니다. 숫자 하나로 적으면 “나는 24개 가운데 하나를 골랐고, 어느 것을 골랐는지는 말하지 않겠다”는 뜻이 되기 때문입니다.

특히 조심할 것이 날 수입니다. 가장 놀라운 답일수록 가장 얇은 칸에서 나오기 쉽습니다 — 조건을 좁힐수록 남는 날이 줄고, 날이 적으면 몇 사람의 하루가 답을 통째로 흔들기 때문입니다.

보고서에 적는 네 가지 — 순서대로

  1. 범위답이 어디부터 어디까지인가 — 숫자 하나가 아니라 두 끝
  2. 대푯값그 가운데 어디를 대표로 쓰나 — 그리고 내가 고른 길은 어디쯤인가
  3. 흔드는 선택어느 갈림길이 답을 가장 크게 흔들었나 — 거의 안 흔든 것도 함께
  4. 날 수그 답이 몇 날로 만들어졌나 — 얇은 칸은 믿음이 낮다고 적는다

이 넷을 한 문장에 담으면 반박당하지 않는 문장이 됩니다. 3정거장의 시뮬레이터가 바로 그 문장을 짓는 일을 시킵니다 — 24개의 답이 심사위원으로 나옵니다.

체크포인트 2

갈림길이 넷이라 답이 24개라는 것, 기준 하나가 답을 24.9%p 움직인다는 것, 보고서에 적을 네 가지를 말할 수 있다.

다음 정거장 · 손으로 20분 →
3
손으로 · 20분

스물네 개를 다 돌려 보고, 반박당하지 않는 한 문장을 쓴다

오늘의 장비

itertools.product — 선택을 모두 짝지어 한 번에 돌린다

지금까지는 선택을 하나씩 정해 답 하나를 냈습니다. 오늘은 선택지를 목록으로 적어 두고 모든 짝을 자동으로 만들어 답을 표로 모읍니다. 코드 ②는 matplotlib을 쓰므로 처음 실행이 몇 초 멈춥니다 — 고장이 아니라 그림 도구와 한글 글꼴을 받는 중이에요(쪽마다 한 번).

부르는 모양

import itertools

CHOICES = {"비 기준": ["0.1mm", "1mm"],
           "대푯값": ["평균", "중앙값"]}
for c in itertools.product(*CHOICES.values()):
    print(c)   # 네 짝이 차례로

오늘 쓰는 함수 넷

itertools.product
목록 여럿의 *values()를 모두 짝짓는다
dict(zip(…))
이름과 값을 다시 묶어 한 줄로
sort_values
답을 크기순으로 세운다
groupby(…).mean()
선택지마다 답의 평균

앞 도구와 다른 셋

  1. 답이 표가 된다숫자 하나가 아니라 24줄짜리 DataFrame
  2. 선택이 코드 밖으로CHOICES만 고치면 돌아가는 길이 바뀐다
  3. 갈림길 하나 = ×2선택을 하나 더하면 답이 두 배가 된다

대가 — 답이 24개가 되면 그중 무엇을 보고할지가 새 문제로 남습니다.

1

반박당하지 않는 한 문장을 짓는다 — 24개의 답이 심사한다

6분

여는 장면에 적어 둔 내 예측입니다. 이제 문장부터 지어 봅니다 — 답을 보기 전에 “비 오는 날 이용은 ○%에서 ○% 사이로 줄었다”의 빈칸 둘을 먼저 채우는 것입니다.

아래 판에서 띠(문장이 약속한 범위)를 끌어 놓고, 문장을 가장 좁힐 것 같은 칩(문장을 갈림길마다 여러 줄로 쪼개는 조각)을 하나 골라 예측을 잠급니다. [심판]을 누르면 뒤집혀 있던 답 24장이 제 줄의 자 위로 떨어집니다 — 띠 밖에 떨어진 답이 반박입니다. 도전 셋을 풀면 카드가 스스로 닫힙니다.

시뮬레이터

반박당하지 않는 한 문장

문장을 먼저 짓는다 — 숨어 있던 24개의 답이 심사하러 온다

  1. 1자 위의 띠를 끌어 문장의 범위를 정한다
  2. 2가장 좁힐 것 같은 칩을 하나 골라 예측을 잠근다
  3. 3[심판] — 답 24장이 떨어진다. 칩으로 쪼개 반박을 없앤다
① 예측 — 문장을 가장 좁힐 칩
② 예측 잠금
③ 심판
④ 문장 쪼개기 — 칩은 둘까지
문장 한 줄 — 아직 쪼개지 않았다띠를 끌어 범위를 정하고, 가장 좁힐 것 같은 칩을 고른다

반박 = 그 줄의 답 타일이 그 줄의 띠 밖에 떨어진 것 · 평균 폭 = 줄마다 띠의 폭을 답 24개에 고르게 나눠 평균 낸 값(줄이 하나면 그 띠의 폭)

목표 — 2단계: 칩 하나 · 반박 0 · 평균 폭 25%p 이하 / 3단계: 칩 둘 · 반박 0 · 평균 폭 15%p 이하. 얇은 답이 든 줄은 조항을 켜면 문장 끝에 경로와 날 수가 붙는다(문장이 길어지는 대가)

반박—개
평균 폭(%p)80.0
띠 안에 든 답—
문장 줄1
얇은 답4개
단계1
도전 1

칩 하나로 반박 0 · 평균 폭 25%p 이하를 만들어라 — 넷 가운데 하나만 문장을 절반 아래로 좁힌다.

도전 2

칩 둘로 반박 0 · 평균 폭 15%p 이하까지 좁혀라. 얇은 답이 든 줄이 생기면 조항을 켜서 문장 끝에 날 수를 붙여라.

도전 3

네 칩을 하나씩 다 걸어 보고, 답을 가장 적게 가르는 칩을 찾아라 — 두 줄의 띠가 거의 같은 자리에 서는 칩이다.

자료: 10차시가 이은 ../data/merged_daily_2024.csv 366행(날짜 · 기온 · 강수량 · 강수시간 · 대여건수) 전부를 쪽 안에 실었다 — 기상청 종관기상관측(ASOS) 서울(108) 2024 + 서울시 따릉이 대여이력 2024 일별 집계. 기상청 제공 · 서울열린데이터광장. 24개 답은 판이 이 366행에서 그 자리에서 계산하므로 코드 ① ~ ③의 출력과 소수점까지 같다.

내 문장이 반박당하지 않으려면 범위를 잡아야 했다. 그런데 칩으로 쪼개자 같은 반박 0에서도 폭이 %p 까지 줄었다 — 문장이 길어진 대신 라는 것이 드러났기 때문이다.

확인 문제 5의 여는 말 칸에 완성한 문장을 옮겨 적기 →
2

스물네 개의 답 — 선택을 모두 돌린다

3분

판이 심판에 쓴 24개와 같은 값이 나올까요? 코드를 돌리기 전에 한 번 더 짐작해 두세요 — 24개 답의 양 끝은 얼마와 얼마이고, 두 모둠의 답 차이를 설명할 선택은 넷 가운데 어느 것일까요?

기본 빈칸 ①에 평일만 남기는 조건을, 빈칸 ②에 '몇 % 변했나'로 바꾸는 수를 채우고 ▶ 실행합니다. CHOICES의 네 목록이 itertools.product로 24짝이 되는 자리를 눈여겨보세요.

도전 CHOICES의 "비 기준"에 "10mm"를 더하면 답이 32개가 됩니다. 양 끝이 더 벌어질까요? — 실측은 −74.6 ~ −22.1%로 그대로입니다. 새로 생긴 여덟 답이 모두 −74.6 ~ −49.5% 안에 들어오거든요. 폭은 안 벌어지고 얇은 답만 늡니다(4 → 8개).

탐구 다섯째 갈림길을 하나 더 만든다면 답은 몇 개가 되고, 그 선택이 답을 흔들까요? 보기: '비 안 온 날'을 강수량 0인 256일로 볼까, 강수시간까지 0인 206일(정말 비가 없던 날)로 볼까 — 답은 48개가 되지만 흔들림은 평균 1.4%p뿐입니다(가장 크게 흔들린 답도 3.6%p). 거의 안 흔드는 선택도 보고서에 적어야 하는 까닭을 함께 적어 보세요.

“비 오는 날 이용은 % 준다”라고 숫자 하나만 적으면 라는 사실과 라는 사실이 함께 빠진다.

확인 문제 1에 적어 제출 →
3

답의 분포 — 10차시의 답은 어디쯤인가

1분

10차시에서 얻은 답(1mm · 중앙값 · 15~25°C · 모든 요일)은 24개 가운데 어디쯤일까요 — 가운데? 약한 쪽? 센 쪽? 히스토그램을 보기 전에 한쪽을 골라 두세요.

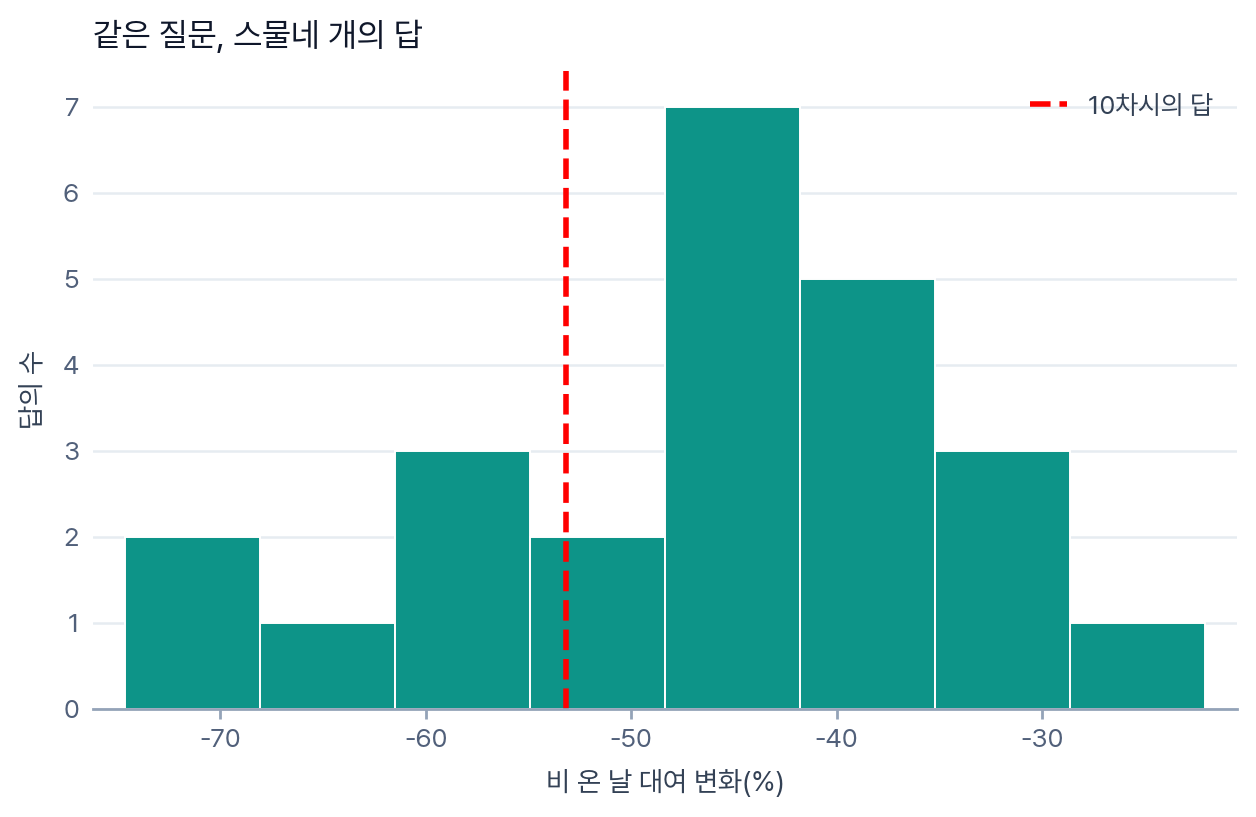
기본 코드 ②는 채워져 있습니다. 그대로 ▶ 실행해 24개의 분포와 빨간 점선(10차시의 답)이 어디에 서는지 보세요. 처음 실행은 몇 초 멈춥니다.

도전 bins를 8에서 12로 바꿔 보세요 — 몰린 자리가 그대로인가요? (8개 [2,1,3,2,7,5,3,1] → 12개 [2,0,1,2,2,1,4,3,5,3,0,1] — 꼭대기가 한 칸 오른쪽으로 옮겨 갑니다. 6차시의 구간 폭 이야기가 여기서도 같습니다.)

탐구 보고서에 그림을 한 장만 싣는다면 이 분포 그림과 '10차시의 답 하나'를 그린 막대 가운데 어느 쪽을 고르겠습니까? 고른 까닭과, 그 그림이 읽는 사람에게 감추는 것을 함께 적어 보세요(Ⅱ-7).

10차시의 답은 분포의 에 있다. 그리고 우리가 세지 않은 때문에 답이 %p 움직였으므로, 보고서에 라고 적는다.

확인 문제 3에 적어 제출 →
4

어느 선택이 답을 흔드나 — 그리고 한 문단 보고서

10분

네 갈림길(비 기준 · 대푯값 · 기온 · 요일) 가운데 답을 가장 크게 흔드는 것은 무엇일까요? 그리고 가장 적게 흔드는 것은? 시뮬레이터에서 찾은 칩과 같은지 맞대어 봅니다.

기본 빈칸 ③에 '선택지마다 24개 답의 평균'을 내는 함수 이름을 채우고 ▶ 실행합니다. 아래쪽에 비 온 날이 15일도 안 되는 답 목록도 함께 찍힙니다 — 조항 스위치가 떼어 낸 바로 그 답들입니다.

도전 마지막 블록의 15를 30으로 바꾸면 '얇은 답'이 몇 개로 늘어날까요? (4개 → 12개, 곧 24개의 절반입니다.) 얇음의 문턱도 우리가 정하는 선택이라는 뜻입니다.

탐구 답의 폭을 줄이는 길은 둘입니다 — 선택을 하나로 정해 버리기와 선택을 모두 보고하기. 어느 쪽이 정직한가요? 까닭과 함께 적어 보세요.

'비 기준'이 답을 가장 크게 흔든 까닭은 이기 때문이다. 비 온 날이 15일도 안 되는 답은 보고서에 라고 적는다. 내 한 문단 보고서의 여는 말은 이다.

확인 문제 2 · 4에 적어 제출 →

그다음 확인 문제 5의 표 여섯 칸을 채워 한 문단 보고서를 완성합니다. 여는 말은 시뮬레이터가 넘긴 문장에서 시작하므로, 새로 쓰는 것은 데이터 · 고른 까닭 · 한계입니다.

체크포인트 3

선택을 모두 돌려 24개의 답을 손에 넣었고, 어느 선택이 답을 흔드는지 재었고, 반박당하지 않는 문장으로 보고서의 여는 말을 지었다.

다음 정거장 · 정리·확인 10분 →
4
정리·확인 · 10분

오늘의 탐험 일지

  1. 찾은 것

    같은 366일 · 같은 물음인데 합리적인 선택만 바꿔도 답이 −74.6%에서 −22.1%까지 52.5%p에 걸쳐 있었다.

  2. 도구의 한계

    코드는 고른 길을 말해 주지 않는다. 선택을 코드 밖에 적어 두고 모두 돌려야 비로소 보인다.

  3. 보고의 규칙

    숫자 하나 대신 범위 · 대푯값 · 가장 흔드는 선택 · 날 수 넷을 적는다. 얇은 칸은 믿음이 낮다고 밝힌다.

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. 24개 답이 −74.6%에서 −22.1%까지 넓게 벌어졌다. 그런데도 “비 오는 날 이용은 ○% 준다”라고 숫자 하나만 쓰면 무엇이 빠지는지 쓰시오.
📖 모범 답안

셋이 빠진다. ① 범위 — 선택에 따라 답이 −74.6%에서 −22.1%까지(52.5%p) 달라진다는 사실. ② 어느 선택이 흔드는가 — 여기서는 '비 온 날'의 기준이 25%p로 압도적이고 나머지 셋은 3~7%p다. ③ 내가 고른 길 — '비 온 날'을 몇 mm부터로 보았고, 대푯값·비교 범위·요일을 어떻게 정했는가.

숫자 하나만 적는 것은 “24개 가운데 하나를 골랐는데 어느 것을 골랐는지는 말하지 않겠다”는 뜻이 된다. 읽는 사람은 그 숫자가 24개 가운데 가장 센 것인지 가운데인지 알 길이 없다.

2. '비 기준'이 답을 가장 크게 흔들었다(선택지마다 24개 답의 평균 폭 25%p — 나머지 셋은 3~7%p). 그 까닭을 방법과 이어서 쓰시오. 그리고 폭이 3%p뿐이었던 '요일'도 보고서에 적어야 하는지, 적어야 한다면 왜 그런지 쓰시오.
📖 모범 답안

기준을 올릴수록 '비 온 날' 무리에 제대로 온 비만 남기 때문이다. 5mm 기준이면 하루 5mm 넘게 온 날만 남아 대여가 크게 줄어든 날들이 모이고(여덟 답의 평균 −59.2%), 0.1mm 기준이면 잠깐 뿌리고 만 날까지 '비 온 날'에 섞여 효과가 옅어진다(−34.3%). 1mm는 그 사이(−45.0%)다. 곧 이 선택은 '비'라는 말의 뜻을 바꾸는 선택이라 다른 셋(대푯값 · 비교 범위 · 요일)보다 훨씬 크게 흔든다.

요일도 적어야 한다. 폭이 3%p라는 것은 “이 선택은 결론을 바꾸지 않는다”는 발견이지 “재 보지 않았다”가 아니다. 읽는 사람이 “주말을 빼면 달라지지 않나요?”라고 물었을 때, 재어 보았고 2.9%p밖에 안 움직였다고 답할 수 있는 것이 근거다. 적지 않으면 그 물음이 그대로 남는다.

3. 10차시가 찍은 값은 −52%인데 오늘 같은 길(1mm · 중앙값 · 15~25°C · 모든 요일)로 다시 재니 −53%였다. 까닭을 쓰고, 이런 세지 않은 갈림길을 보고서에 어떻게 다룰지 쓰시오. 또 24개 가운데 가장 극적인 답만 골라 기사 제목에 쓰는 일이 왜 문제인지 쓰시오.
📖 모범 답안

'비 안 온 날'을 무엇으로 보았는지가 다르다. 10차시는 1mm 미만인 날(94일)을, 오늘은 강수량이 0인 날(89일)을 '안 온 날'로 잡았다. 나누는 쪽(비 온 날)은 같은데 나뉘는 쪽이 달라져 1%p가 움직였다. 우리가 갈림길로 세지도 않았던 선택이 답을 옮긴 것이다.

다루는 법: 이런 선택도 갈림길 목록에 올려 돌려 본다. 실제로 '안 온 날'을 강수량 0인 256일로 볼지 강수 계속시간까지 0인 206일로 볼지를 다섯째 갈림길로 넣으면 답은 48개가 되지만 흔들림은 평균 1.4%p(가장 큰 것도 3.6%p)다. 거의 안 흔든다는 것까지가 결과이므로 그 사실을 보고서에 적는다.

체리피킹이다. 24개를 다 본 뒤 가장 놀라운 −74.6%를 고르면, 그 숫자는 '데이터가 말한 것'이 아니라 '내가 고른 것'이 된다. 결과를 보고 선택을 정하면 우연·편향이 발견처럼 보인다. 게다가 −74.6%는 비 온 날이 엿새뿐인 얇은 칸의 답이라 가장 흔들리기 쉬운 답이기도 하다. 선택은 결과를 보기 전에 정해 두고, 보고할 때는 폭을 함께 적는다.

4. 24개 가운데 비 온 날이 15일도 안 되는 답은 넷(6 · 6 · 11 · 11일)이고, 가장 극적인 −74.6%가 그중 하나다. ① 이런 답을 보고서에 어떻게 적어야 하는지, ② 시뮬레이터에서 그 답을 홀수 날 · 짝수 날로 갈라 다시 잰 두 값이 무엇을 보여 주었는지, ③ 날 수를 늘리려면 무엇을 할 수 있는지 쓰시오.
📖 모범 답안

① 답과 함께 날 수를 적고, 믿음이 낮다고 밝힌다. 예: “5mm 이상 · 15~25°C · 평일만으로 보면 −74.6%였으나 이 값은 비 온 날 엿새로 낸 것이라 믿음이 낮다.” 본문의 대표 숫자로 쓰지 않고 따로 적는다. '얇다'의 문턱(여기서는 15일)도 우리가 정한 선택이므로 함께 밝힌다 — 문턱을 30일로 올리면 얇은 답이 12개, 곧 절반이 된다.

② 같은 자료를 반으로만 갈라도 답이 크게 움직였다. −74.6%(엿새)를 날짜의 홀·짝으로 가르면 홀수 날 −65.4%(하루) / 짝수 날 −76.4%(닷새)가 된다. 더 극적인 것은 −56.6%(열하루)로, 홀수 날 −16.2%(나흘) / 짝수 날 −73.0%(이레) — 57%p 차이다. 홀·짝은 비와 아무 상관이 없는 가르기인데도 이만큼 갈린다는 것은, 그 답의 정밀함이 날 수에서 온 것이지 자연에서 온 것이 아니라는 뜻이다.

③ 다른 해의 자료를 더한다(2024년만이 아니라 여러 해), 조건을 덜 좁힌다(15~25°C · 평일만 대신 1년 전체), 기준을 낮춘다(5mm → 1mm). 어느 쪽도 공짜가 아니다 — 날 수를 얻는 대신 '비슷한 날끼리 견준다'는 이점을 잃는다. 그래서 무엇을 얻고 무엇을 잃었는지까지 보고서에 적는다.

5. 오늘의 분석을 한 문단 보고서로 적으시오. 아래 여섯 칸을 채운 뒤, 아래 답 칸에 그것을 이어 한 문단으로 쓰면 됩니다. 여는 말은 시뮬레이터에서 완성한 '반박당하지 않는 문장'을 옮겨 적으세요.
칸내가 쓸 말
여는 말(범위)
물음
데이터
고른 기준과 까닭
가장 흔드는 선택
한계(날 수 포함)
📖 모범 답안

(보기) 비 오는 날 서울 따릉이 이용은 −74.6%에서 −22.1% 사이로 줄었다. '비 오는 날 이용이 얼마나 줄어드는가'를 묻기 위해 2024년 366일의 기상청 서울 관측값과 따릉이 일별 대여 건수를 날짜로 이어 썼다. 분석에는 갈림길이 넷 있었다 — '비 온 날'의 기준(0.1 · 1 · 5mm), 대푯값(평균 · 중앙값), 비교 범위(1년 전체 · 15~25°C), 요일(전체 · 평일만). 24가지를 모두 돌린 결과 답은 위 범위에 걸쳐 있었고 가운데는 −43.9%였다. 우리는 1mm 이상을 '비 온 날'로 보았는데, 0.1mm는 잠깐 뿌린 날까지 섞이고 5mm는 남는 날이 너무 적어 그 사이를 골랐다(그 길의 답은 −53.2%). 답을 가장 크게 흔든 선택은 '비 온 날'의 기준으로 선택지마다 답의 평균이 25%p 차이 났고(0.1mm −34.3% / 1mm −45.0% / 5mm −59.2%), 기온 7 · 대푯값 5 · 요일 3%p는 거의 흔들지 않았다. 한계: 24개 가운데 넷은 비 온 날이 15일도 안 되는 칸에서 나온 답이라(6 · 6 · 11 · 11일) 믿음이 낮다. 특히 가장 극적인 −74.6%는 엿새로 낸 값이고, 그 엿새를 날짜의 홀·짝으로 갈라 다시 재면 −65.4%와 −76.4%로 갈린다. 또 '비 안 온 날'을 강수량 0인 날(256일)로 볼지 강수 계속시간까지 0인 날(206일)로 볼지도 선택이었는데, 이것은 답을 평균 1.4%p밖에 옮기지 않았다.

채점 눈 — 여는 말이 숫자 하나가 아니라 범위인가 / 데이터의 출처와 행 수가 있는가 / 고른 기준에 까닭이 붙어 있는가 / 가장 흔드는 선택과 그 폭(%p)이 있는가 / 한계에 날 수가 들어 있는가. 다섯 가운데 넷 이상이면 좋은 보고서다.

+
더 알아보기

같은 자료, 다른 답 — 바깥세상의 이야기 셋

29개 팀의 효과 크기(승산비)같은 자료 · 같은 물음 — 답은 0.89 ~ 2.93있다20팀뚜렷하지 않다9팀1231.0 — 차이 없음
현장

29개 팀에게 같은 데이터를 주었더니

2018년 라파엘 실버잔과 에릭 울만은 실험을 하나 했습니다. 프로 축구 경기 기록 한 벌을 29개 분석팀에게 똑같이 나눠 주고 같은 물음을 냈습니다 — “심판은 피부색이 짙은 선수에게 레드카드를 더 주는가?” 팀마다 자기 방식대로 분석하고, 서로의 방법을 익명으로 검토한 뒤 최종 답을 냈지요.

답은 하나로 모이지 않았습니다. 효과 크기(승산비)가 0.89에서 2.93까지 벌어졌고, 20팀은 “차이가 있다”, 9팀은 “뚜렷하지 않다”고 결론지었습니다. 틀린 팀을 찾을 수는 없었습니다. 팀마다 어떤 변수를 통제할지, 어떤 모형을 쓸지를 다르게 골랐을 뿐이니까요. 오늘 우리가 24갈래를 걸어 본 것과 같은 일이 진짜 연구에서 일어난 것입니다. 그래서 이 실험 뒤로 여러 팀이 같은 데이터를 분석해 보는 방식이 하나의 연구 방법이 되었습니다.

도해: 29개 팀의 추정치와 구간을 큰 것부터 줄 세웠다. 양 끝(0.89 · 2.93)과 20팀 대 9팀은 논문의 값이고, 가운데 스물일곱 줄의 자리는 모양을 보이기 위한 예시다. · 출처: R. Silberzahn et al., “Many Analysts, One Data Set”, AMPPS 1(3), 2018

합계 범위가 다섯 줄 모자라게 잡혔다나라성장률✕✕✕✕✕합계에 든열한 줄범위 밖으로빠진 다섯 줄−0.1%2010년 발표→2.2%2013년 다시 계산같은 표, 같은 물음 — 달라진 것은 합계 범위 한 줄
역사

스프레드시트 한 칸이 나라 살림을 흔든 일

2010년 경제학자 카먼 라인하트와 케네스 로고프는 국가부채가 GDP의 90%를 넘는 나라들의 평균 성장률을 −0.1%로 발표했습니다. “부채가 90%를 넘으면 성장이 멈춘다”는 문장은 여러 나라의 긴축 정책을 뒷받침하는 근거로 쓰였지요.

2013년 대학원생 토머스 헌든이 같은 계산을 다시 해 보다가 답이 맞지 않는 것을 발견했습니다. 원본 스프레드시트를 받아 보니 평균을 내는 합계 범위가 다섯 줄 모자라게 잡혀 있었고, 나라마다 자료 햇수가 다른데 이를 어떻게 평균 낼지에 대한 선택도 결과를 크게 바꾸고 있었습니다. 바로잡은 값은 2.2% — 부호가 뒤집혔습니다. 여기서 중요한 것은 '실수'가 아니라, 원본 자료와 계산 과정이 공개되었기에 되짚을 수 있었다는 점입니다.

도해: 합계 범위가 몇 줄 모자라게 잡힌 스프레드시트를 모식도로 그렸다(줄 수는 모양을 보인 예시). −0.1%와 2.2%는 발표된 값이다. · 출처: T. Herndon, M. Ash, R. Pollin, Cambridge Journal of Economics 38(2), 2014

① 먼저 적고 나서 본다분석 계획서→데이터→분석고를 수 있는 답이 24개라도, 어느 것을 쓸지는 이미 정해져 있다② 보고 나서 적는다데이터→분석 24가지→계획서24개 가운데 가장 마음에 드는 답을 고른 뒤 '처음부터 그러려 했다'고 적는다고른 하나만 보고서에 실으면, 나머지 스물셋은 아무도 모른다
방법 더 깊이

선택을 결과보다 먼저 적어 두기

24갈래를 다 돌려 보는 것은 정직한 방법이지만 늘 할 수 있는 일은 아닙니다. 그래서 의학과 심리학에서는 다른 길을 씁니다 — 사전 등록(pre-registration)입니다. 데이터를 보기 전에 “이렇게 분석하겠다”를 공개된 곳에 등록해 두고, 그 뒤에 데이터를 여는 것이지요. 임상시험은 이것이 의무여서, 등록하지 않은 시험 결과는 주요 학술지가 싣지 않습니다.

순서만 바꾸는 일인데 효과가 큽니다. 결과를 본 뒤에 계획을 적으면 마음에 드는 답이 나오는 길을 고르게 되고, 그 길을 “처음부터 그러려 했다”고 쓰게 되니까요. 우리 프로젝트에서도 흉내 낼 수 있습니다 — 분석을 시작하기 전에 분석 계획서를 한 쪽 적어 두는 것입니다. Ⅳ단원에서 실제로 써 보게 됩니다.

도해: 두 순서를 나란히 그렸다 — ① 계획서 → 데이터 → 분석, ② 데이터 → 24가지 분석 → 계획서. 아래 타일 24장 가운데 하나만 칠해진 것이 ②에서 일어나는 일이다.