요약 숫자(평균 · r · R² · 기울기)가 말하지 않는 것을 들고, 잔차의 무늬로 '직선이라는 모양 가정'을 검사할 수 있다.
손으로
LinearRegression 의 잔차를 구해 부호열과 구간별 잔차 평균을 읽고, 직선이 체계적으로 틀리는 기온대를 짚을 수 있다.
확인에서
이 직선을 쓰면 안 되는 자리(틀리는 기온대 · 날 수가 적은 구간 · 관측 범위 밖)를 근거와 함께 적을 수 있다.
1
여는 장면 · 5분
보고서 넉 장이 왔는데, 숫자가 한 글자도 다르지 않다
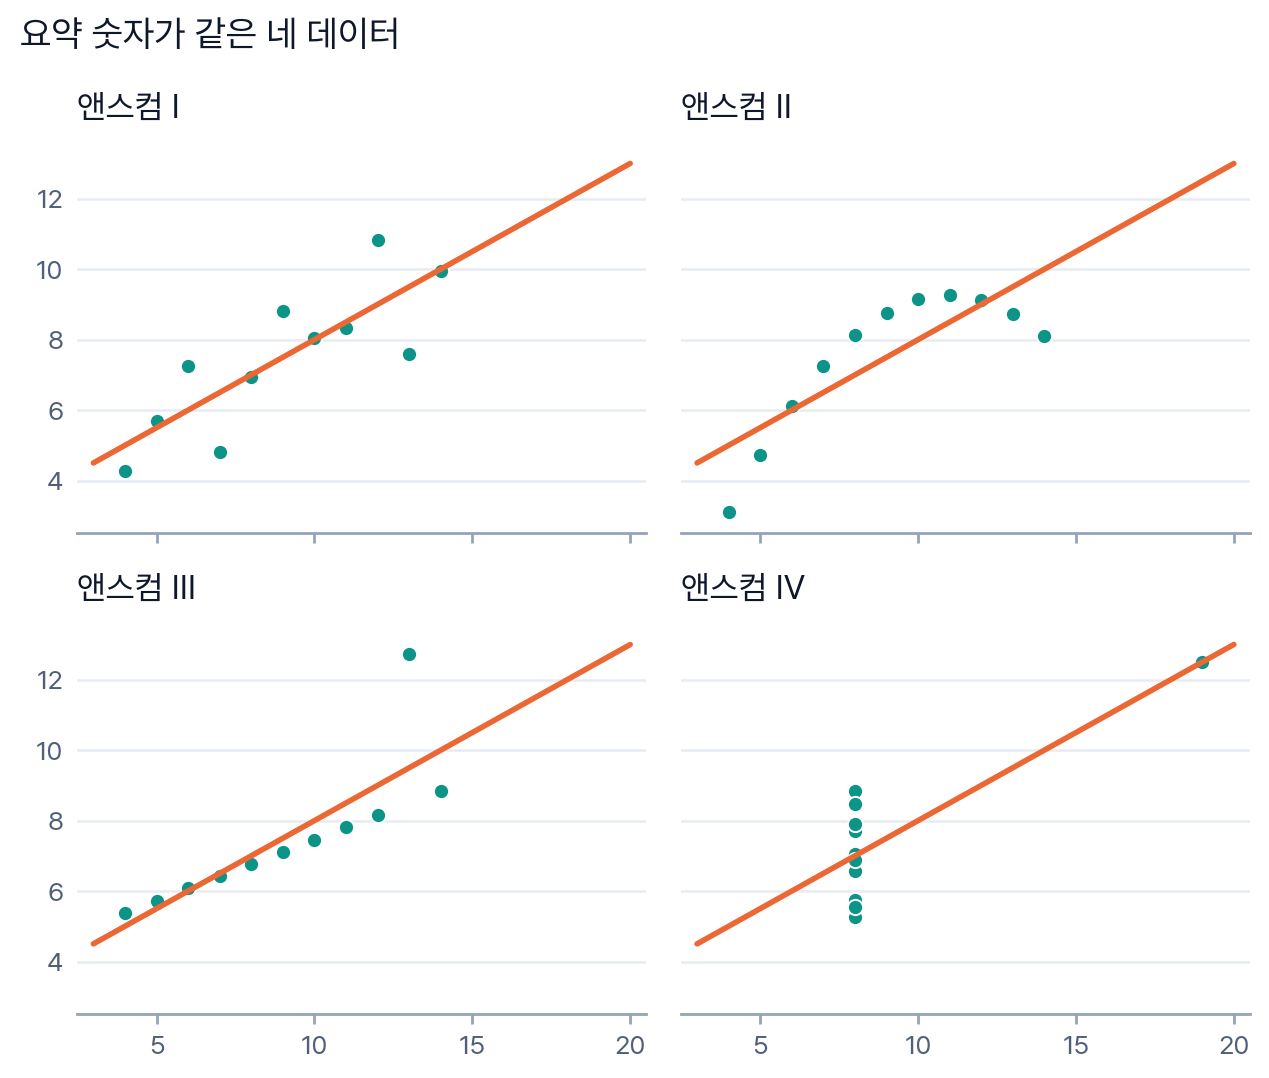
어느 연구실에 조사 보고서가 넉 장 들어왔습니다. 네 팀이 각각 11번씩 측정해서
x 와 y 를 적어 왔고, 팀마다 요약 숫자를 계산해 두었습니다.
받아 든 사람이 넉 장을 나란히 놓고 보니 — 평균도, 상관계수도, 회귀 직선의 기울기와 절편도
소수 셋째 자리까지 같았습니다.
3차시에서 우리는 LinearRegression 이 손으로 푼 공식과 같은 직선을 낸다는 것을 확인했습니다.
그 도구에 네 데이터를 차례로 넣어 보면 어떨까요? 넷 모두 경고 한 줄 없이 같은 직선을 내놓습니다.
도구는 "이 데이터에는 직선이 맞지 않습니다" 같은 말을 하지 않습니다 — 모양을 묻지 않기 때문입니다.
그러니 물음은 이렇게 됩니다. 이 넉 장은 같은 데이터인가?
그리고 같지 않다면, 요약 숫자가 아니라 무엇을 보아야 그것을 알 수 있나?
표 1넉 장의 요약표 — 모양 칸은 가려 두었다Ⅰ · Ⅱ · Ⅲ · Ⅳ · 각 11점
데이터
x 평균
y 평균
기울기
절편
r
R²
모양
앤스컴 Ⅰ
9.00
7.50
0.500
3.000
0.816
0.667
가려 둠
앤스컴 Ⅱ
9.00
7.50
0.500
3.001
0.816
0.666
가려 둠
앤스컴 Ⅲ
9.00
7.50
0.500
3.002
0.816
0.666
가려 둠
앤스컴 Ⅳ
9.00
7.50
0.500
3.002
0.817
0.667
가려 둠
네 줄에서 다른 자리는 절편의 소수 셋째 자리와 r 의 소수 셋째 자리뿐입니다
(3.000 ~ 3.002 · 0.816 ~ 0.817). 반올림해서 적었다면 네 줄은 글자 하나 다르지 않았을 것입니다.
자료: F. J. Anscombe(1973), Graphs in Statistical Analysis, The American Statistician 27(1) 의 표 —
브라우저에서 LinearRegression 으로 다시 맞춘 값(원장 실측)
먼저 예측
그림은 아직 가려 둡니다. 요약 숫자만 보고 네 데이터가 같은 모양인지 한 문장으로 적어 보세요.
그리고 아래 빈 축 넉 장에 네 데이터의 모양을 공책에 한 장씩 그려 두세요 —
주황 점선이 네 데이터가 함께 가진 직선(y = 3.00 + 0.500 x)입니다.
3정거장 미션 ①에서 여러분의 그림과 실제를 맞대어 봅니다.
LinearRegression().fit(x, y) 는 x 와 y 를 받아 오차 제곱합이 가장 작은 직선을 찾습니다.
3차시에서 우리가 손으로 푼 그 공식입니다. 이 계산에는 "이 점들이 직선을 이루는가"를 묻는 단계가
처음부터 들어 있지 않습니다. 그래서 휜 데이터를 넣어도, 한 점이 나머지를 끌고 있는 데이터를 넣어도
도구는 조용히 직선 하나를 돌려줍니다. 경고는 0줄입니다.
이것이 3차시의 '도구가 대신해 주는 것과 숨기는 것' 이야기의 뒷면입니다.
도구는 계산을 대신해 주지만, 그 계산이 맞는 자리인지 묻는 일은 대신해 주지 않습니다.
그 일을 하는 사람이 분석가이고, 그때 쓰는 재료가 잔차입니다.
낱말잔차 = 실제 값 − 직선이 내놓은 값.
잔차가 + 면 그날(그 점)은 직선보다 위에 있고, − 면 아래에 있습니다.
잔차 하나하나는 '얼마나 틀렸나'를 말하고, 잔차를 차례대로 늘어놓은 무늬는 '어디서 틀렸나'를 말합니다.
2-2잔차의 부호를 x 순서대로 늘어놓으면
잔차의 크기를 잠시 접어 두고 부호만 봅니다. x 가 작은 점부터 큰 점까지 차례로 세워
+ 인지 − 인지 적으면, 점 11개가 + 와 − 열한 칸이 됩니다. 직선이 맞는 모양이라면
+ 와 − 가 무늬 없이 섞여 있어야 합니다. 한쪽으로 몰려 있다면, 그 자리에서 직선이 체계적으로 틀린다는 뜻입니다.
그림 1같은 직선, 네 가지 잔차 무늬x 가 작은 점부터 차례로 · ▲ 는 +, ▼ 는 −
네 줄의 요약 숫자는 같은데 무늬는 넷이 다 다릅니다.
Ⅱ 는 가운데가 통째로 +, 양 끝이 −(덩어리 3) — 관계가 휘었다는 뜻입니다.
Ⅲ 은 − 가 여섯 칸 내리 이어지고(덩어리 4) 가장 큰 잔차가 3.24 로 유난히 큽니다 — 한 점이 직선을 끌어당긴 자국입니다.
자료: 앤스컴 네 데이터 44값 — 코드 ① [A-2]가 찍는 부호열과 같다(원장 실측)
덩어리는 같은 부호가 이어진 토막의 수입니다. Ⅰ 의 −++−−++−+−− 는 일곱 덩어리라
부호가 자주 바뀝니다 — 무늬가 없다는 뜻이고, 직선이 맞습니다.
Ⅱ 의 −−+++++++−− 는 세 덩어리뿐이라 한눈에 규칙이 보입니다.
다만 반례가 하나 있습니다. 잔차가 작다고 좋은 모델인 것은 아닙니다.
Ⅳ 는 가장 큰 잔차가 1.84 로 넷 가운데 가장 작지만, x 가 거의 한 값(8)이고
멀리 떨어진 점 하나(x = 19)가 기울기를 혼자 정하고 있습니다.
그 점을 빼면 나머지 10점은 x 가 모두 같아서 기울기를 정할 수조차 없습니다(3정거장 미션 ①의 도전에서 직접 확인합니다).
이렇게 결론 전체를 혼자 만드는 점을 영향점이라 부릅니다.
2-3우리 따릉이 직선은 어디서 체계적으로 틀리나
앤스컴은 11점짜리 장난감입니다. 같은 검사를 3차시에 세운 우리 직선에 해 봅시다 —
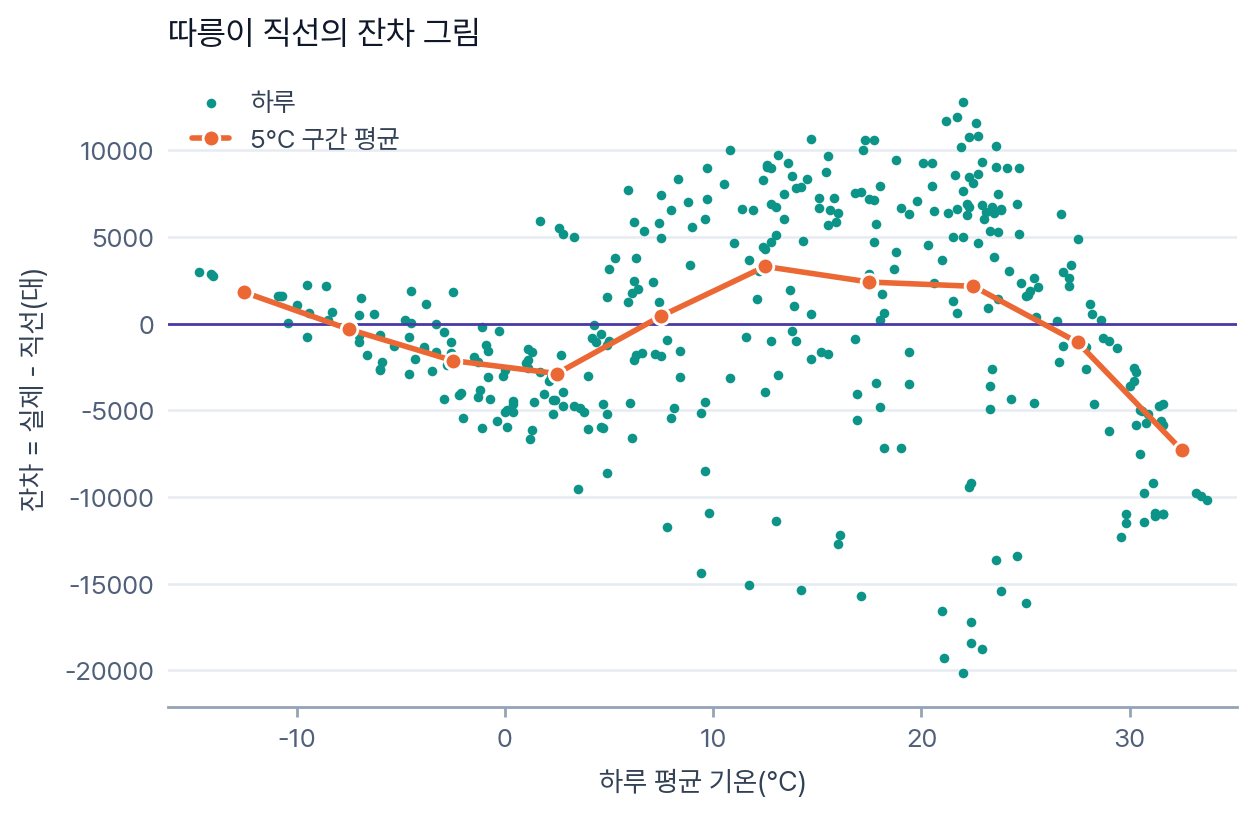
운영한 353일에 맞춘 대여 = 9,324 + 638.9 × 기온 입니다.
353개의 잔차를 하나씩 읽을 수는 없으니, 기온을 5°C 구간으로 잘라
구간마다 잔차의 평균을 냅니다(pd.cut 은 Ⅱ-10 에서 쓴 그 도구입니다).
직선이 맞는 모양이라면 구간마다의 잔차 평균이 0 근처에서 오르내려야 합니다.
그런데 표 2 를 보면 부호가 −10°C · 5°C · 25°C 근처에서 세 번 바뀌고,
가장 더운 구간(30 ~ 35°C)의 24일은 잔차 평균이 −7,293대입니다 —
그 24일 가운데 직선 위에 있는 날은 하루도 없습니다.
Ⅱ-10 에서 구간 중앙값으로 '눈으로 보았던' 꺾임이, 직선을 세우고 나니
직선이 체계적으로 틀리는 자리라는 숫자가 되었습니다.
이것이 '직선'이라는 모양 가정이 틀린 자리이고, 5차시에서 모양을 미리 정하지 않는
기계학습 회귀를 불러오는 까닭입니다.
규칙구간별 잔차 평균을 읽을 때는 날 수를 함께 읽는다.
−15 ~ −10°C 구간은 8일뿐이라 그 평균 +1,810 대는 믿고 쓸 숫자가 아니다.
'직선 위'는 그 구간에서 잔차가 + 였던 날(직선보다 많이 빌린 날) 수입니다. 30 ~ 35°C 의 24일은 0일 —
하루도 예외 없이 직선보다 적게 빌렸습니다.
자료: UCI Seoul Bike Sharing Demand(CC BY 4.0 · DOI 10.24432/C5F62R)를 하루 단위로 구운 353일 — 코드 ③의 출력과 같다
Ⅱ-10 에서 가져옴기온을 구간으로 자르는 pd.cut(값, bins=경계) 은
Ⅱ-10 에서 구간별 중앙값을 볼 때 쓴 도구입니다. 그때는 대여 건수를 구간마다 모았고, 오늘은 잔차를 구간마다 모읍니다.
2-4잔차 평균이 0 인 직선을, 기온만 보고 이길 수 있을까
최소제곱 직선에는 좋은 성질이 하나 있습니다. 잔차의 평균이 정확히 0입니다.
우리 직선도 그렇습니다 — 353일 가운데 직선 위가 176일, 아래가 177일로 거의 반반입니다.
그러면 이런 내기를 걸어 볼 수 있습니다. 날짜도 요일도 날씨도 보지 않고 기온 하나만 보고,
그날이 직선 위일지 아래일지 맞히는 내기입니다.
직선이 모양까지 맞는 모델이었다면 이 내기는 동전 던지기여야 합니다 — 50% 언저리.
기온을 알아도 위인지 아래인지에 대한 정보가 없어야 맞기 때문입니다.
그런데 이길 수 있다면, 그것은 기온 안에 직선이 다 못 쓴 무늬가 남아 있다는 증거입니다.
아래 실험실에서 직접 걸어 봅니다.
시뮬레이터
직선 이기기
기온만 보고 위냐 아래냐 — 잔차 평균이 0 인 직선을 이길 수 있을까
1맨손 6판 — 기온 카드 여섯에 ▲ / ▼ 로 건다
2몇 % 이길지 예측을 잠근다
3기온 띠를 붓으로 칠하고 [353일에 걸기]
4[잔차 섞기] 로 무늬가 없는 세계와 견준다
맨손 6판 — 기온 카드 여섯카드의 ▲ 또는 ▼ 를 눌러 걸어 보세요
이겼다 = 그 기온 칸에 칠한 부호(▲ 위 · ▼ 아래)가 그날 잔차의 부호와 같다 ·
점수 = 이긴 날 ÷ 353일 · 안 칠한 칸의 날은 걸지 않은 것이라 못 이긴다
조각 = 같은 색으로 이어진 기온 구간 하나 ·
증거 부족 = 그 조각 안의 날이 10일이 안 되면 빗금 — 몇 날로 정한 규칙은 믿지 않는다
이긴 날—%
맨손 6판0/6
내 예측—
조각0
증거 부족 조각0
섞은 잔차 300벌—
도전 1
동전을 넘겨라 ★ — 조각 넷 이내로 칠해 60% 를 넘겨 보세요. 어느 기온에서 색을 바꿔야 할까요?
도전 2
무늬 없는 세계와 견주어라 — [잔차 섞기] 를 켜고, 내 점수가 섞은 300벌의 95% 선보다 오른쪽에 서는지 보세요.
도전 3
75% 를 조각 넷으로 ★★★ — 75% 를 넘기되 조각은 넷 이내, 증거 부족 조각은 0개여야 합니다.
자료: 따릉이 353일(기온 · 대여)과 앤스컴 44값을 쪽 안에 실었다 —
3정거장 코드 ③ · ④ 가 읽는 ../data/seoul_bike_daily.csv · ../data/anscombe.csv 와 같은 값이다.
[잔차 섞기] 의 300벌은 원장이 파이썬으로 구운 것(씨앗 2026)을 그대로 실어, 누가 눌러도 같은 숫자가 나온다.
판에서 보았듯이 기온만 보고도 직선을 이깁니다. 5°C 구간의 잔차 평균 부호로 걸면 73.7%,
경계를 −8 · 5 · 28°C 로 옮겨 조각 넷으로 만들면 76.8% 입니다.
반면 잔차를 날짜끼리 섞어 기온과의 관계만 지운 세계에서는 아무리 잘 칠해도 평균 53.0% —
300벌 가운데 95% 가 55.3% 아래입니다. 이 차이가 '직선이 체계적으로 틀린다'는 증거입니다.
그런데 잘게 쪼갠다고 좋아지지는 않습니다. 판의 [1°C 마다] 단추로 잘게 칠하면 점수가
78.2% 로 1.4%p 오릅니다. 그 대가로 날이 10일도 안 되는 조각이 생기고,
무늬가 없는 세계의 점수(섞은 잔차 300벌의 평균)까지 53.0% 에서 54.6% 로 함께 올라갑니다.
오른 몫의 일부는 무늬를 찾은 것이 아니라 그 몇 날의 우연을 외운 것이라는 뜻입니다.
그래서 판은 그런 조각에 '증거 부족' 빗금을 치고, ★★★ 판정에서 빼 버립니다.
2-5관측 범위 밖 — 직선은 계속 뻗지만 데이터는 거기를 모른다
마지막 위험은 바깥입니다. 우리 353일의 하루 평균 기온은 −14.7°C 에서 33.7°C 사이였습니다.
직선은 이 구간 밖으로도 얼마든지 뻗어 나가지만, 데이터는 그 밖에서 무슨 일이 일어나는지
한 번도 본 적이 없습니다. 관측 범위 밖의 예측을 외삽이라 부릅니다.
가장 추웠던 날 · 실제와 직선
2,931실제 대여(대)
vs
−68직선의 답(대)
관측 안인데도 끝에서는 음수가 나온다 — 자전거를 −68대 빌릴 수는 없다.
관측한 기온과 그 바깥
33.7관측 최고(°C)
→
34,04838.7°C 에서 직선의 답(대)
5°C 만 더 더워도 직선은 34,048대라 답한다 — 그 기온의 날은 자료에 하루도 없다.
자료: 코드 ④가 찍는 값 — −14.7°C 에서 −68대, 38.7°C(관측 최고 + 5°C)에서 34,048대.
더 나쁜 것은 이미 알고 있는 사실과 어긋난다는 점입니다.
우리는 방금 더운 끝(30 ~ 35°C)에서 잔차가 −7,293대로 크게 기울었다는 것을 보았습니다.
그 기울기가 그대로 이어진다면 38.7°C 의 실제 대여는 34,048대보다 훨씬 적을 것입니다.
그런데 직선은 그 사실을 모른 채 가장 크게 부풀린 답을 내놓습니다.
외삽이 위험한 까닭은 '모르기 때문'만이 아니라, 아는 것마저 무시하기 때문입니다.
규칙모델을 보고할 때 관측 범위를 함께 적는다.
그 밖의 값을 물어 오면 답 대신 "자료가 본 적 없는 구간"이라고 답한다.
직선을 세운 뒤 묻는 네 가지 — 이 차례로
무늬잔차 부호가 x 를 따라 섞여 있나 — 한쪽으로 몰린 덩어리가 있나
치우침구간마다 잔차 평균이 0 근처인가 — 어느 구간에서 부호가 바뀌나(날 수도 함께)
영향점한 점을 빼면 결론이 바뀌나 — 특히 x 가 멀리 떨어진 점
바깥묻는 값이 관측 범위 안인가 — 밖이면 답하지 않는다
그래서 'R² 가 높으니 좋은 모델이다'도 틀릴 수 있습니다. 앤스컴 넷은 R² 가 모두 0.666 ~ 0.667 로 같지만
넷 가운데 직선이 맞는 것은 Ⅰ 하나뿐입니다. R² 는 모양이 맞는지를 알려 주지 않습니다.
체크포인트 2
잔차 무늬 · 구간별 치우침 · 영향점 · 관측 범위 — 직선을 세운 뒤 물을 네 가지를 손에 넣었다. 이제 직접 구해 본다.
오늘 쓰는 도구는 모두 전에 쓰던 것입니다 — LinearRegression(Ⅲ-3) ·
matplotlib(Ⅱ-6) · pd.cut(Ⅱ-10). 새 도구 대신 새 물음을 배웁니다.
네 칸은 저마다 혼자 돌아가니, 어느 칸부터 눌러도 됩니다.
처음 실행은 몇 초 멈춥니다 — 고장이 아니라 scikit-learn 과 matplotlib 을 쪽마다 한 번 준비하는 중이에요.
1
네 데이터에 직선을 맞추고, 잔차의 부호를 읽는다
10분
먼저 3분. 여는 장면의 빈 축 넉 장에 그린 그림을 꺼내 놓고, 장마다 모양 이름을 한 낱말로 적어 두세요
(예: '흩어진 직선', '휜 곡선'). 그림은 미션 ②에서 엽니다. 그리고 한 가지만 더 짐작해 두세요 —
휜 데이터를 넣으면 도구가 경고를 낼까요?
기본빈칸 ①에 잔차를 구하는 식을 채우고 ▶ 실행하세요.
잔차 = 실제 − 직선이 내놓은 값 입니다. 직선이 내놓은 값은 m.predict(d[["x"]]) 로 받습니다.
앞부분 [A-1]은 채워져 있으니 경고가 몇 줄 나오는지부터 보세요.
[A-1] 네 데이터 — 도구는 경고 한 줄 없이 맞춘다
  x평균  y평균  기울기   절편     r     R²  묶음
   9.00   7.50   0.500  3.000  0.816  0.667  Ⅰ
   9.00   7.50   0.500  3.001  0.816  0.666  Ⅱ
   9.00   7.50   0.500  3.002  0.816  0.666  Ⅲ
   9.00   7.50   0.500  3.002  0.817  0.667  Ⅳ

[A-2] 잔차의 부호를 x 가 작은 쪽부터 — 무늬가 있나
  Ⅰ  −++−−++−+−−  덩어리  7 · 가장 큰 잔차 1.92
  Ⅱ  −−+++++++−−  덩어리  3 · 가장 큰 잔차 1.90
  Ⅲ  +++−−−−−−+−  덩어리  4 · 가장 큰 잔차 3.24
  Ⅳ  −−++++−−+−−  덩어리  5 · 가장 큰 잔차 1.84
도전 코드 맨 아래에 세 줄을 덧붙여, Ⅳ 에서 x = 19 인 점을 빼고 다시 맞춰 보세요.
기울기 0.0 · 절편 7.001 — '아무 관계 없음'이 되는데도 경고는 여전히 0줄입니다.
점을 맞추기 전에 빼야 한다는 것에 주의하세요.
# 도전 — Ⅳ 에서 x 가 19 인 점을 빼고 맞추면?
d = 넷[(넷["묶음"] == "Ⅳ") & (넷["x"] < 19)]
m = LinearRegression().fit(d[["x"]], d["y"])
print("Ⅳ 에서 19 를 빼면"f" 기울기 {m.coef_[0]:.1f}"f" · 절편 {m.intercept_:.3f} · 점 {len(d)}개")
탐구 Ⅰ 의 부호열은 덩어리가 7입니다. 이 부호열을 이기려면(+ 인 칸은 ▲, − 인 칸은 ▼ 로 맞히려면)
이어진 토막 셋으로는 11칸 가운데 8칸까지밖에 맞히지 못합니다.
그런데 같은 부호 열한 개를 마구 뒤섞은 2,000벌을 같은 방법으로 재면 평균 9.0칸입니다.
Ⅰ 이 뒤섞은 것보다도 낮다는 것은 무슨 뜻일까요 — '무늬가 없다'는 무엇으로 판정하는 걸까요?
Ⅱ 의 부호열이 라는 것은 관계가 는 뜻이고,
그래서 직선 대신 가 맞다. Ⅳ 에서 한 점을 빼면 기울기를 정할 수 없는 까닭은
이기 때문이다.
먼저 2분, 다 함께. 위 실험실의 [앤스컴] 탭을 열어 보세요.
요약 램프 다섯(x 평균 · y 평균 · 기울기 · 절편 · r)이 켜져 있는 채로,
곡선 자를 아무 모양으로나 놓고 [봉인] 을 누릅니다.
점들이 자에 달라붙어 모양이 바뀌는 동안 램프 다섯은 한 칸도 흔들리지 않습니다.
요약 숫자를 고정한 채로 모양은 얼마든지 만들 수 있다는 뜻입니다 — 앤스컴 넷은 그 무한한 가능성 가운데 넷일 뿐이에요.
찾은 것
평균 · r · R² · 기울기가 모두 같아도 모양은 넷이 다 달랐다. 도구는 넷 모두에 경고 0줄로 같은 직선을 맞춘다.
도구의 한계
요약 숫자는 모양을 말하지 않는다. 모양을 묻는 재료는 잔차다 — 부호의 무늬, 구간별 평균, 한 점을 뺐을 때의 변화.
보고의 규칙
회귀 결과에는 잔차 그림 · 구간별 날 수 · 관측 범위 셋을 함께 적는다. 범위 밖의 값은 답하지 않는다.
✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.
1. 앤스컴 Ⅱ 의 잔차 부호를 x 가 작은 쪽부터 늘어놓으니 −−+++++++−− 였다.
이 무늬가 무엇을 말하는지 쓰고, 이 데이터에는 어떤 모양의 모델이 더 맞을지 쓰시오.
📖 모범 답안
가운데 점들은 모두 직선 위(+), 양 끝의 점들은 모두 직선 아래(−)에 있다.
잔차가 x 를 따라 한 방향으로 몰려 있으니 무늬가 있는 것이고, 관계가 위로 볼록하게 휘었다는 뜻이다.
덩어리가 셋뿐이라는 것이 그 몰림을 숫자로 말해 준다(Ⅰ 은 7).
직선 대신 곡선(2차식)을 쓰거나, 구간을 나눠 구간마다 다른 직선을 쓰는 구간별 모델이 맞다.
어느 쪽이든 고친 뒤에는 잔차 부호를 다시 보아 무늬가 사라졌는지 확인한다.
2. 앤스컴 Ⅳ 에서 x = 19 인 점 하나를 빼면 기울기는 어떻게 되는가?
그리고 이 점을 '이상치라 지운다' / '그대로 둔다' 가운데 무엇을 택할지, 근거와 함께 쓰시오.
📖 모범 답안
기울기가 0.0(절편 7.001)이 된다. 남은 10점은 x 가 모두 8이라 x 가 변할 때 y 가 어떻게 변하는지를 볼 재료가 없고,
그래서 기울기를 정할 수가 없다. 바꿔 말하면 원래의 기울기 0.500 은 그 한 점이 혼자 만든 값이다 — 영향점이다.
선택은 둘 중 하나를 고르는 일이 아니다. 먼저 그 점이 측정·입력 오류인지 확인한다.
오류라면 지우고 지웠다고 적는다. 오류가 아니라면 그대로 두되, "이 결론은 점 하나에 달려 있다"는 사실을 함께 보고한다.
가장 정직한 보고는 두 경우의 결론을 모두 적는 것이다 — 넣으면 기울기 0.500, 빼면 기울기를 정할 수 없음.
어느 쪽이든 지우고 말하지 않는 것만은 하지 않는다.
3. 따릉이 직선의 잔차 평균이 30 ~ 35°C 구간(24일)에서 −7,293대였고, 그 24일 중 직선 위에 있던 날은 0일이었다.
이 사실로 할 수 있는 말 둘과 할 수 없는 말 하나를 아래 표에 적으시오.
그리고 같은 표의 −15 ~ −10°C 구간(잔차 평균 +1,810대)을 근거로 쓰면 안 되는 까닭도 쓰시오.
칸
내용
할 수 있는 말 ①
할 수 있는 말 ②
할 수 없는 말
📖 모범 답안
할 수 있는 말 ① 하루 평균 30°C 가 넘는 날에는 이 직선이 대여를 부풀려 예측한다 — 24일 모두 실제가 직선보다 적었고, 평균 7,293대 적었다.
할 수 있는 말 ② 기온과 대여의 관계는 어느 기온 뒤로 꺾인다. 직선이라는 모양 가정이 더운 끝에서 맞지 않는다.
할 수 없는 말 "더위가 대여를 줄인다"는 인과. 더운 날은 장마·방학·휴가와 겹치고, 그날의 습도·강수도 함께 움직인다.
이 표만으로는 무엇이 원인인지 가를 수 없다.
−15 ~ −10°C 구간은 8일뿐이다. 며칠 안 되는 날의 평균은 그해의 우연(예: 그중 하루가 마침 공휴일)에 크게 흔들리므로,
잔차 평균이 +1,810대라 해도 "추우면 직선이 모자라게 맞힌다"는 근거로 쓸 수 없다.
구간별 잔차 평균은 날 수와 함께 읽는다.
4. "R² 가 0.8 이나 되니 이 모델은 좋다"는 주장을 앤스컴 데이터로 반박하시오.
반박한 뒤, 그러면 모델이 좋은지 알아보려면 무엇을 함께 보아야 하는지 쓰시오.
📖 모범 답안
앤스컴 네 데이터는 R² 가 모두 0.666 ~ 0.667 로 같다. 그런데 Ⅰ 만 직선이 맞고,
Ⅱ 는 휘었으며, Ⅲ 은 한 점이 직선을 끌어당기고, Ⅳ 는 한 점이 기울기를 혼자 만든다.
같은 R² 아래에 좋은 모델 하나와 나쁜 모델 셋이 함께 있다 — 그러므로 R² 값 하나로는 좋은 모델인지 알 수 없다.
R² 는 'y 의 흩어짐 가운데 모델이 설명한 몫'을 재는 숫자일 뿐, 모양이 맞는지는 재지 않는다.
함께 보아야 하는 것은 잔차다 — ① 잔차 부호가 x 를 따라 무늬 없이 섞였나
② 구간마다 잔차 평균이 0 근처인가(날 수와 함께) ③ 한 점을 빼도 결론이 그대로인가 ④ 묻는 값이 관측 범위 안인가.
우리 따릉이 직선도 이 검사에서 더운 끝이 걸렸다.
5. 관측한 가장 더운 날보다 5°C 더운 날(38.7°C)의 대여를 이 직선으로 예측하면
34,048대가 나온다. 이 값을 믿으면 안 되는 까닭을 '데이터가 본 것'으로 설명하시오.
(표 2 에서 읽은 것을 근거로 함께 쓰면 좋습니다.)
📖 모범 답안
우리 자료가 본 하루 평균 기온은 −14.7 ~ 33.7°C 다. 38.7°C 인 날은 353일 가운데 하루도 없다.
직선은 관측 구간에서 찾은 경향을 그 밖으로 그냥 연장할 뿐, 그 구간에서 관계가 어떻게 되는지에 대한 근거를 하나도 가지고 있지 않다.
게다가 우리는 이미 반대 방향의 증거를 보았다. 30 ~ 35°C 의 24일은 잔차 평균이 −7,293대이고
그 가운데 직선 위에 있던 날은 0일이다. 관측 안에서도 더워질수록 직선이 점점 크게 부풀리고 있었으니,
그보다 더 더운 날의 실제 대여는 34,048대보다 훨씬 적을 가능성이 크다.
반대쪽 끝에서 직선이 −68대라는 불가능한 답을 내놓은 것도 같은 이유다.
그래서 이런 물음에는 숫자 대신 "자료가 본 적 없는 구간이라 답할 수 없다"고 답하고,
꼭 답이 필요하면 그 기온의 날을 더 모으는 것이 먼저다.
+
더 알아보기
한 점 · 바깥 · 그해 여름
방법 더 깊이
한 점이 직선을 끌 때 — 지렛대와 쿡의 거리
튀는 점이 모두 위험한 것은 아닙니다. 어디에 있는 점이냐가 훨씬 중요해요.
앤스컴 Ⅰ 에서 가운데에 있는 점(x = 9, 마침 x 평균과 같은 자리)을 3 만큼 올려 보면
기울기는 0.500 그대로입니다 — 직선이 위로 평행 이동할 뿐이에요.
그런데 끝에 있는 점(x = 4)을 똑같이 3 만큼 올리면 기울기가 0.500 → 0.364 로 꺾입니다.
같은 크기로 움직였는데 결과가 다른 까닭은, 끝의 점이 시소의 먼 쪽에 앉아 있기 때문입니다.
이 '먼 쪽에 앉은 정도'를 지렛대(leverage)라고 부릅니다.
그렇다면 어떤 점이 결론을 정말로 바꾸는지 어떻게 잴까요?
쿡(R. D. Cook, 1977) 의 생각은 아주 단순합니다 — 그 점을 빼고 다시 맞춰서, 모든 점에 대한 예측이 얼마나 달라졌는지 더해 보는 것입니다.
이 값을 쿡의 거리라 하고, 점마다 하나씩 나옵니다.
값이 유난히 큰 점이 있으면 "이 결론은 저 점 하나에 달려 있다"는 신호예요.
오늘 우리가 손으로 한 일 — Ⅳ 에서 한 점을 빼고 다시 맞춰 본 일 — 이 바로 쿡의 거리를 한 점에 대해 계산해 본 것입니다.
도해: 앤스컴 Ⅰ 의 11점 가운데 한 점만 3 올려 다시 맞춘 직선 두 장. 좌표와 기울기는 LinearRegression 으로 계산한 값이다.
· 개념 출처: R. D. Cook, Detection of Influential Observation in Linear Regression, Technometrics 19(1), 1977
현장
고른 것만 그린 그림 — 발사 전날 밤의 판단
1986년 1월, 미국의 우주왕복선 챌린저호가 발사 직후 폭발했습니다.
사고 조사에서 문제가 된 부품은 연료통 이음매를 막는 고무 고리(O-링)였고,
고리가 추울수록 잘 상한다는 것이 뒤늦게 확인되었습니다.
발사 전날 밤 회의에서 기술자들은 실제로 기온을 걱정했습니다. 그런데 그때 회의에 올라온 그림에는
고리가 상했던 발사들만 그려져 있었습니다 — 고리가 멀쩡했던 발사는 "문제가 없었으니" 빠졌던 것이지요.
고장 난 것만 모아 놓으면 관계가 보이지 않습니다. 도해 ①처럼 점들이 흩어져 보일 뿐이에요.
멀쩡했던 발사까지 모두 그려야(②) 비로소 추운 쪽에 고장이 몰려 있다는 것이 드러납니다.
여기에 하나가 더 겹쳤습니다 — 그날 아침의 기온은 그때까지 기록이 있는 어떤 발사보다도 낮았습니다.
곧 관측 범위 밖이었고, 그 구간에 대해서는 자료가 아무 말도 해 줄 수 없었습니다.
오늘 배운 두 가지가 여기서 한꺼번에 나옵니다. 어떤 점을 그림에 넣느냐가 관계를 만들거나 지운다는 것,
그리고 관측 범위 밖에서는 모델이 아니라 "모른다"가 정답일 수 있다는 것입니다.
도해: 사건의 짜임을 보인 그림이다 — 점의 자리는 실제 기록이 아니라 '고른 것만 그리면 관계가 사라진다'는 구조를 보이려고 그린 예시다.
우리 자료
우리 353일은 어떤 한 해였나 — 2018년 여름
오늘 내내 쓴 353일은 2017년 12월 1일부터 2018년 11월 30일까지입니다.
곡선을 보면 2018년 7~8월에 봉우리가 유난히 넓고 높습니다 — 하루 평균 기온이 30°C 를 넘은 날이 24일이나 있고,
가장 높은 날은 2018년 8월 2일의 33.7°C 입니다.
표 2 에서 "직선을 쓰면 안 되는 기온대"로 걸린 그 24일이 바로 이 봉우리 안의 날들이에요.
여기서 숫자의 이름을 한 번 더 확인해 둡시다. 33.7°C 는 하루 평균 기온입니다.
뉴스에서 "오늘 서울 최고 ○○도"라고 할 때의 그 숫자는 낮 최고 기온이라, 같은 날이라도 하루 평균보다 훨씬 큽니다.
둘은 이름도 다르고 값도 다릅니다 — 같은 표 안에 섞어 놓으면 분석이 통째로 어긋나요.
우리 자료가 하루 평균을 쓰므로, 우리가 말하는 '30°C 가 넘는 날'은 하루 내내 평균이 30°C 가 넘은 날이라는 뜻입니다.
마지막으로 하나. 이 한 해는 유난한 여름을 품은 한 해입니다.
그런 한 해로 맞춘 직선을 다른 해에 그대로 쓰면, 더운 끝의 치우침이 그 해의 사정인지 기온과 대여의 관계인지 가릴 수 없습니다.
12차시에서 여러 해로 시험하며 이 물음을 다시 만납니다.
도해: 우리 자료(운영한 353일)의 하루 평균 기온을 날짜 순으로 그렸다. 30°C 를 넘은 날 24일과 최고 33.7°C 는 자료에서 직접 센 값이다.
· 자료: UCI Seoul Bike Sharing Demand(CC BY 4.0 · DOI 10.24432/C5F62R)를 하루 단위로 구운 것