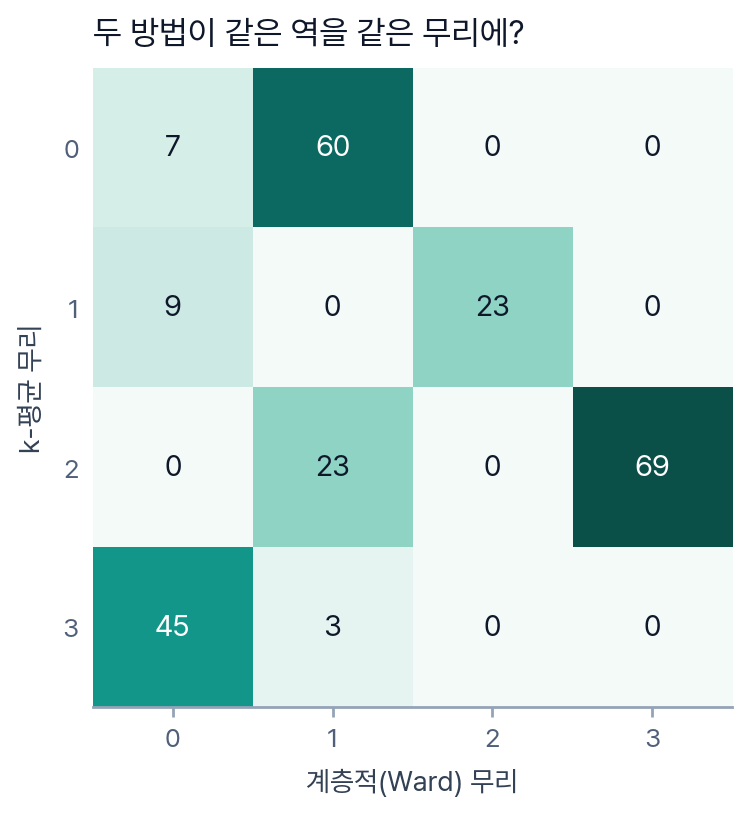
두 번째 방법으로 다시 나눈다 — 같은 역을 같은 무리에?
8분여는 장면에 적어 둔 내 문장입니다. 오늘 꺼낸 자 가운데 어느 것과 가까운가요?
두 방법이 다른 무리에 넣는 역은 239곳 중 몇 곳일까요? 숫자 하나를 먼저 짐작해 두세요.
기본 빈칸 ①에 계층적 군집을 부르는 이름을 채우고 ▶ 실행합니다.
앞의 [준비] 구간은 7차시의 구성비 표와 k-평균을 그대로 다시 만드는 부분이니 고치지 마세요.
[1] 실루엣 — k-평균 0.324 · 계층적(Ward) 0.281
[2] 행: k-평균 무리(0 혼합 1 업무 2 주거 3 번화)
Ward   0   1   2   3
k-평균
0      7  60   0   0
1      9   0  23   0
2      0  23   0  69
3     45   3   0   0
    다른 무리로 간 역 42곳 — 예: 강변, 개롱, 경복궁, 고려대
도전 linkage="ward" 를 "average" 나 "complete" 로 바꿔 보세요.
합칠 둘을 고르는 기준이 달라지면 엇갈려 센 표가 어떻게 달라지나요? 방법을 하나 더 늘리면 '일치'는 더 믿을 만해질까요?
탐구 실루엣은 k-평균 0.324, Ward 0.281 로 k-평균이 조금 높습니다. 그렇다고 k-평균이 '더 옳은' 나눔일까요? 실루엣이 높다는 것이 무엇을 뜻하는지(7차시)로 돌아가 생각해 보세요.
두 방법이 똑같이 찾은 무리는 이므로 그 이름을 . 섞인 두 무리의 경계는 이므로 거기 선 역은 .
확인 문제 1에 적어 제출 →