단원 홈
4단원 · 9차시

전체 85%는 누구의 85%인가
성능을 쪼개어 본다

8차시에서 팀의 코드가 한 벌로 합쳐졌습니다. 이제 손에 정확도 한 줄이 있습니다. 오늘은 그 한 줄을 쪼갭니다. 나머지 몇 %를 누가 떠안고 있는지 보는 일입니다.

성취기준 12인기04-04
네 칸정밀도재현율 집단별 성능집단 크기 n오류 분석
🎯 학습 목표
  • 우리 팀 모델의 예측을 네 칸(TP·FP·FN·TN)으로 세고, 정밀도와 재현율을 우리 문제의 말로 옮길 수 있다.
  • 전체 성능을 집단별로 쪼개어, 집단 크기 n과 그 집단의 기준선을 함께 적어 읽을 수 있다.
  • 틀린 것들을 들여다보고 공통점을 찾아, 다음에 무엇을 더 모을지를 한 문장으로 정할 수 있다.
🤔

여는 장면 — 보고서에 한 줄만 적는다면

발표 자료의 첫 줄을 이렇게 적었다고 해 봅시다.

📖 어느 팀의 발표 첫 줄

“우리 모델의 정확도는 85.4%입니다.”

틀린 문장은 아닙니다. 견본 데이터로 돌리면 실제로 그 값이 나옵니다. 테스트 48장 가운데 41장을 맞혔으니 85.4%입니다. 그런데 이 한 줄은 맞힌 41장만 말하고 틀린 7장에 대해서는 아무 말도 하지 않습니다.

물어볼 것이 셋 있습니다.

  • 틀린 7장은 어느 쪽으로 틀렸습니까? 없는 것을 있다고 했습니까, 있는 것을 없다고 했습니까?
  • 그 7장은 골고루 흩어져 있습니까, 아니면 한 곳에 몰려 있습니까?
  • 85.4%는 누구의 85.4%입니까? 밝은 데서 찍은 사진과 어두운 데서 찍은 사진이 같은 점수를 받았습니까?

Ⅱ-3에서 이미 이 문장을 만난 적이 있습니다. “전체 85%가 누구에겐 20%”라는 제목이었습니다. 그때는 남이 만든 모델의 이야기였습니다. 오늘은 우리 표입니다. Ⅲ-7에서 “정확도는 같은데 차별은 어디에”를 따졌던 눈을, 오늘은 우리가 만든 모델에 그대로 들이댑니다.

⚠️ 집단 열이 아직 없는 팀에게

오늘 코드는 성능을 쪼갤 열이 있어야 돕니다. 6차시 정리에서 “집단 열을 하나 정해 온다”를 숙제로 냈던 것이 여기서 회수됩니다. 촬영 조건·요일·학년·수집한 사람 — 무엇이든 좋습니다.

아직 정하지 못했다면 오늘은 견본 데이터로 진행하세요. 아래 실행기의 【0】 상자 안에 페트병 사진 160장짜리 견본 표가 이미 실려 있습니다. 한 글자도 고치지 않고 [▶ 실행]만 눌러도 오늘 할 일이 전부 돌아갑니다. 자기 데이터는 다음 시간에 넣어도 늦지 않습니다.

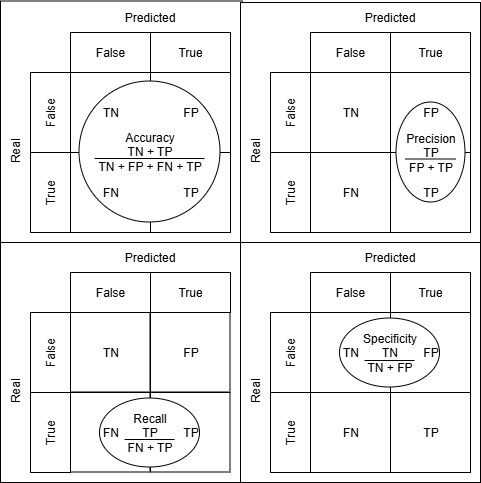
같은 혼동행렬 네 벌에 각각 정확도·정밀도·재현율·특이도 식을 동그라미로 묶어 표시한 도표. 가로는 Predicted, 세로는 Real
같은 네 칸을 네 번 그려, 정확도·정밀도·재현율·특이도가 각각 어느 칸을 쓰는지 동그라미로 묶은 그림입니다. 라벨이 영어이고 ‘거짓(False)’을 먼저 적어서 TP가 오른쪽 아래에 있습니다 — 오늘 코드가 찍는 표는 TP가 왼쪽 위입니다. 칸 순서는 달라도 가로가 예측, 세로가 실제이고 대각선이 맞힌 것이라는 짜임은 같습니다. 오늘 우리가 하는 일은 이 표를 집단마다 하나씩 만드는 것입니다. 출처: Hssiqueira, Wikimedia Commons (CC0)
ℹ️ 오늘 40분을 어떻게 쓰나

여는 장면 4분 · 개념 8분(네 칸 / 정밀도·재현율 / 집단별로 쪼개기) · 손으로 22분(해부대 7분 + 빈칸 일곱 13분 + 팀 점검 2분) · 정리 6분. 개념 세 가지는 모두 Ⅱ단원에서 이미 배운 것입니다. 다시 설명하지 않고 가리키기만 합니다.

1

네 칸은 이미 배웠다 — 오늘은 우리 문제의 말로 옮긴다

Ⅱ-12 “정확도 98%짜리 쓸모없는 모델”에서 맞고 틀림을 넷으로 갈랐습니다. 그때 만든 함수 confusion()과 scores()를 오늘 코드가 한 글자도 고치지 않고 그대로 싣고 있습니다. 그래서 함수 안의 설명이 아직 ‘환자’라고 되어 있습니다. 어색해 보여도 고치지 마세요. 두 차시를 나란히 놓았을 때 같은 함수임을 알아보는 것이 이 규칙의 목적입니다.

대신 Ⅳ단원이 이음매 한 줄을 새로 붙였습니다.

💡 이음매는 to01() 한 줄이다

confusion()은 1과 0만 받습니다. 그런데 우리 이름표는 "가능"과 "불가"라는 글자입니다. 그 사이를 잇는 것이 to01()입니다. 무엇을 1로 둘지는 맨 위 POSITIVE 한 곳에서만 정합니다.

“무엇을 1로 둘 것인가”는 계산이 아니라 결정입니다. 우리는 “재활용할 수 있는 것을 놓치면 안 된다”고 보아 POSITIVE = "가능"으로 두었습니다. 이 한 줄을 계획서와 모델 카드에 반드시 적어 두세요.

네 칸을 우리 문제의 말로 옮기면 이렇게 됩니다. 견본 데이터·k=7·테스트 48장에서 나온 숫자를 함께 적었습니다.

TP · 맞게 잡음22

재활용 가능한 병을 가능이라고 맞혔다. 선별대로 잘 넘어간 병.

FP · 헛짚음0

재활용이 안 되는 병을 가능이라고 했다. 선별대에 잘못 올라가 뒤에서 걸러야 한다.

FN · 놓침7

재활용 가능한 병을 불가라고 했다. 되살릴 수 있었는데 그냥 버려진 병.

TN · 맞게 넘김19

재활용이 안 되는 병을 불가라고 맞혔다.

이 넷을 하나로 뭉갠 값이 정확도입니다. (22 + 19) ÷ 48 = 85.4%. 뭉개는 순간 “어느 쪽으로 틀렸는가”가 사라집니다. 위 네 칸을 보면 우리 모델은 헛짚는 쪽으로는 한 번도 틀리지 않았고(FP 0), 놓치는 쪽으로만 일곱 번 틀렸습니다(FN 7). 한쪽으로 완전히 쏠려 있는데 정확도 한 줄에는 그 사실이 남지 않습니다.

짝의 순서를 뒤집으면 — 오류가 나지 않아서 위험하다

confusion()에 넣는 짝은 (실제, 예측) 순서입니다. 뒤집어 넣어도 파이썬은 아무 말 없이 돌아갑니다. 그리고 이런 일이 벌어집니다.

같은 예측 48개를 순서만 바꿔 넣은 결과입니다. 정확도와 F1은 소수점까지 똑같습니다.
넣은 순서TPFPFNTN 정확도정밀도재현율F1검산 TP+FN
(실제, 예측) — 바르다220719 85.4%100.0%75.9%0.86329
(예측, 실제) — 뒤집혔다227019 85.4%75.9%100.0%0.86322

정확도와 F1은 한 자리도 안 바뀌고, 정밀도와 재현율만 자리를 맞바꿉니다. 화면만 보아서는 잡을 수가 없습니다. 그래서 오늘 코드는 줄 하나를 더 찍습니다.

⚠️ 검산 줄이 유일한 방어다

재현율의 분모는 TP + FN이고, 그 값은 실제로 양성인 것의 수와 같아야 합니다. 우리 판에서는 22 + 7 = 29이고, 테스트 48장 중 실제 ‘가능’이 29장이므로 같습니다. 뒤집힌 쪽은 22 + 0 = 22가 되어 29와 어긋납니다. 이 한 줄이 없으면 끝까지 모릅니다.

1을 반대쪽으로 두면 무엇이 달라지나

POSITIVE를 "불가"로 바꿔 같은 예측을 다시 재 보면 이렇게 됩니다.

같은 모델·같은 예측입니다. 무엇을 1로 두었는가만 다릅니다.
1로 둔 것TPFPFNTN 정확도정밀도재현율F1 어두움 정밀도 / 재현율
‘가능’ (우리 선택)220719 85.4%100.0%75.9%0.863100.0% / 53.8%
‘불가’197022 85.4%73.1%100.0%0.84453.8% / 100.0%

정확도 85.4%는 꿈쩍도 하지 않는데 F1은 0.863에서 0.844로 달라지고, 정밀도와 재현율은 통째로 다른 이야기가 됩니다. 지표는 무엇을 1로 두었는지에 매달려 있습니다. 발표 자료에 “재현율 75.9%”라고만 적으면 읽는 사람은 무엇의 재현율인지 알 수 없습니다.

2

정밀도 100%는 자랑이 아니다

정밀도와 재현율의 뜻은 Ⅱ-12에서 배운 그대로입니다. 정밀도는 “가능이라고 한 것 중 진짜로 가능이었던 비율”, 재현율은 “진짜 가능인 것 중 우리가 찾아낸 비율”입니다. 정의를 다시 외우지 말고, 우리 표에 넣어 봅시다.

정밀도 100.0%

22 ÷ (22 + 0). 가능이라고 말한 22장이 전부 진짜로 가능이었습니다. 한 번도 헛짚지 않았습니다.

재현율 75.9%

22 ÷ (22 + 7). 진짜 가능인 29장 중 22장만 찾았습니다. 7장을 그냥 버렸습니다.

정밀도가 100%라고 해서 “다 맞혔다”는 뜻이 아닙니다. 헛짚지 않았다는 뜻일 뿐이고, 같은 판에서 7장을 놓쳤습니다. 게다가 이 100%는 우리가 잘해서 나온 값이라기보다, 모델이 확실할 때만 가능이라고 말하는 쪽으로 치우쳐 있어서 나온 값에 가깝습니다. 확실할 때만 손을 들면 헛짚지는 않지만 많이 놓칩니다.

k만 7에서 5로 내려 보면 그것이 곧바로 보입니다.

같은 데이터·같은 분할입니다. 이웃 몇 명에게 물을지만 바꿨습니다.
kTPFPFNTN 정확도정밀도재현율
7220719 85.4%100.0%75.9%
5232617 83.3%92.0%79.3%

k=5는 정확도가 2.1%p 낮습니다. 대신 헛짚음이 2건 생기는 값으로 놓침을 하나 줄였습니다. 어느 쪽이 좋은 모델입니까? 이 물음에는 계산으로 답할 수 없습니다. 우리 문제가 무엇을 더 겁내는가로 답해야 합니다.

🎯 우리 팀은 어느 쪽을 겁내는가

놓치면 큰일인 문제라면 재현율을 봅니다. 재활용될 수 있는 병을 버리는 것, 도움이 필요한 학생을 지나치는 것, 고장 징후를 흘려보내는 것.

잘못 지목하면 큰일인 문제라면 정밀도를 봅니다. 멀쩡한 사람을 의심 대상으로 올리는 것, 아무 문제 없는 글을 신고 처리하는 것. 우리 주제는 어느 쪽입니까? 그 한 문장을 오늘 공책에 적어 두면, 10차시에서 설정을 고를 때 그 문장이 기준이 됩니다.

3

쪼갤 때는 n을 함께 적는다 — 그리고 그 집단의 기준선과 견준다

이제 같은 표를 집단마다 하나씩 만듭니다. 견본 데이터에서 성능을 쪼갤 열은 촬영조건입니다. 이 열은 모델에 넣지 않았습니다. 맞히는 데 쓰라고 모은 열이 아니라, 나중에 갈라 재려고 남겨 둔 열입니다.

견본 데이터 · 훈련 110 / 테스트 48 · 씨앗 42 · k=7. 코드가 찍는 표와 같은 값입니다.
집단n정확도정밀도재현율F1 TPFPFNTN
전체4885.4%100.0% 75.9%0.863220719
밝음2896.4%100.0% 93.8%0.968150112
어두움2070.0%100.0% 53.8%0.7007067

한 줄이 세 줄이 되었습니다. 그리고 다른 이야기가 됩니다.

  • 정확도 격차 26.4%p — 밝음 96.4% 대 어두움 70.0%.
  • 재현율 격차 39.9%p — 밝음 93.8% 대 어두움 53.8%. 재현율 쪽이 더 벌어집니다. 정확도만 보면 격차를 실제보다 작게 읽습니다.
  • 놓친 7장 중 6장이 어두움입니다. 어두운 데서 찍은 ‘가능’ 병의 절반 가까이를 버리고 있습니다.

“어두움 70%”는 나쁜 값인가

아직 모릅니다. Ⅱ-11에서 세운 규칙을 그대로 씁니다 — 정확도는 홀로는 아무 뜻이 없고 기준선과의 차이로만 읽힙니다. 그런데 여기에 함정이 하나 있습니다. 기준선도 집단마다 다릅니다.

기준선 = 늘 ‘가능’이라고만 말하는 바보 모델의 정확도. 이름표는 훈련에서 고른 것을 씁니다.
집단n그 집단의 기준선우리 모델차이
전체4860.4%85.4%+25.0%p
밝음2857.1%96.4%+39.3%p
어두움2065.0%70.0%+5.0%p

여기가 오늘의 심장입니다. 전체로는 기준선을 25.0%p나 넘었는데, 어두움 집단에서는 5.0%p뿐입니다. 그 집단만 놓고 보면 우리 모델은 “늘 가능”이라고만 외치는 바보 모델과 거의 같습니다. “전체 85.4%” 한 줄이 이 사실을 통째로 감춥니다.

⚠️ 가장 하기 쉬운 실수 — 전체 기준선과 견주기

어두움 70.0%를 전체 기준선 60.4%와 견주면 +9.6%p로 보입니다. 실제로는 +5.0%p입니다. 집단마다 기준선을 다시 재지 않으면 약한 집단을 실제보다 후하게 읽게 됩니다.

그리고 어두움의 기준선(65.0%)이 밝음의 기준선(57.1%)보다 높습니다. “어두움이 더 어렵다”와 “어두움의 기준선이 더 높다”는 서로 다른 사실입니다. 두 문장을 섞어 쓰지 마세요.

그리고 반드시 n을 함께 적는다

어두움 집단은 20장입니다. 20장으로 잰 70.0%는 얼마나 단단한 숫자일까요? 만약 그 집단이 3장뿐이었다면 어땠을까요?

💡 계산해 볼 것도 없이 정해지는 것

표본이 m개면 나올 수 있는 정확도는 m+1가지뿐이고, 한 개만 뒤집혀도 100/m %p가 움직입니다.

3장이면 0% · 33.3% · 66.7% · 100% 네 값밖에 없고, 한 장만 달라도 33.3%p가 튑니다. 3장 중 2장을 맞혀서 66.7%인 것을 ‘성능’이라고 부르면 안 됩니다. 그래서 이 단원의 표에는 % 옆에 n을 반드시 함께 적습니다.

얼마나 튀는지, 그리고 최소 몇 개가 있어야 하는지는 오늘 직접 재 봅니다. 먼저 아래 해부대에서 눈으로 보고, 그다음 코드로 숫자를 뽑습니다.

💻

손으로 ① — 성능 해부대 (7분)

아래 해부대는 파이썬을 부르지 않고 브라우저가 그 자리에서 계산합니다. 들어 있는 것은 우리 모델이 실제로 낸 예측 48개입니다 — 손으로 적어 둔 정답표가 아니라, 7차시에서 고른 k로 knn()이 낸 결과를 그대로 담았습니다.

기본값은 k=7 · 촬영조건으로 둘로 쪼개기 · 표본 전부입니다. 먼저 [▶ 갈라 보기]를 그대로 눌러, 위 표의 96.4% / 70.0%가 그대로 나오는지 확인하세요.

🔬 성능 해부대 — 한 줄을 여러 줄로 가른다 INTERACTIVE

맨 위 굵은 막대가 전체 정확도입니다. [▶ 갈라 보기]를 누르면 그 막대가 집단별 막대로 갈라져 내려옵니다. 막대마다 그 집단의 기준선이 점선으로 그어지고, 막대 아래에 집단 크기 n이 함께 적힙니다. n이 15보다 작은 집단은 흐리게 그려집니다 — 그 숫자는 아직 성능이라고 부를 수 없다는 표시입니다.

집단마다 m개씩만 (되돌려 넣으며) 뽑아 다시 잽니다
그 집단의 기준선을 넘은 막대 기준선에 못 미치는 막대 점선 = 그 집단의 기준선 흐린 막대 = n이 15보다 작다
전체 정확도—
전체 정밀도—
전체 재현율—
정확도 격차—
재현율 격차—
최저 집단 − 기준선—
집단n정확도정밀도재현율 TPFPFNTN기준선차이
[안내] [▶ 갈라 보기]를 누르면 전체 막대가 집단별로 갈라집니다. 기본값은 k=7 · 촬영조건 둘 · 표본 전부입니다.

과제 ① — 표를 채운다

표본은 전부로 두고, 쪼개는 기준은 촬영조건(둘)으로 둔 채 k만 갈아 끼웁니다. 네 줄을 돌려 공책에 옮겨 적으세요. 칸에 바로 적어도 됩니다. 마지막 칸 ‘어두움 − 기준선’은 해부대의 [최저 집단 − 기준선] 칸에 그대로 나옵니다.

k전체 정확도밝음어두움어두움 재현율어두움 − 기준선
1
5
7
15

과제 ② — 반례를 만든다

k를 훑으며 어두움 집단이 그 집단의 기준선(65.0%)보다 낮아지는 k를 모두 찾으세요. 찾았으면 그때 전체 정확도와 밝음 정확도가 얼마인지도 함께 적습니다. 전체와 밝음이 얼마나 태연한지 보는 것이 이 과제의 핵심입니다.

과제 ③ — 문턱을 찾는다

k를 7로 되돌리고 [집단 크기 m] 슬라이더를 3까지 내린 다음, [🎲 다시 뽑기]를 열 번쯤 눌러 보세요. 어두움 막대가 어디까지 뛰는지 봅니다. 그다음 [📉 흔들림 재기]를 누르면 그 m에서 흔들림의 폭이 숫자로 나옵니다.

m을 3에서 하나씩 올리며, 흔들림의 폭(2×표준오차)이 두 집단의 격차 26.4%p보다 처음으로 좁아지는 m을 찾으세요. 그 수가 왜 중요한지는 곧 코드가 설명합니다.

💡 해부대를 볼 때 놓치지 말 것

막대의 길이가 아니라 점선과의 거리를 보세요. 어두움 막대는 밝음 막대보다 짧지만, 그 밑에 그어진 점선(그 집단의 기준선)도 더 높습니다. 길이만 견주면 “어두움이 26.4%p 나쁘다”가 되고, 점선과의 거리를 보면 “어두움에서는 거의 아무것도 못 하고 있다”가 됩니다. 두 문장은 크기가 다릅니다.

💻

손으로 ② — 빈칸 일곱을 채운다 (13분)

아래 코드는 6·7·8차시에서 쓰던 같은 골격입니다. 한 글자도 바뀌지 않았습니다. 브라우저의 파이썬은 차시가 바뀌면 새로 시작하므로, 앞 차시에서 만든 함수를 기억하지 못합니다. 그래서 매번 다시 싣습니다. 오늘 새로 붙은 것은 아래 셋뿐입니다.

  • to01() — 이름표를 1과 0으로 바꾸는 이음매. Ⅳ단원이 새로 붙인 유일한 줄입니다.
  • confusion() · scores() — Ⅱ-12에서 통째로 가져왔습니다. 설명이 ‘환자’인 채로 두었습니다.
  • by_group() · show_groups() — 집단마다 네 칸을 세고, n을 반드시 함께 돌려줍니다.

채울 곳은 일곱 군데(?????)입니다. 하나라도 남아 있으면 실행조차 되지 않습니다 (SyntaxError: invalid syntax). 그것은 고장이 아니라 안전장치입니다.

⚠️ 어림으로 적은 숫자와 돌려서 나온 숫자가 다를 때

이 견본 데이터는 지어낸 표입니다. 이 교과서를 설계할 때 그 결과를 전체 70%쯤·밝음 90%쯤·어두움 50%쯤으로 어림해 적어 두었습니다. 실제로 돌려 보니 85.4% · 96.4% · 70.0%가 나왔습니다. 하려던 이야기(밝음이 어두움보다 한참 낫다)는 그대로였지만 어림한 값은 하나도 맞지 않았습니다.

어림으로 적은 숫자와 돌려서 나온 숫자가 다르면, 언제나 돌려서 나온 쪽이 맞습니다. 5차시 계획서 칸 2에 “몇 %면 성공인가”를 적어 두었더라도, 발표 자료에는 오늘 실제로 나온 값을 적으세요. 계획서에 적어 둔 성공 기준은 지우지 말고 옆에 남겨 두세요 — 얼마나 빗나갔는지가 10차시 실험 기록의 한 줄이 됩니다.

ℹ️ 자기 데이터를 넣을 팀

맨 위 【0】 상자만 갈아 끼웁니다 — DATA와 다섯 줄 (NAMES · FEATURES · LABEL · GROUP · POSITIVE). “DATA만 바꾸면 된다”가 아닙니다. NAMES를 안 고치면 load()가 첫 줄에서 막습니다. 나머지 다섯(SEED · RATIO · K_LIST · MIN_TEST · MIN_GROUP)은 건드리지 않습니다. 집단 이름은 한글 네 글자 이하로 지으세요 — 표의 집단 이름 칸이 열 칸이라 다섯 글자면 다음 칸과 붙습니다.

실행하면 무엇이 나오나

화면이 아홉 토막으로 나옵니다. 【1】은 6·7차시의 복습이고, 오늘 읽을 것은 【2】부터입니다. 【3】과 【4】는 아래 과제 ④의 표에 옮겨 적으세요. 그 표가 오늘의 산출물입니다.

【8】【9】는 시간이 남는 팀을 위한 읽을거리입니다. 아래 절에 표로 옮겨 두었습니다.
토막무엇이 나오나여기서 할 일
【2】네 칸과 세 지표 · 검산 줄검산이 “같다”로 나오는지 확인
【3】집단별 표 (n 포함) · 두 격차공책에 옮겨 적는다
【4】그 집단의 기준선과의 차이공책에 옮겨 적는다
【5】틀린 것 하나하나 · 놓친 것과 잡은 것의 평균공통점을 한 문장으로 적는다
【6】【7】집단이 작으면 얼마나 튀나 · 왜 15개인가우리 집단이 몇 개인지 견준다
【8】【9】k별 붕괴 · 더 잘게 쪼개기시간이 남으면

과제 ④ — 우리 팀 표를 채운다

【3】과 【4】는 화면에 따로 뜨지만 같은 줄을 두 번 나눠 찍은 것입니다. 아래 한 표에 합쳐 적으세요. 새로 고침 한 번이면 화면은 사라지고, 이 표가 다음 시간 실험 기록의 첫 줄이 됩니다. 견본으로 진행하는 팀은 견본 값을 그대로 옮겨 적으면 됩니다.

집단 줄이 셋 이상이면 칸을 늘려 씁니다. n이 15보다 작은 줄은 %를 적지 말고 분수 그대로 적으세요(예: 3장 중 2장).
집단n정확도정밀도재현율그 집단의 기준선차이(%p)
전체

다 채웠으면 가장 낮은 줄에 동그라미를 치고 그 옆에 한 문장을 적으세요 — “우리 모델은 ○○ 집단(n=○)에서 그 집단의 기준선을 ○○%p 넘는 데 그쳤다.” 발표 자료의 첫 줄은 전체 정확도가 아니라 이 문장이어야 합니다.

【5】가 오늘 가장 쓸모 있는 화면이다

틀린 7장을 하나씩 늘어놓고, 놓친 것과 잡은 것의 특성 평균을 나란히 놓습니다. 둘 다 실제로는 ‘가능’인 병들입니다. 차이가 있다면 그것이 우리 모델이 걸려 넘어지는 자리입니다.

견본 데이터 · k=7. 놓친 7장 가운데 6장이 어두움 집단이고, 밝음은 1장뿐입니다.
특성놓친 7개잡은 22개차이
반사도1.21.2−0.0
밝기151.0235.2−84.2
투명도48.063.4−15.4
이물질21.214.8+6.4
찌그러짐6.44.4+2.1

다섯 특성 가운데 넷이 한쪽으로 쏠려 있습니다. 놓친 것은 어둡고, 덜 비쳐 보이고, 이물질이 많고, 더 찌그러져 있습니다. 어두운 데서 찍으면 투명도가 덜 보인다는 것까지 표가 말해 줍니다.

⚠️ 오류 분석의 결론을 “데이터를 더 모으자”로 끝내지 마라

그 문장은 아무것도 정하지 않습니다. 이 표가 가리키는 답은 하나입니다 — 어두운 데서 찍은 ‘가능’ 사진을 더 모은다. 아무 사진이나 더 모으면 밝음 집단만 더 뚱뚱해집니다. 무엇을 더 모을지가 나오지 않으면 오류 분석을 한 것이 아닙니다. 이 한 문장이 다음 시간 실험 기록표의 첫 줄이 됩니다.

코드를 만지다 걸리는 함정 하나

“MIN_GROUP을 15에서 5로 바꾸면 경고가 사라지겠지” 하고 맨 위 값을 고쳐 보는 학생이 반드시 나옵니다. 고쳐도 아무 일도 일어나지 않습니다. check_sizes()는 여전히 “15개는 넘겨야”라고 찍습니다.

파이썬은 def 줄을 읽는 그 순간에 기본값을 한 번 묶어 둡니다. 나중에 MIN_GROUP을 바꿔도 이미 묶인 값은 따라오지 않습니다. 정말 바꾸려면 인자로 넘겨야 합니다 — by_group(triples, 5). “설정을 바꿨는데 반영이 안 된다”의 정체가 대개 이것입니다.
💻

손으로 ③ — 우리 팀 집단은 몇 개가 필요한가 (2분)

자기 데이터를 쓰는 팀을 위한 짧은 점검기입니다. 견본으로 진행하는 팀은 그냥 한 번 실행해 보고 넘어가세요. 맨 위 세 줄만 우리 것으로 바꾸면 됩니다.

모자란 집단이 있으면 그 숫자가 다음 시간까지 할 일이 됩니다. “데이터를 더 모으자”가 아니라 “어두움에서 찍은 가능 사진을 열두 장 더”처럼 적을 수 있게 됩니다.

📊

읽을거리 — 이 두 표는 코드가 이미 찍어 놓았다

전체는 얌전한데 한 집단이 무너진다 (【8】)

“전체는 그럭저럭인데 한 집단만 망가지는 판”을 일부러 만들 필요가 없습니다. k만 갈아 끼우면 우리 데이터에서 이미 나옵니다.

어두움 집단의 기준선은 65.0%입니다. 마지막 칸이 음수면 그 집단에서는 아무것도 안 하느니만 못합니다.
k전체밝음어두움어두움 재현율어두움 − 기준선판정
170.8%78.6%60.0%53.8%−5.0%p바보 모델보다 나쁘다
381.2%92.9%65.0%53.8%+0.0%p바보 모델과 똑같다
583.3%92.9%70.0%69.2%+5.0%p
785.4%96.4%70.0%53.8%+5.0%p전체 1등
979.2%96.4%55.0%38.5%−10.0%p바보 모델보다 나쁘다
1575.0%96.4%45.0%23.1%−20.0%p바보 모델보다 나쁘다
2575.0%96.4%45.0%30.8%−20.0%p바보 모델보다 나쁘다

k를 키우면 전체는 70.8%에서 85.4% 사이에서 얌전히 움직이고, 밝음은 96.4%에서 꿈쩍도 하지 않습니다. 그런데 어두움은 70.0%에서 45.0%까지 내려앉습니다. k가 1·9·15·25일 때는 그 집단의 기준선보다도 낮습니다. 전체 정확도만 보고 k를 골랐다면 이 사실을 끝까지 몰랐을 것입니다.

더 잘게 쪼개면 (【9】)

촬영조건에 ‘찌그러짐이 심한가(6점 이상)’를 곱해 넷으로 쪼개 보면 이렇게 됩니다.

이름을 줄여 적었습니다 — 밝=밝음 · 어=어두움 / 구김=찌그러짐 6점 이상 · 멀쩡=5점 이하.
집단n정확도재현율읽어도 되나
전체4885.4%75.9%읽어도 된다
밝·구김988.9%80.0%표본이 적다
밝·멀쩡19100.0%100.0%읽어도 된다
어·구김875.0%50.0%표본이 적다
어·멀쩡1266.7%55.6%표본이 적다

격차가 26.4%p에서 33.3%p로 벌어졌습니다. 그런데 넷 중 셋이 15개 미만이 되었습니다. 100.0%라고 적힌 칸도 19장에서 나온 값입니다.

⚠️ 이 표를 “더 잘게 쪼개는 게 좋다”로 읽지 마라

결론은 반대입니다. 쪼갤수록 격차는 커 보이고 숫자는 못 믿게 됩니다. 둘은 늘 같이 옵니다. 그래서 쪼개는 기준은 ‘무엇이 궁금한가’로 정하지, ‘얼마나 갈라지나’로 정하지 않습니다. 갈라지는 쪽만 골라 발표하면 그것은 분석이 아니라 고르기입니다. 더 잘게 쪼개고 싶다면 답은 하나입니다 — 데이터를 더 모읍니다.

스프링 모눈공책에 볼펜으로 글씨를 적어 내려가는 손
오늘 화면에 뜬 표는 새로 고침 한 번이면 사라집니다. 【3】과 【4】의 숫자는 손으로 옮겨 적어 두세요 — 다음 시간 실험 기록표의 첫 줄이 오늘의 이 두 표에서 나옵니다. 출처: Tookapic, Wikimedia Commons (CC0)
📖

정리 — 오늘 손에 쥔 것

오늘 한 일은 한 줄을 여러 줄로 만든 것입니다. 정확도 85.4%는 사라지지 않았습니다. 다만 그 옆에 이제 이런 줄들이 붙어 있습니다.

📖 오늘의 한 줄 (견본 데이터)

전체 85.4%는 밝음 96.4%(n=28)와 어두움 70.0%(n=20)를 뭉갠 값이고, 어두움에서는 그 집단의 기준선을 겨우 +5.0%p 넘는다. 놓친 7장 중 6장이 어두움이다.

오늘의 산출물 — 다음 시간에 이 셋을 가져옵니다

  • 집단별 표(과제 ④에서 채운 것) — 집단 이름 · n · 정확도 · 정밀도 · 재현율. n을 빼면 표가 아닙니다.
  • 그 집단의 기준선과의 차이 — 가장 낮은 집단이 기준선을 몇 %p 넘었는지 한 줄. 같은 표의 마지막 칸입니다.
  • 다음에 무엇을 더 모을지 한 문장 — “어두운 데서 찍은 ‘가능’ 사진을 ○장 더”처럼 수를 넣어서.

점검표 — 발표 전에 스스로 걸러 낼 것 다섯

이렇게 적었다면이렇게 고친다
“정확도 85.4%입니다”만 적었다가장 낮은 집단의 값과 n을 같은 줄에 붙인다
“어두움 70%”라고만 적었다n=20과 그 집단의 기준선 65.0%를 함께 적는다
“정밀도 100%, 완벽합니다”헛짚지 않았을 뿐이고 7장을 놓쳤다고 적는다
“재현율 75.9%”라고만 적었다무엇을 1로 두었는지(‘가능’)를 함께 적는다
“데이터를 더 모으겠습니다”무엇을 몇 장 더 모을지 적는다
💡 여기까지 못 했으면 이렇게 하세요

집단 열이 아직 없는 팀 · 오늘은 견본으로 진행하고, 다음 시간까지 집단 열을 하나 정해 옵니다. 이미 모은 데이터에서 새로 재지 않고 뽑을 수 있는 것을 고르세요 — 요일, 찍은 사람, 학년, 오전·오후. 한 집단에 15개 이상이 되게 나뉘는 기준이어야 합니다.

모델이 아직 안 도는 팀 · 8차시 버그 셋(0으로 나누기 · 테스트가 훈련과 같음 · k가 안 먹힘)을 먼저 잡습니다. 그동안 오늘 진도는 견본 데이터로 그대로 끝낼 수 있습니다. 위 실행기의 【0】 상자에 160행짜리 견본 표가 이미 들어 있어 한 글자도 고치지 않고 [▶ 실행]만 누르면 【1】부터 【9】까지 다 나옵니다.

집단이 15개가 안 되는 팀 · 그 숫자를 %로 적지 마세요. “어두움 3장 중 2장을 맞혔다”처럼 분수 그대로 적고, 다음 시간까지 몇 개를 더 모을지만 정합니다. 손으로 ③의 점검기가 몇 개가 모자란지 알려 줍니다.

다음 시간에는 오늘 만든 표를 들고 설정을 바꿔 가며 실험 기록을 남깁니다. 그때 알게 될 것이 하나 있습니다 — 전체 정확도 1등과 약한 집단 1등이 서로 다른 설정이라는 것입니다. 오늘 k=5와 k=7을 나란히 본 것이 그 예고편이었습니다.

✅

확인 문제

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. TP · FP · FN · TN 네 칸을 우리 팀 주제의 말로 하나씩 옮겨 적으세요. 그리고 우리 주제는 놓침(FN)과 헛짚음(FP) 가운데 어느 쪽을 더 겁내는지, 그 까닭과 함께 한 문장으로 쓰세요.
📖 모범 답안

견본(페트병)이라면 이렇게 옮깁니다. TP = 재활용 가능한 병을 가능이라 맞힌 것, FP = 재활용이 안 되는 병을 가능이라 한 것(선별대에 잘못 올라가 뒤에서 다시 걸러야 한다), FN = 재활용 가능한 병을 불가라 한 것(되살릴 수 있었는데 버려진다), TN = 안 되는 병을 불가라 맞힌 것.

어느 쪽을 겁내는지는 주제가 정합니다. 재활용 선별이라면 되살릴 병을 버리는 FN이 더 아깝기 때문에 재현율을 봅니다. 반대로 사람을 지목하는 문제(위험군 선별·신고 자동 처리)라면 억울한 FP가 더 무거우므로 정밀도를 봅니다. 계산이 아니라 결정이고, 그 결정을 모델 카드에 적어야 합니다.

2. 해부대에서 k를 15로 두었을 때 전체 · 밝음 · 어두움 정확도와, 어두움이 그 집단의 기준선을 넘었는지를 적으세요. 전체 정확도만 보고 k를 골랐다면 무엇을 놓쳤겠습니까?
📖 모범 답안

전체 75.0% · 밝음 96.4% · 어두움 45.0%입니다. 어두움의 기준선은 65.0%이므로 −20.0%p, 즉 기준선보다 한참 아래입니다. 그 집단에서는 늘 ‘가능’이라고만 외치는 바보 모델보다 나쁩니다.

전체만 보면 75.0%라서 “k=7(85.4%)보다 조금 못하다” 정도로 읽힙니다. 밝음도 96.4%로 꿈쩍하지 않습니다. 망가진 곳은 어두움 하나뿐인데, 전체 표에는 그 붕괴가 10%p 남짓으로만 나타납니다. 집단을 갈라 재지 않으면 어두움 사진을 쓰는 사람에게 무슨 일이 벌어졌는지 끝까지 알 수 없습니다.

3. 코드 【5】의 표에서 놓친 7개와 잡은 22개의 밝기 평균은 각각 얼마이고 차이는 얼마입니까? 이 숫자를 근거로, 다음 시간까지 무엇을 더 모을지 한 문장으로 쓰세요.
📖 모범 답안

놓친 7개의 밝기 평균은 151.0, 잡은 22개는 235.2로 84.2만큼 어둡습니다. 투명도도 48.0 대 63.4로 15.4 낮고, 이물질은 6.4 많고, 찌그러짐은 2.1 더 심합니다. 다섯 특성 가운데 넷이 한쪽으로 쏠려 있습니다.

그래서 답은 “데이터를 더 모으자”가 아니라 “어두운 데서 찍은 ‘가능’ 사진을 더 모은다”입니다. 놓친 7장 중 6장이 어두움 집단이라는 사실이 이 문장을 뒷받침합니다. 아무 사진이나 더 모으면 이미 96.4%인 밝음 집단만 커지고 어두움은 그대로입니다.

4. 어떤 팀이 이렇게 적었습니다. “어두움 집단은 70.0%로, 기준선 60.4%보다 9.6%p 높으므로 잘 작동하고 있다.” 이 문장의 어디가 틀렸고, 바르게 고치면 어떻게 됩니까?
📖 모범 답안

전체 기준선(60.4%)과 견준 것이 틀렸습니다. 기준선은 집단마다 다시 재야 합니다. 어두움 집단 안에서 늘 ‘가능’이라고만 답하면 65.0%가 나옵니다. 따라서 우리 모델은 그 집단에서 +5.0%p일 뿐이고, +9.6%p는 실제보다 후하게 읽은 값입니다.

고쳐 쓰면 이렇게 됩니다 — “어두움 집단(n=20)에서 우리 모델은 70.0%로, 그 집단의 기준선 65.0%를 5.0%p 넘는 데 그쳤다. 그 집단만 놓고 보면 늘 ‘가능’이라고만 말하는 모델과 거의 같다.”

덧붙여, 어두움의 기준선(65.0%)이 밝음의 기준선(57.1%)보다 높다는 것도 함께 알아 두어야 합니다. “어두움이 더 어렵다”와 “어두움의 기준선이 더 높다”는 서로 다른 사실입니다.

5. 넷으로 쪼갰더니 격차가 26.4%p에서 33.3%p로 커졌습니다. 어떤 팀이 “더 잘게 쪼갤수록 편향이 잘 보이니 여덟으로 더 쪼개겠다”고 합니다. 동의합니까?
📖 모범 답안

동의할 수 없습니다. 넷으로 쪼갠 순간 네 집단 중 셋이 15개 미만이 되었습니다 (밝·구김 9 · 어·구김 8 · 어·멀쩡 12). 100.0%라고 적힌 밝·멀쩡도 19장에서 나온 값입니다. 격차가 커 보이는 것과 숫자를 믿을 수 없게 되는 것은 늘 함께 옵니다. 여덟으로 쪼개면 집단 하나가 대여섯 장이 되고, 한 장만 뒤집혀도 20%p 가까이 움직입니다.

쪼개는 기준은 ‘무엇이 궁금한가’로 정합니다. “촬영 조건이 결과를 가르는가”가 궁금해서 촬영조건으로 쪼갠 것이지, 갈라지는 그림이 나올 때까지 기준을 바꿔 본 것이 아닙니다. 갈라지는 쪽만 골라 발표하면 분석이 아니라 고르기입니다. 정말 더 쪼개고 싶다면 답은 하나입니다 — 데이터를 더 모읍니다.

6. 우리 팀 데이터에서 집단 열로 무엇을 두겠습니까? 그 기준으로 나누면 가장 작은 집단이 몇 개가 되는지 세어 보고, 15개에 못 미친다면 어떻게 하겠는지 쓰세요. 그리고 왜 하필 15인지 근거를 한 줄로 밝히세요.
📖 모범 답안

집단 열은 이미 모은 데이터에서 새로 재지 않고 뽑을 수 있는 것이 좋습니다 — 요일, 오전·오후, 찍은 사람, 학년, 수집한 장소. 이름표(맞히려는 열)를 집단으로 두면 안 됩니다. 집단 안에 정답이 한 종류만 남아 지표가 0%나 100%로만 나옵니다. 수치 열을 그대로 쓰는 것도 안 됩니다. 값 하나하나가 집단이 되어 15개를 넘는 집단이 하나도 안 생깁니다 — 구간으로 묶어야 집단이 됩니다(예: 찌그러짐 6점 이상/이하).

15의 근거는 이렇습니다. 우리가 그 표에서 읽어 내려는 것이 두 집단의 격차 26.4%p이므로, 한 집단의 %가 흔들리는 폭이 그보다 좁아야 합니다. 95% 폭은 대략 2×√(p(1−p)/m)이고, p=70.0%를 넣어 26.4%p보다 좁아지는 m을 찾으면 13이 나옵니다. 여유를 두어 15로 정했습니다. 이 15는 통계학의 일반 규칙이 아니라 우리 격차에 맞춰 우리가 계산한 값입니다. 더 작은 격차를 보려면 더 큰 집단이 필요합니다.

15개에 못 미치면 % 대신 분수 그대로 적고, 몇 개가 모자란지 세어 다음 시간까지의 할 일로 옮깁니다. 손으로 ③의 점검기가 그 수를 계산해 줍니다.

🔁 되돌아보기

오늘 정확도 한 줄을 집단별로 쪼개고, 각 집단의 기준선과 견주고, 틀린 것들의 공통점까지 찾았다. 다음 시간에는 설정을 하나씩 바꿔 가며 실험 기록을 남기고, 오늘 찾은 “무엇을 더 모을지” 한 문장을 모델 카드의 ‘한계’ 칸에 옮겨 적는다.

🔎

더 알아보기

한 줄을 쪼개 보는 일이 교실 밖에서는 어떻게 쓰이고, 쪼갠 숫자는 어디까지 믿을 수 있나

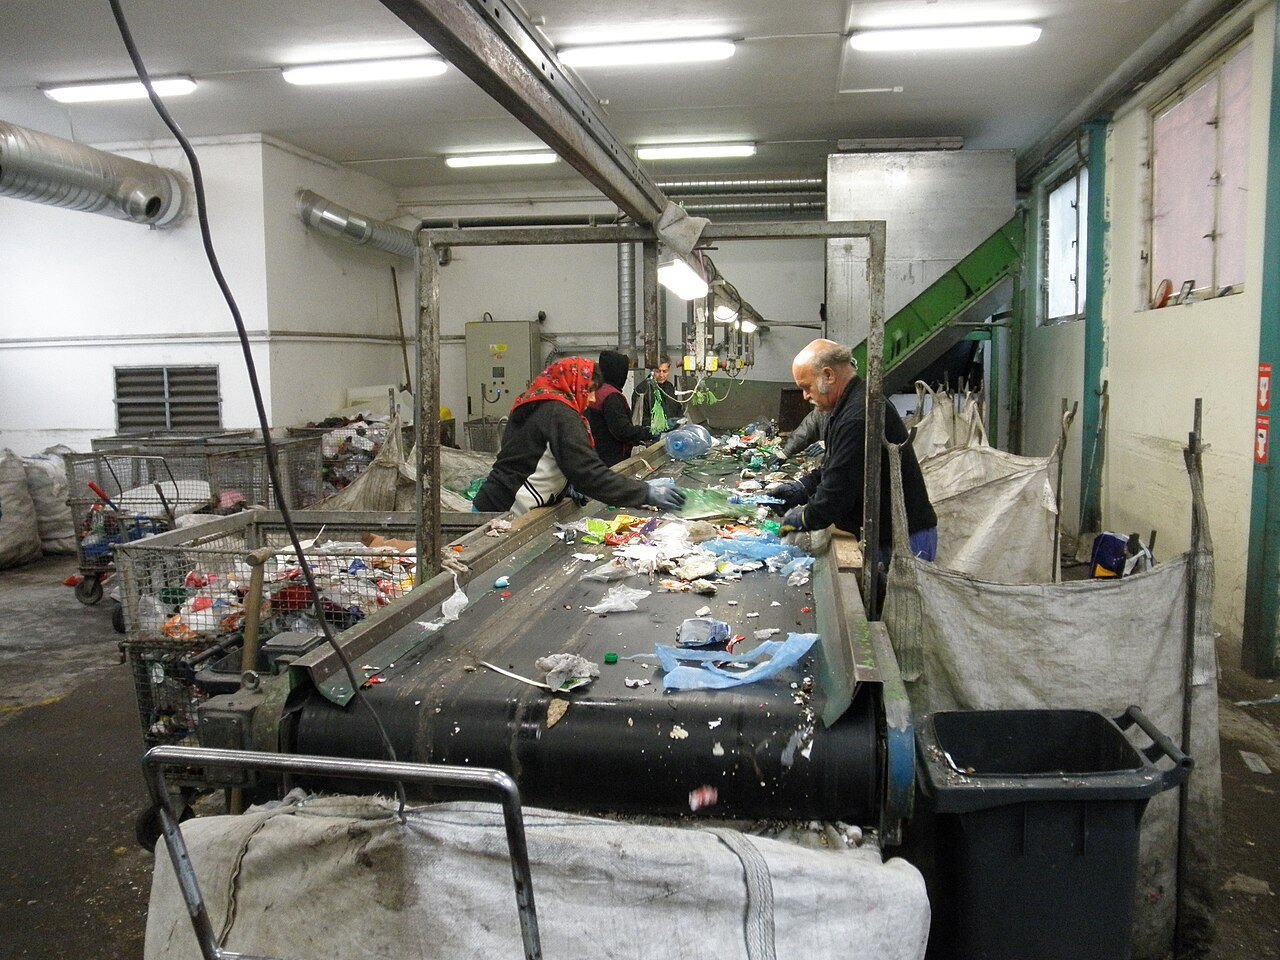
재활용 선별장에서 작업자들이 검은 컨베이어 벨트 양옆에 서서 흘러가는 플라스틱 쓰레기를 손으로 골라내는 모습. 옆에 큰 자루와 철망 수레가 놓여 있다
현장

검은 병은 기계 눈에 안 보인다 — 선별장의 ‘어두움’ 집단

사진은 체코 올로모우츠의 재활용 선별장입니다. 작업자들이 컨베이어 벨트를 따라 서서, 흘러가는 플라스틱을 손으로 골라 자루에 나눠 담고 있어요. 규모가 큰 선별장에서는 이 일의 상당 부분을 근적외선 선별기가 맡습니다. 벨트 위 물체에 빛을 비추고 되돌아온 근적외선의 무늬로 PET·PE·PP 같은 재질을 알아본 뒤, 골라낼 물체가 지나가는 순간 압축 공기를 뿜어 다른 통로로 날려 보내지요.

그런데 이 기계에도 오늘 우리가 찾은 것과 같은 모양의 약점이 있습니다. 검은 플라스틱에 흔히 쓰는 안료인 카본 블랙은 근적외선을 거의 다 삼켜서, 센서로 되돌아오는 빛이 없습니다. 재질이 재활용되는 PET라도 ‘읽을 수 없음’이 되어 잔재물 쪽으로 빠지기 쉬워요. 오늘 표의 말로 하면 ‘검은색’이라는 한 집단에만 놓침(FN)이 몰리는 것입니다.

투명한 병이 대부분인 날의 전체 선별률만 보고했다면 이 약점은 드러나지 않았을 것입니다. 업계의 대응은 크게 두 갈래였습니다 — 근적외선에 보이는 다른 검은 안료로 포장재 쪽을 바꾸는 것, 그리고 다른 방식으로 재질을 읽는 센서를 더하는 것. ‘어두운 데서 찍은 가능 사진을 더 모은다’는 오늘의 결론과 견주어 보면, 약한 집단을 고치는 길이 데이터를 더 모으는 것 하나만은 아니라는 것이 보입니다.

사진: 체코 올로모우츠 재활용 선별장의 손 선별 벨트 · 출처: Michal Maňas, Wikimedia Commons (CC BY 3.0)

전부 맞혀 100%가 나왔다 — 실제로는? 관찰한 100% 95% 확신으로 남는 범위 3장 36.8% ~ 100% 19장 85.4% ~ 100% 50장 94.2% ~ 100% 30% 50% 70% 90% 100% 식 √(p(1−p)/m)은 여기서 폭을 0이라고 말한다
원리 더 깊이

100%에도 흔들림이 있다 — ‘3의 법칙’

【7】에서 흔들림의 폭을 √(p(1−p)/m)으로 쟀습니다. 그런데 이 식에 p = 100%를 넣으면 폭이 0이 됩니다. 【9】의 밝·멀쩡처럼 19장을 전부 맞힌 집단은 정말 “흔들림 없이 100%”일까요? 아닙니다. 이 식은 어림식이라서, p가 0%나 100%에 붙어 있고 m이 작을 때 가장 크게 틀립니다.

물음을 뒤집어 봅시다. 실제 정확도가 85.4%인 모델이 19장을 연달아 맞힐 확률은 0.854 ** 19 ≈ 0.05, 곧 5%입니다. 스무 번에 한 번은 일어나는 일이지요. 그래서 “19장 중 19장”만 보고는 실제 정확도가 85% 남짓일 가능성을 95% 확신으로 지울 수 없습니다 — 공교롭게도 우리 모델의 전체 정확도와 같은 값입니다. 같은 계산으로 3장이면 36.8%까지, 50장이어도 94.2%까지 내려갑니다.

통계에는 이것을 빠르게 어림하는 3의 법칙(rule of three)이 있습니다. n번 중 틀린 것을 한 번도 못 봤다면, 실제 오류율은 대략 3/n까지 있을 수 있다고 보는 것입니다. 19장이면 3/19 ≈ 16%입니다. 그래서 표에 100%가 보이면 먼저 n을 보고, “틀린 것을 아직 못 봤다”로 읽습니다.

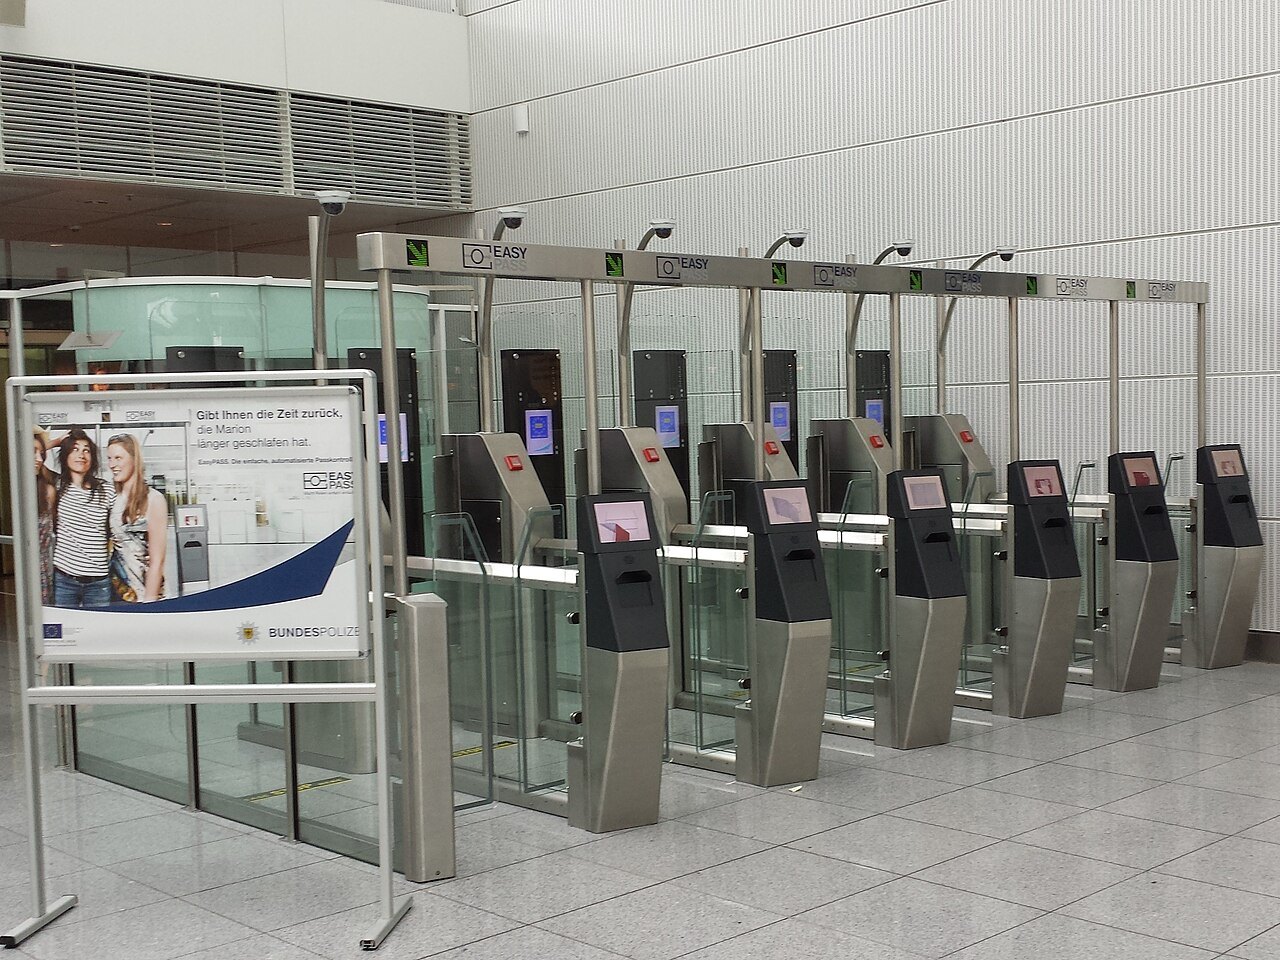
공항 안에 나란히 선 자동 출입국 심사대 여섯 대. 기둥마다 카메라가 달려 있고 여권을 올리는 단말과 유리문이 있으며, 왼쪽에 안내 광고판이 서 있다
현장

얼굴 인식 189개를 집단별로 쪼갠 시험 — 미국 NIST 보고서

사진은 독일 뮌헨 공항의 자동 출입국 심사대 EasyPASS입니다. 여권 속 사진과 카메라에 찍힌 얼굴을 맞대어 같은 사람이면 문이 열려요. 이 기계에도 오늘의 네 칸이 있습니다 — 본인인데 문이 안 열리는 것(놓침)과 남인데 문이 열리는 것(헛짚음). 앞의 것은 불편이지만 뒤의 것은 보안 사고라서, 이런 장치는 헛짚음을 아주 낮게 잡도록 맞춥니다. 무엇을 더 겁내는지가 설정을 정한다는 것, 오늘 개념 2와 같은 이야기입니다.

2019년 12월 미국 국립표준기술연구소(NIST)는 99개 개발사의 얼굴 인식 알고리즘 189개를 시험하고, 성능을 인구 집단별로 쪼갠 보고서를 냈습니다. 두 사진이 같은 사람인지 가리는 일대일 대조에서 많은 알고리즘이 서아프리카·동아프리카·동아시아 사람 얼굴에 대해 동유럽 사람보다 헛짚음을 10배에서 100배까지 더 냈습니다. 다만 격차는 알고리즘마다 크게 달라서, 집단 사이 차이가 작은 알고리즘도 있었습니다 — ‘얼굴 인식은 이렇다’가 아니라 ‘이 모델은 이렇다’로 읽어야 하는 까닭입니다.

이런 비교가 가능했던 것은 집단마다 표본이 매우 컸기 때문입니다. 헛짚음이 수만 번에 한 번꼴로 일어나는 장치라면, 오늘 【7】에서 한 것처럼 흔들림이 격차보다 좁아지려면 집단마다 엄청난 수의 사진이 필요합니다. 우리 표의 “15장은 넘겨야” 규칙과 같은 물음을, 규모만 바꾸어 풀어낸 셈입니다.

사진: 뮌헨 공항 EasyPASS 자동 출입국 심사대 · 출처: EasyPASS MUC.jpg: Bis gleich am Teich! Devilfighter_de derivative work: Bonus bon, Wikimedia Commons (CC BY-SA 3.0 de)