단원 홈
3단원 · 6차시

자신 있게 틀리는 기계
언제 믿고 언제 확인할 것인가

2단원 12차시에서 우리는 기준점을 옮기면 정밀도와 재현율이 반대로 움직이는 것을 보았습니다. 그때 저울에 올라간 것은 두 지표였지요. 오늘은 같은 저울에 사람의 시간을 올립니다. 인공지능이 "90% 확신합니다"라고 말할 때, 그 90%는 정말 열 번 중 아홉 번을 뜻할까요?

성취기준 12인기03-03
환각확신도 보정과신 자동화 편향확인 문턱 비판적 수용
🎯 학습 목표
  • 생성형 인공지능이 왜 그럴듯하게 틀리는지를 모델이 하는 일로 설명하고, 잘 틀리는 자리를 유형으로 나눌 수 있다.
  • 확신도 구간별 실제 정답률을 보정 곡선으로 그려 과신의 크기를 %p로 말할 수 있다.
  • 확인 문턱을 옮기며 사람의 노동량과 남는 위험이 맞바뀌는 것을 숫자로 재고, 어디에 사람을 배치할지 근거를 대어 정할 수 있다.
🤔

여는 장면 — 존재하지 않는 판례 여섯 건

2023년, 미국 뉴욕남부연방지방법원에 한 서면이 제출되었습니다. 그 안에는 자기 주장을 뒷받침하는 판례 여섯 건이 사건 번호와 인용 형식까지 갖춰 적혀 있었습니다. 상대편 변호인이 그 판례들을 찾아보려 했지만 어느 데이터베이스에도 나오지 않았습니다. 법원이 직접 확인한 결과, 여섯 건은 전부 존재하지 않는 판결이었습니다. 생성형 인공지능이 만들어 낸 것이었고, 제출한 쪽은 그것을 확인하지 않았습니다. 법원은 2023년 6월 22일 5,000달러의 제재를 내렸습니다.

출처: Mata v. Avianca, Inc., 678 F.Supp.3d 443 (S.D.N.Y. 2023). 이 차시는 사건에 관련된 사람이나 회사를 평가하지 않습니다. 우리가 볼 것은 절차입니다.

여기서 물어야 할 것은 "인공지능이 틀렸다"가 아닙니다. 그건 이미 압니다. 진짜 물음은 이것입니다 — 왜 아무도 확인하지 않았을까요?

답이 너무 그럴듯했기 때문입니다. 사건 번호가 있었고, 인용 형식이 맞았고, 문장은 매끄러웠습니다. 틀린 답이 틀려 보이지 않았습니다. 이것이 오늘 다룰 문제의 정확한 모양입니다. 인공지능이 만드는 위험은 "말이 안 되는 소리를 한다"가 아니라 "말이 되는 소리를 자신 있게 한다" 쪽에 있습니다.

🎯 오늘 답할 물음 셋
  • 인공지능이 "확신도 90%"라고 말할 때, 그 90%는 열 번 중 아홉 번을 뜻할까?
  • 아니라면, 어디까지를 사람이 확인해야 할까?
  • 그 확인은 누가, 몇 시간 동안 하는가?

세 번째 물음이 오늘의 무게 중심입니다. 2단원 12차시에서 기준점을 밀 때는 놓친 환자와 억울한 사람이 맞바뀌었습니다. 오늘 문턱을 밀면 맞바뀌는 것은 남는 오류와 사람이 들여다봐야 하는 시간입니다. 저울의 한쪽에 사람이 올라가 있습니다.

1

환각은 고장이 아니라 작동 방식의 결과다

생성형 언어 모델이 하는 일을 한 줄로 줄이면 이렇습니다 — 앞의 말이 주어졌을 때 다음에 올 말로 가장 그럴듯한 것을 고른다. 2단원에서 우리가 만든 모델들이 "이 사진은 강아지인가"를 골랐다면, 이 모델은 "다음 낱말은 무엇인가"를 고릅니다. 고르는 기준은 학습한 글에서 그런 자리에 그런 말이 얼마나 자주 왔는가입니다.

이 짜임에는 중요한 구멍이 하나 있습니다. '모른다'라는 선택지가 따로 없습니다. 다음에 올 말의 후보 중에는 늘 무언가가 가장 그럴듯하고, 모델은 그것을 고릅니다. 아는 것과 모르는 것을 갈라 주는 스위치가 안에 없습니다. 그래서 근거가 없을 때도 근거가 있을 때와 똑같이 매끄러운 문장이 나옵니다. 이런 오류를 환각(hallucination)이라고 부릅니다.

이름이 오해를 부르기 쉽습니다. 기계가 헛것을 보는 것이 아닙니다. 모델은 늘 하던 일을 하고 있고, 그 일의 부작용이 환각입니다. 그래서 "이 버그만 고치면 없어진다"는 종류의 문제가 아닙니다. 줄일 수는 있어도 0으로 만들기는 어렵고, 그래서 0이 아니라는 전제 위에서 절차를 짜야 합니다.

잘 틀리는 자리는 정해져 있다

"그럴듯한 말"과 "맞는 말"이 가장 크게 벌어지는 자리를 생각해 봅시다.

🏷️

고유명사

사람 이름·기관 이름·작품 제목. 형태만 그럴듯하면 되는 자리라 있을 법한 이름이 쉽게 만들어집니다.

🔢

숫자와 통계

3.2%와 3.7%는 문장에서 똑같이 자연스럽습니다. 자릿수만 맞으면 어색하지 않은 자리입니다.

🗓️

최신 사실

모델이 학습을 끝낸 뒤에 바뀐 제도·조항·담당 기관. 모델에게는 바뀌기 전 세상이 여전히 현재입니다.

🔗

출처와 인용

논문 제목·판례 번호·쪽 번호는 형식이 뚜렷해서 흉내 내기 가장 쉽습니다. 여는 장면이 정확히 이 자리였습니다.

반대로 상식적인 추론—시간 순서 따지기, 간단한 셈, 크기 비교—은 상대적으로 덜 틀립니다. 학습한 글에 그런 패턴이 아주 많이 들어 있기 때문입니다. 다만 '덜 틀린다'가 '안 틀린다'는 뜻은 아닙니다. 잠시 뒤 실습에서 확인하게 됩니다.

ℹ️ 바깥 세상의 숫자 하나 — 전용 도구도 0은 아니다

2024년 스탠퍼드 연구진(RegLab·HAI)은 변호사들이 실제로 쓰는 상용 법률 인공지능 검색 도구 셋을 조사했습니다. 출처를 붙이도록 설계하고 법률 자료에 특화한 도구인데도, 논문 초록은 이 도구들이 17~33%의 비율로 환각을 일으킨다고 적었습니다.

출처: Magesh 외, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, arXiv:2405.20362 (2024), Stanford RegLab / HAI.

⚠️ 이 값은 논쟁 중인 추정치입니다. 도구를 만든 쪽에서 측정 방법에 반론을 냈고 연구진이 보강을 예고했습니다. 범위가 17에서 33까지 넓은 것은 도구마다 값이 달랐기 때문이고, 도구별로 갈라 놓은 수치는 이 교과서가 원문에서 확인하지 못해 적지 않습니다. 그래도 방향 하나는 분명합니다 — 가장 잘 준비된 자리에서도 환각률은 0이 아니었습니다.

⚠️ 여기서 결론을 앞질러 내지 맙시다

"그러니까 인공지능은 못 믿는다"는 문장은 편하지만 틀렸습니다. 잠시 뒤 우리 데이터에서 보게 될 텐데, 확신도가 높은 구간의 정답률은 낮은 구간보다 분명히 높습니다. 신호가 없는 것이 아니라 눈금이 어긋나 있는 것입니다. 일방적인 수용도, 일방적인 거부도 오늘의 답이 아닙니다. 오늘 우리가 찾을 것은 "어디에 사람을 세울 것인가"입니다.

흰 배경 앞에 선 흰색 소셜 로봇 페퍼. 큰 검은 눈과 작게 웃는 입, 가슴의 화면에 pepper라는 글자가 떠 있고 두 손을 허리에 얹고 있다
큰 눈과 웃는 입, 가슴의 화면으로 말을 거는 소셜 로봇 페퍼(Pepper). 겉모습이 친근하다는 것과 말한 내용이 맞는다는 것은 서로 다른 문제입니다. 매끄러운 말투는 정확함을 보증하지 않는데도, 사람은 자꾸 둘을 이어 읽습니다. 출처: Softbank Robotics Europe, Wikimedia Commons (CC BY-SA 4.0)
2

확신도의 눈금 — 90%라고 말할 때 열 번 중 아홉 번인가

많은 인공지능 시스템은 답과 함께 확신도를 함께 내놓습니다. "이 사진은 고양이입니다(0.93)", "이 문장의 감정은 긍정입니다(0.71)" 같은 식이지요. 2단원 12차시에서 우리가 기준점을 밀었던 그 0에서 1 사이의 점수가 바로 이것입니다.

여기서 자연스럽게 생기는 기대가 있습니다. "확신도 90%라고 말한 답을 100개 모으면 그중 90개쯤은 맞겠지." 이 기대가 실제로 지켜지는 상태를 보정(calibration)이라고 합니다. 보정이 완벽한 모델을 그림으로 그리면 대각선이 됩니다 — 가로축의 확신도와 세로축의 실제 정답률이 언제나 같으니까요.

과신 모델이 말한 확신도 → ← 실제 정답률 과소신 구역 말한 것보다 잘 맞힌다 과신 구역 말한 것보다 못 맞힌다 완벽한 보정선 확신도 = 정답률 점이 선 아래에 있으면 그 구간은 과신이다 점의 크기 = 그 구간의 건수
보정 곡선을 읽는 법. 점이 대각선 위에 놓이면 눈금이 맞는 것이고, 아래로 내려간 만큼이 과신입니다. 잠시 뒤 시뮬레이터에서 이 그림을 우리 데이터로 직접 그리게 됩니다.

우리가 만든 480건 — 이 숫자들이 어디서 왔는지 먼저 밝힙니다

⚠️ 이 절의 표는 '우리가 만든 계산'입니다

아래 표에 나오는 값은 실제 어느 제품의 성능 기록이 아닙니다. 우리가 규칙을 정해 만든 가상 응답 480건을 집계한 값입니다. 정한 규칙은 이렇습니다 — 응답을 유형 네 가지 × 120건으로 만들고, 확신도는 50~99% 중에서 높은 값이 더 자주 나오도록 뽑고, 실제로 맞을 확률은 0.50 + 0.65 ×(확신도−50)/100 에 유형별 보정을 더해 정했습니다. 기울기를 1이 아니라 0.65로 둔 이 한 줄이 과신을 만듭니다. 그러니 아래 숫자는 "세상이 이렇더라"가 아니라 "이 가정에서는 이렇게 되더라"로 읽어야 합니다. 실습에서는 이 가정 자체를 여러분이 바꿔 보게 됩니다.

규칙을 정해 놓고 480건을 만든 뒤, 확신도 구간별로 실제 정답률을 세어 보았습니다.

확신도 구간건수평균 확신도 실제 정답률과신 (확신도 − 정답률)
50 ~ 60 %5853.6 % 55.2 %−1.6 %p
60 ~ 70 %7363.7 % 57.5 %+6.1 %p
70 ~ 80 %10174.8 % 63.4 %+11.4 %p
80 ~ 90 %11084.6 % 71.8 %+12.8 %p
90 ~ 100 %13894.5 % 77.5 %+17.0 %p
우리가 만든 480건의 보정표(우리가 만든 계산입니다). 구간별 격차를 건수로 가중평균한 평균 보정 오차는 11.4 %p이고, 가장 크게 어긋난 칸은 90~100 %입니다. 전체로 보면 모델은 평균 78.5 % 확신했는데 실제로는 67.5 %(324/480) 맞혔습니다 — 차이 11.0 %p. 480건 중 실제로 틀린 것은 156건입니다.

표에서 두 가지를 동시에 읽어야 합니다. 하나만 읽으면 반드시 한쪽으로 기웁니다.

① 눈금은 어긋나 있다

"90~100% 확신"이라고 말한 138건 중 실제로 맞은 것은 77.5%입니다. 90%가 아니라 77.5%입니다. 그리고 이 어긋남은 확신이 높아질수록 커집니다(−1.6 → +6.1 → +11.4 → +12.8 → +17.0 %p). 즉 이 모델은 자신 있을 때 자기를 가장 크게 과대평가합니다.

② 그래도 신호는 있다

실제 정답률 자체는 구간이 올라갈수록 55.2% → 57.5% → 63.4% → 71.8% → 77.5%로 분명히 오릅니다. 확신도가 높은 답이 실제로 더 자주 맞습니다. 확신도가 쓸모없는 것이 아니라 눈금이 어긋나 있는 것입니다. 고칠 것은 '믿을지 말지'가 아니라 '눈금'입니다.

두 읽기를 합치면 오늘의 실무적 결론이 나옵니다. 확신도는 줄을 세우는 데는 쓸 만하고, 한 건을 보증하는 데는 못 쓴다. "확신도 90% 이상은 확인 안 해도 된다"는 규칙이 왜 위험한지가 여기서 나옵니다 — 우리 480건에서 확신도 90% 이상인데 틀린 응답이 31건 있었고, 그중에는 확신도 98%짜리도 있었습니다. 반대로 확신도 60%대인데 맞은 응답은 42건이었습니다. 확신도는 한 건에 대한 보증이 아니라 "이쪽이 더 자주 맞더라"는 기울기입니다.

💡 확신도와 '신뢰'는 다른 말입니다

이 교과서에서 확신도는 기계가 자기 답에 매긴 점수를 뜻하고, 신뢰는 사람이 그 시스템을 얼마나 믿는지를 뜻합니다. 둘은 자주 어긋납니다. 오늘 배우는 것을 한 문장으로 줄이면 "기계의 확신도를 사람의 신뢰로 그대로 옮기지 마라"입니다.

⚠️ 1단원 12차시에서도 «확신도»라는 말을 만났습니다 — 규칙 기반 시스템 MYCIN이 규칙 하나하나에 붙였던 −1 ~ +1 값이었죠. 이름은 같지만 다른 것입니다. 그때는 사람이 규칙에 매긴 점수였고, 오늘은 기계가 자기 답에 매긴 점수입니다. 범위도 0 ~ 1로 다르고요. 공교롭게도 두 경우 모두 "그 점수를 누가 무슨 근거로 정했는가"가 뒤따르는 물음입니다 — 1단원에서는 사람이 답해야 했고, 오늘은 데이터로 재야 합니다. 그것이 보정 곡선입니다.

3

사람은 왜 확인을 그만두는가 — 자동화 편향

여는 장면으로 돌아가 봅시다. 판례를 확인하는 일은 어렵지 않습니다. 사건 번호를 검색창에 넣기만 하면 됩니다. 몇 분이면 끝날 일이었습니다. 그런데 하지 않았습니다. 이것은 한 사람의 게으름이라기보다 사람과 자동 도구가 함께 일할 때 되풀이해 나타나는 성향에 가깝습니다. 이 성향에는 이름이 있습니다 — 자동화 편향(automation bias)입니다.

1990년대 말에 이미 이것을 다룬 실험 연구가 있습니다. Skitka·Mosier·Burdick(1999)의 연구는, 매우 정확하지만 완전하지는 않은 자동 보조를 받은 참가자들이 보조 없이 같은 일을 한 참가자들보다 감시 과제에서 오히려 더 못했다고 보고했습니다. 도구가 좋아졌는데 사람의 성과가 나빠진 것입니다.

출처: Skitka, Mosier & Burdick, Does automation bias decision-making?, International Journal of Human-Computer Studies (1999). 이 교과서는 논문의 결론 방향만 인용하며, 구체적인 수치는 원문을 확인하지 못해 적지 않습니다.

정확도가 높을수록 함정이 깊어지는 이유

여기에 오늘 가장 어긋나 보이는 문장이 있습니다. 도구가 정확할수록 사람의 확인은 더 부실해집니다. 왜 그럴까요?

확인이라는 일에는 대가가 있습니다. 시간이 들고, 주의가 들고, 지겹습니다. 그 대가를 치를 만하다고 느끼려면 가끔은 무언가를 잡아내야 합니다. 그런데 100번 중 99번 맞는 도구를 100번 확인하면 99번은 아무것도 나오지 않습니다. 사람의 주의는 이 99번을 견디도록 만들어져 있지 않습니다. 스무 번쯤 헛걸음하고 나면 확인은 형식이 되고, 형식이 된 확인은 사실상 확인이 아닙니다. 그리고 바로 그때 100번째가 지나갑니다.

우리 480건의 문턱 표에서 이것을 숫자로 볼 수 있습니다. 문턱을 95%로 두면 사람이 410건을 확인하는데, 그중 267건은 아무 문제가 없는 응답입니다. 실제로 오류를 잡아내는 것은 143건뿐이지요. 나머지 267건은 봤는데 멀쩡했던 것입니다 — 2단원 12차시에서 거짓양성(FP)이라 불렀던 바로 그 칸이 여기서는 검토자의 헛걸음이라는 이름으로 돌아옵니다. 헛걸음의 비율이 높을수록 사람은 확인을 그만두게 됩니다. (잠시 뒤 실행할 프로그램은 이 칸을 '헛수고'라고 찍습니다. 같은 칸을 가리키는 같은 말입니다.)

어두운 판독실에서 흰 가운을 입은 의사가 모니터 여러 대에 띄운 MRI 영상을 보며 손에 든 녹음기에 소견을 말하는 모습
판독실의 영상의학과 의사가 모니터의 MRI 영상을 보며 소견을 녹음하고 있습니다. 보조 시스템이 의심 부위를 먼저 표시해 주는 곳에서도 마지막으로 읽는 것은 이 자리의 사람이고, 시스템이 잘할수록 그 사람은 "괜찮겠지"로 기울기 쉽습니다. 출처: w:User:Zackstarr, Wikimedia Commons (CC BY-SA 3.0)
위성 지도와 차량 위치 정보가 뜬 대형 화면 벽 앞에 사람들이 서서 화면을 보고 있는 관제실
화면은 시스템이 채우고, 결정은 사람이 합니다. 이때 사람이 몇 건까지 실제로 볼 수 있는가가 오늘 계산할 값입니다. 출처: UrusHyby, Wikimedia Commons (CC0)
📖 '확인하는 사람'을 세워 두는 것만으로는 부족합니다

사람을 한 명 붙여 두고 "최종 판단은 사람이 합니다"라고 적어 두면 안심이 됩니다. 그러나 그 사람이 하루에 몇 건을 보는지, 한 건에 몇 분을 쓸 수 있는지, 틀린 것을 잡았을 때 무슨 일이 일어나는지를 정하지 않으면 그 문장은 장식입니다. 3단원 2차시에서 우리는 이미 이것의 다른 면을 보았습니다 — 인공지능이 양성이라고 부른 것을 사람(의사)이 다시 봐도 끝내 놓치는 사람이 6.9명 남았습니다. 사람도 틀립니다. 오늘 계산에서는 셈을 단순하게 하려고 "사람이 본 것은 다 잡는다"고 두겠지만, 그것이 낙관적인 가정이라는 사실은 잊지 맙시다. 잠시 뒤 그 가정을 풀어 다시 계산해 봅니다.

4

검증은 태도가 아니라 절차다

"비판적으로 받아들이자"는 말은 옳지만 그것만으로는 아무것도 바뀌지 않습니다. 태도는 사람마다 다르고, 바쁘면 사라지고, 했는지 안 했는지 나중에 알 수 없습니다. 바꿀 수 있는 것은 절차입니다. 절차란 누가 무엇을 어떤 순서로 하는지가 적혀 있어서, 했는지 안 했는지를 확인할 수 있는 것을 말합니다.

  1. 출처 되짚기 — 인공지능이 댄 근거를 그 자리에서 원래 자료까지 따라갑니다. 논문이면 논문을, 법이면 조문을, 통계면 발표 기관의 원 자료를 엽니다. 인공지능이 요약해 준 출처 설명을 읽는 것은 되짚기가 아닙니다. 여는 장면이 딱 이 단계에서 멈춘 사례입니다.
  2. 교차 확인 — 서로 독립된 자료 둘 이상에서 같은 사실이 나오는지 봅니다. 같은 보도자료를 옮겨 쓴 기사 다섯 건은 독립된 다섯이 아니라 하나입니다.
  3. 반대 증거 찾기 — "맞다"는 근거만 찾으면 언제나 찾아집니다. 그래서 일부러 "틀렸다면 어떤 자료가 있어야 하는가"를 먼저 정하고 그것을 찾습니다.
  4. 직접 계산·직접 확인 — 숫자는 다시 계산하고, 인용은 원문에서 찾고, 코드는 실제로 돌립니다. 2단원 내내 우리가 해 온 방식이 그대로 검증 절차가 됩니다.

그런데 이 네 가지를 모든 결과물에 다 하면 인공지능을 쓰지 않는 것과 걸리는 시간이 같아집니다. 그래서 두 번째 물음이 필요합니다 — 무엇을 검증할 것인가.

기준은 정확도가 아닙니다. 틀렸을 때 누가 다치는가입니다. 같은 확신도 85%라도, 친구에게 보낼 축하 문구를 다듬은 결과와 약의 용량을 알려 준 결과는 전혀 다른 물건입니다. 앞의 것은 틀려도 되돌릴 수 있고, 뒤의 것은 되돌릴 수 없습니다.

묻는 것'초안으로 쓰기'에 가까운 쪽'반드시 검증'에 가까운 쪽
틀렸을 때 되돌릴 수 있나고쳐 쓰면 그만이다되돌릴 수 없다
누가 영향을 받나나 혼자다른 사람 · 여러 사람
내가 틀린 줄 알아챌 수 있나읽으면 바로 안다전문 지식이 있어야 안다
기록으로 남나남지 않는다제출·게시·서명으로 남는다
확인에 드는 시간확인이 결과물보다 오래 걸린다몇 분이면 된다
다섯 물음 중 오른쪽 칸이 많을수록 '반드시 검증' 쪽입니다. 마지막 줄만 방향이 반대인 것에 주의하세요 — 확인이 쉬울수록 안 할 핑계가 없어집니다. 여는 장면의 판례 확인이 바로 그 자리였습니다.

이 두 물음—어떻게 검증할 것인가, 무엇을 검증할 것인가—을 하나의 장치로 묶은 것이 오늘 실습에서 다룰 확인 문턱입니다. 규칙은 한 줄입니다: "확신도가 T% 미만인 결과는 사람이 확인한다." T를 낮추면 사람은 편하고 오류는 그대로 나갑니다. T를 높이면 오류는 줄고 사람이 갈립니다. 이 저울을 실제 숫자로 재 보는 것이 오늘 15분의 일입니다.

💻

손으로 ① — 보정 곡선 판, 사람의 시간과 남는 위험을 맞바꾼다

앞 절의 480건이 이 판 안에 그대로 들어 있습니다. 왼쪽 그림은 보정 곡선입니다 — 확신도 구간마다 점이 하나씩 찍히고, 점선 대각선이 '눈금이 맞는 모델'입니다. 점이 대각선 아래로 내려간 만큼이 과신입니다. 아래 그림은 문턱 곡선입니다 — 문턱을 왼쪽에서 오른쪽으로 옮기면 사람이 볼 건수가 올라가고 남는 오류가 내려갑니다. 두 곡선이 만나는 자리는 없습니다. 둘은 언제나 반대로 움직입니다.

📉 보정 곡선 판 — 확신도의 눈금과 사람의 시간 INTERACTIVE

확인 문턱을 밀면 사람이 볼 건수와 남는 오류가 함께 움직입니다. 과신의 세기를 밀면 데이터를 만든 가정 자체가 바뀌어 보정 곡선이 다시 그려집니다 (0.65가 본문 표를 만든 값입니다). 건수를 줄이면 표가 얼마나 흔들리는지 보입니다. 여기 나오는 값은 전부 이 자리에서 480건을 다시 세어 계산한 것이고, 기본 설정에서는 아래 파이썬 실습의 출력과 한 건도 다르지 않습니다.

보정 곡선의 점 (크기 = 건수) 완벽한 보정선(대각선) 사람이 볼 건수 남는 오류
90 %
사람이 볼 건수342 확신도 90 % 미만
└ 잡은 오류125 확인해서 걸러 낸 것
└ 헛걸음217 봤는데 멀쩡했던 것
자동 통과138 사람이 안 본 것
남는 오류31 통과분 오류율 22.5 %
드는 시간17시간 06분 한 건 3분 가정
0.65
전체 정답률67.5 % 324 / 480
평균 확신도78.5 % 모델이 말한 값
평균 과신+11.0 %p 확신도 − 정답률
평균 보정 오차11.4 %p 최대 이탈 90~100 %
90 % 이상 정답률77.5 % 90이 아니다
90 % 이상 오답31 건 가장 센 것 98 %
번호유형물음 표제확신도결과
[안내] 문턱 90 %. 사람이 342건을 보고, 자동 통과한 138건 안에 오류 31건이 남습니다.
🎯 시뮬레이터로 할 일 셋 — 공책에 적으세요

① 표 채우기. 문턱을 60·70·80·90·95·100으로 옮기며 (사람이 볼 건수, 남는 오류, 드는 시간) 세 값을 아래 표에 적으세요. 시간은 한 건 3분으로 두고 잽니다.

② 문턱 찾기. 남는 오류가 처음으로 0이 되는 문턱을 1씩 올려 가며 찾으세요. 100이 아닙니다. 그 문턱에서 사람은 몇 건을 보나요? 480건을 전부 보는 것과 견주면 아낀 시간은 몇 분인가요? 그만큼을 아끼려고 문턱을 100 대신 거기에 두는 것이 뜻이 있는지도 한 줄로 적으세요.

③ 반례 만들기. 과신의 세기를 1.00까지 밀어 "눈금이 맞는 모델"을 만들어 보세요. 평균 보정 오차가 0이 되나요? 되지 않는다면, 남은 오차는 어디서 온 것일까요? (힌트: 유형 보정 끄기를 눌러 보세요.)

문턱 T사람이 볼 건수남는 오류 드는 시간(3분/건)이 문턱을 우리 반이 감당할 수 있나 (O/X)
60 %
70 %
80 %
90 %
95 %
100 %
이 표는 잠시 뒤 확인 문제 2번에서 그대로 쓰입니다. (숫자 칸의 '헛걸음' 값은 5번에서 쓰이니 T=95 자리에서 함께 적어 두세요.) 마지막 열은 계산이 아니라 여러분의 판단입니다 — 그리고 판단을 적을 때는 누가 그 시간을 쓰는지를 함께 적으세요.
⚠️ ③번에서 무엇을 보게 되나

기울기를 1.00으로 밀면 "확신도가 1%p 오르면 실제 정답률도 1%p 오른다"는 모델이 됩니다. 눈금이 맞아야 할 것 같지요. 그런데 평균 보정 오차는 0이 아니라 4.1 %p가 남습니다. 여기에 유형 보정 끄기까지 누르면 2.2 %p까지 내려갑니다. 과신의 뿌리가 하나가 아니었던 것입니다 — 기울기 말고도 유형별 난이도가 남아 있었고, 그러고도 남은 몫은 건수가 480건뿐이라서 생기는 흔들림입니다. 건수를 60건으로 줄여 보면 50~60% 칸의 격차가 +53.0 %p까지 튑니다. 표는 건수가 적을수록 거짓말을 잘합니다. 이 사실이 곧 뒤에 나올 '우리 반 12건'에 그대로 걸립니다.

💻

손으로 ② — 보정표와 문턱표를 직접 계산한다

시뮬레이터가 대신 세어 준 것을 이번에는 우리가 셉니다. 아래 프로그램은 앞에서 본 480건을 같은 규칙으로 다시 만들고, 보정표 · 문턱표 · 네 칸을 차례로 찍습니다. 빈칸 다섯 곳(?????)이 비어 있으니 채운 뒤 실행하세요.

💡 빈칸 ②와 ④는 틀려도 오류가 나지 않습니다

빈칸 ①·③·⑤를 잘못 채우면 대개 오류가 나거나 표가 눈에 띄게 이상해집니다. 그런데 ②(과신의 뺄셈 순서)와 ④(남는 오류를 세는 조건)은 틀려도 프로그램이 멀쩡히 돌아갑니다. 부호만 통째로 뒤집혀 과신하는 모델이 '겸손한 모델'로 읽히거나, 남는 오류가 156건 대신 324건으로 찍힙니다. 오류를 내지 않는 오답이 가장 위험합니다. 실행한 뒤에는 반드시 값이 본문 표와 같은지 대조하세요.

⚠️ 화면이 좁으면 출력 상자를 옆으로 밀어 보세요

이 프로그램의 표는 가장 넓은 줄이 100칸입니다. 휴대전화 화면은 40칸 남짓이라 그대로는 다 안 보입니다. 출력 상자 안에서 좌우로 밀면 표가 어긋나지 않은 채로 이어집니다. (줄바꿈으로 접으면 열이 밀려 표를 읽을 수 없게 됩니다.)

5

표가 말한 것 — 마지막 오류가 가장 비싸다

문턱표를 다시 봅시다. 문턱을 5%p씩 올릴 때마다 사람이 더 봐야 하는 건수와 그래서 더 막은 오류를 나눠 보면, 오류 한 건을 더 막는 데 드는 값이 나옵니다.

문턱 이동확인 건수 증가추가로 막은 오류오류 1건당 확인 건수
50 % → 55 %+34+17 2.0 건
60 % → 65 %+47+212.2 건
70 % → 75 %+46+202.3 건
80 % → 85 %+51+153.4 건
90 % → 95 %+68+183.8 건
95 % → 100 %+70+13 5.4 건
우리가 만든 480건에서 계산한 값입니다(전체 열 개 구간 중 여섯을 뽑았습니다). 앞쪽에서는 두 건만 보면 오류 하나를 막는데, 맨 끝에서는 다섯 건 넘게 봐야 하나를 막습니다. 마지막 오류가 가장 비쌉니다.

이 표가 왜 중요할까요? 규칙을 쓸 때 사람들은 흔히 "오류를 0으로 만들자"고 적습니다. 그 문장의 값이 여기 적혀 있습니다. 방금 프로그램이 찍은 문턱표를 5 %p 간격으로 훑으면 남는 오류가 0이 되는 줄은 T=100 하나뿐이고, 그때 사람은 480건 전부를 봅니다. 그것은 인공지능을 쓰지 않는 것과 노동량이 같습니다. '오류 0'과 '인공지능으로 아낀 시간'은 동시에 가질 수 없습니다.

⚠️ 그런데 1씩 옮겨 보면 다른 답이 나옵니다

위 시뮬레이터로 돌아가 문턱을 1씩 올려 보세요. 남는 오류는 T=99에서 이미 0이 됩니다. 그때 사람이 보는 것은 480건이 아니라 463건입니다. 프로그램의 문턱표는 5 %p 간격이라 이 자리를 그냥 지나쳤습니다. 눈금을 성기게 잡으면 보이지 않는 답이 생깁니다. 표가 "T=100 하나뿐"이라고 찍었다고 해서 그것이 세상의 전부는 아니었던 것이지요.

왜 T=99에서 0이 될까요? 우리 480건에서 확신도가 99 %인 응답은 17건이었는데, 그 17건이 전부 맞았기 때문입니다. 가장 자신 있게 틀린 응답의 확신도가 98 %였던 것도 같은 이야기입니다. 17건짜리 칸 하나가 우연히 깨끗했을 뿐이고, 씨앗을 바꿔 데이터를 다시 만들면 이 자리는 사라질 수 있습니다. 이것은 모델의 성질이 아니라 표본의 우연입니다.

그래도 결론은 바뀌지 않습니다. 463건은 23시간 09분, 480건은 24시간입니다. 아낀 것은 51분 — 전수 확인의 3.5 %입니다. '오류 0'의 값은 여전히 거의 전수 확인이었습니다.

거꾸로 물으면 — 사람이 쓸 수 있는 시간이 정해져 있다면

현실의 물음은 대개 반대 방향입니다. "오류를 몇 건까지 허용할까"가 아니라 "우리한테 몇 시간이 있나"이지요. 확신도가 낮은 것부터 차례로 본다고 하고, 한 건 확인에 3분이 든다고 가정하면 이렇게 됩니다.

볼 수 있는 건수드는 시간여기까지의 확신도 막은 오류남는 오류전체 오류 중 막은 비율
30 건1시간 30분54 %까지 151419.6 %
60 건3시간 00분60 %까지 2712917.3 %
120 건6시간 00분67 %까지 5010632.1 %
240 건12시간 00분80 %까지 956160.9 %
360 건18시간 00분91 %까지 1312584.0 %
480 건24시간 00분99 %까지 1560100.0 %
한 건 3분은 우리가 정한 가정입니다. 실습 시간에 직접 재 보세요 — 출처를 되짚어 확인하는 데 실제로 몇 분이 걸리는지. 1분이면 전수 확인이 8시간, 10분이면 80시간이 됩니다. 가정 하나가 열 배를 만듭니다.

여기서 오늘의 가장 중요한 문장이 나옵니다. 문턱은 모델이 얼마나 정확한지가 아니라, 사람이 몇 명 있는지가 정합니다. 2단원 12차시에서 기준점을 옮기며 정밀도와 재현율을 저울질했던 그 표가, 여기서는 사람의 노동 시간으로 되돌아옵니다.

2단원 12차시의 네 칸으로 다시 읽으면

여기서 '양성'은 "사람이 봐야 한다"는 판정이고, '실제 양성'은 실제로 틀린 응답입니다. 이름만 바꾸면 그때 그 표 그대로입니다.

문턱TP 잡은 오류FP 헛걸음 FN 놓친 오류TN 잘 통과정밀도재현율
60 %2632130 29244.8 %16.7 %
70 %577499 25043.5 %36.5 %
80 %9413862 18640.5 %60.3 %
90 %12521731 10736.5 %80.1 %
95 %14326713 5734.9 %91.7 %
정밀도는 사람이 본 것 중 실제로 문제가 있던 비율이고, 재현율은 전체 오류 중 사람 손에 걸린 비율입니다. 12차시와 똑같이 둘은 반대로 움직입니다 — 거기서 '억울한 재검사'였던 FP가 여기서는 검토자의 헛걸음입니다.
ℹ️ 12차시 함수를 그대로 쓴 것이 아닙니다

위 네 칸은 12차시에서 만든 confusion()을 불러다 쓴 것이 아니라 이 차시 프로그램 안에서 새로 센 것입니다. 계산은 같지만 코드는 다릅니다. 이어지는 것은 함수가 아니라 '네 칸'이라는 틀입니다. 같은 틀이 문제를 바꿔 가며 다시 쓰이는 것 — 이것이 지표를 배우는 이유입니다.

사람도 틀린다면 — 낙관적인 가정을 풀어 본다

지금까지의 계산에는 숨은 가정이 하나 있었습니다. "사람이 본 것은 다 잡는다." 그래서 T=100에서 남는 오류가 0으로 떨어졌지요. 그런데 3단원 2차시에서 우리는 사람도 틀린다는 것을 이미 보았습니다. 거기서 다시 판독한 사람의 민감도를 98%로 두었더니, 끝내 놓친 사람이 6.9명 남았습니다.

같은 가정을 오늘 480건에 그대로 대 보면 이렇게 됩니다.

문턱사람이 다 잡는다고 두면사람의 민감도를 98%로 두면
T = 90 %남는 오류 31 건33.5 건
T = 95 %남는 오류 13 건15.9 건
T = 100 %남는 오류 0 건3.1 건
가정을 하나 바꾸었을 뿐인데 마지막 줄의 0이 3.1로 바뀝니다. '사람을 붙이면 오류가 사라진다'는 문장은 사람이 완벽하다는 가정 위에서만 참입니다.

그렇다면 인공지능을 쓰지 말아야 할까요? 그 결론도 이 표에서는 나오지 않습니다. 사람만 480건을 보아도 3.1건은 남기 때문입니다. 비교해야 할 것은 '인공지능 대 완벽함'이 아니라 '인공지능을 쓰는 절차 대 안 쓰는 절차'이고, 두 절차 모두 오류가 0이 아닙니다. 그래서 물음이 다시 바뀝니다 — 어느 쪽이 더 적게 틀리고, 틀렸을 때 누가 책임지는가. 이 물음이 8차시 토론의 자리입니다.

ℹ️ 문턱은 인공지능을 '계속 쓰기 위한' 장치입니다

오늘 다룬 장치를 "인공지능을 못 믿으니 사람이 막는다"로 읽으면 절반만 읽은 것입니다. 문턱이 하는 일은 확인해야 할 것을 골라 주는 것입니다. 문턱이 없으면 선택지는 둘뿐입니다 — 전부 확인하거나(=안 쓰는 것과 같다), 전혀 확인하지 않거나. 문턱은 그 사이에 눈금을 만들어, 남는 위험을 우리가 고른 크기로 정할 수 있게 합니다. 예컨대 문턱 70%에서 사람은 131건만 보고도 오류의 36.5%를 걸러 냅니다. 전수 확인의 27%에 해당하는 시간입니다. 인공지능의 쓸모는 이 자리에서 살아납니다.

💻

손으로 ③ — 우리 반이 직접 세는 12건

지금까지의 숫자는 전부 우리가 가정을 넣어 만든 것이었습니다. 가정을 바꾸면 바뀌는 숫자였지요. 이제 성격이 완전히 다른 숫자를 하나 만듭니다 — 손으로 확인해서 나온 숫자입니다. 이 숫자는 가정을 바꿔도 바뀌지 않습니다. 세상을 바꾸어야 바뀝니다.

선생님이 미리 뽑아 둔 생성형 인공지능 응답 12건을 모둠이 나눠 맡습니다. 네 유형(고유명사 · 숫자와 통계 · 최신 사실 · 상식 추론)에서 3건씩입니다. 15분 동안 각 응답이 주장하는 사실을 원출처까지 되짚어 판정합니다.

판정 세 가지

○ 확인됨 — 원출처에서 같은 내용을 찾았다.
× 틀림 — 원출처에 다른 값·다른 사실이 있거나, 인용한 자료 자체가 없었다.
△ 확인 불가 — 맞는지 틀리는지 정해진 시간 안에 알아낼 수 없었다.

반드시 함께 적는 것

판정만 적으면 그 판정을 나중에 아무도 검증할 수 없습니다. 근거가 된 자료의 이름 · 만든 기관 · 주소를 함께 적으세요. △로 판정했다면 어디까지 찾아봤는지를 적습니다. 이 기록이 있어야 다른 모둠이 여러분의 판정을 다시 볼 수 있습니다.

유형맡은 건수○ 확인됨× 틀림△ 확인 불가 × 만 셀 때 오류율△ 를 × 로 셀 때 오류율
고유명사3
숫자·통계3
최신 사실3
상식 추론3
합계12
마지막 두 열에 같은 데이터에서 나온 서로 다른 오류율 두 개가 적히게 됩니다. 그 차이가 곧 △를 어떻게 세느냐가 만드는 폭입니다. 보고할 때는 두 값을 함께 적으세요.
⚠️ 12건으로 유형 순위를 말하지 마세요

방금 시뮬레이터에서 본 그대로입니다. 건수를 480건에서 60건으로 줄였더니 50~60% 칸의 격차가 −1.6 %p에서 +53.0 %p로 튀었습니다. 건수가 적으면 표는 우연히 만들어진 모양을 보여 줍니다.

우리가 만든 480건에서도 같은 일이 있었습니다. 데이터를 만들 때 우리는 고유명사를 숫자·통계보다 더 위험하게 설정했는데 (가정 오류율 41.2 % 대 37.9 %), 실제로 나온 값은 35.8 % 대 37.5 %로 순서가 뒤집혔습니다. 120건씩이나 되는데도 몇 %p 차이는 가려집니다.

그러니 12건으로 말할 수 있는 것은 여기까지입니다 — "우리가 확인한 12건 중 몇 건이 틀렸고, 이런 자리에서 틀리더라." "고유명사가 최신 사실보다 위험하다"는 문장은 12건으로 세울 수 없습니다. 여러 반의 표를 합치면 어디까지 말할 수 있게 되는지도 생각해 보세요.

💡 인터넷을 쓸 수 없다면

생성형 인공지능에 직접 접근할 수 없어도 이 활동은 그대로 됩니다 — 응답 12건은 선생님이 인쇄물로 나눠 줄 수 있으니까요. 다만 검증에 쓸 자료 접근은 반드시 있어야 합니다. 원출처를 열 수 없으면 모든 판정이 △가 되고, 그러면 오늘 활동은 성립하지 않습니다. 확인할 수 없는 환경에서 인공지능을 쓰는 것이 왜 위험한지가 이 자리에서 바로 드러납니다.

📖

정리

오늘 배운 것한 줄 정의오늘 데이터에서 본 장면
환각근거 없이 그럴듯한 말을 만들어 내는 것 존재하지 않는 판례 여섯 건이 형식을 다 갖추고 있었다
확신도모델이 자기 답에 스스로 매긴 점수 평균 78.5 %라고 말하고 실제로는 67.5 % 맞혔다
보정확신도와 실제 정답률이 맞는 상태 = 대각선 평균 보정 오차 11.4 %p, 가장 어긋난 칸은 90~100 %
과신말한 확신도가 실제 정답률보다 높은 것 90~100 % 칸에서 +17.0 %p (94.5 % 말하고 77.5 % 맞힘)
확신도의 쓸모한 건의 보증이 아니라 줄을 세우는 신호 정답률이 55.2 % → 77.5 %로 분명히 올랐다
자동화 편향기계의 답을 덜 확인하게 되는 성향 T=95 에서 사람이 본 410건 중 267건이 헛걸음이었다
확인 문턱확신도 T % 미만은 사람이 본다 남는 오류가 0이 되는 자리는 T=99(463건) — 사실상 전수 확인
마지막 오류의 값오류 한 건을 더 막는 데 드는 확인 건수 앞쪽 2.0건 → 맨 끝 5.4건
검증 절차출처 되짚기 · 교차 확인 · 반대 증거 · 직접 계산 여는 장면은 첫 단계에서 멈춘 사례였다
표본 크기건수가 적으면 표가 흔들린다 480건 → 60건에서 한 칸이 −1.6 → +53.0 %p로 튀었다

오늘의 한 문장. 인공지능을 믿을지 말지는 오늘의 물음이 아니었습니다. 물음은 어디에 사람을 세울 것인가였고, 그 자리를 정하는 것은 모델의 정확도가 아니라 우리가 쓸 수 있는 시간과 틀렸을 때 치를 대가였습니다. 계산은 저울을 보여 줄 뿐, 어디에 멈출지는 정해 주지 않습니다.

📖 다음 시간에는

오늘 우리는 오류를 한 덩어리로 세었습니다. 156건이 틀렸다, 31건이 남는다 하는 식으로요. 그런데 그 오류가 누구에게 몰려 있는지는 한 번도 묻지 않았습니다. 7차시에서는 정확도가 두 집단에서 소수점까지 똑같은데도 한쪽만 억울하게 탈락하는 경우를 만나게 됩니다. 그리고 8차시에서는 오늘의 문턱 표를 들고 우리 반 규약을 씁니다 — "확신도 몇 %부터 사람이 확인할 것인가", "그 시간은 누가 쓸 것인가"를 인상이 아니라 숫자로 다투기 위해서입니다. 오늘 채운 표를 잃어버리지 마세요.

✅

확인 문제

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. 생성형 언어 모델에 환각이 생기는 까닭을 "모델이 무엇을 고르는가"로 설명하시오. 그리고 그 설명으로부터 왜 고유명사·숫자·출처에서 특히 잘 틀리는지를 이어서 밝히시오.
📖 모범 답안

모델이 고르는 것은 "다음에 올 말로 가장 그럴듯한 것"이지 "가장 맞는 것"이 아닙니다. 그리고 후보 중에는 언제나 무엇인가가 가장 그럴듯하므로, 근거가 없는 자리에서도 '모른다'가 아니라 어떤 말이 선택됩니다. 아는 것과 모르는 것을 갈라 주는 장치가 안에 없는 것입니다.

고유명사·숫자·출처는 그럴듯함과 맞음이 가장 크게 벌어지는 자리입니다. "○○ 연구소의 김□□ 소장"은 형태만 갖추면 문장에서 전혀 어색하지 않고, 3.2 %와 3.7 %는 어느 쪽이 와도 자연스럽습니다. 판례 번호나 논문 제목처럼 형식이 뚜렷한 것일수록 흉내 내기가 오히려 쉽습니다. 그래서 환각은 고장이 아니라 이 작동 방식의 결과입니다.

2. 오늘 시뮬레이터에서 직접 찾은 값으로 답하시오. 기본 설정(480건 · 기울기 0.65)에서 문턱을 60 % · 90 % · 100 %로 두었을 때 (사람이 볼 건수, 남는 오류)를 각각 쓰고, 문턱을 1씩 올려 가며 남는 오류가 처음으로 0이 되는 문턱과 그때 사람이 보는 건수도 찾아 쓰시오. 그 결과가 뜻하는 바를 한 문장으로 정리하시오.
📖 모범 답안

T=60 % → (58건, 130건) · T=90 % → (342건, 31건) · T=100 % → (480건, 0건).

1씩 올려 가며 찾으면 남는 오류가 처음 0이 되는 자리는 T=99 %이고, 그때 사람이 보는 것은 463건(23시간 09분)입니다. 5 %p 간격 표에서는 T=100만 보이지만, 1씩 옮기면 그보다 한 칸 앞에서 이미 0이 됩니다 — 확신도 99 %인 17건이 우연히 전부 맞았기 때문입니다. (틀린 응답 중 가장 확신이 셌던 것이 98 %였다는 사실과 같은 이야기입니다.)

뜻: '오류 0'과 '인공지능으로 아낀 시간'은 동시에 가질 수 없습니다. T=99에서 아낀 시간은 24시간 중 51분뿐이니, T=99든 T=100이든 사실상 전부를 사람이 보는 것입니다. 문턱을 낮추면 그만큼 오류가 그대로 나갑니다. 그래서 문턱을 정하는 일은 계산이 아니라 얼마만큼의 위험을 받아들일지 정하는 결정입니다.

3. 오늘 시뮬레이터에서 직접 만든 반례로 답하시오. 과신의 세기(기울기)를 1.00까지 밀면 "확신도가 1 %p 오르면 정답률도 1 %p 오르는 모델"이 됩니다. 그런데도 평균 보정 오차가 0이 되지 않았습니다. 얼마가 남았고, 그 까닭은 무엇인가? 유형 보정을 끄면 얼마까지 내려가는지도 쓰고, 그래도 남는 몫은 무엇 때문인지 설명하시오.
📖 모범 답안

기울기 1.00에서도 평균 보정 오차는 4.1 %p가 남습니다. 데이터를 만들 때 기울기 말고 유형별 보정을 함께 넣었기 때문입니다 (고유명사 −0.10 · 숫자·통계 −0.06 · 최신 사실 −0.13 · 상식 추론 +0.12). 네 유형을 평균하면 아래로 치우쳐 있어서, 기울기를 바로잡아도 그만큼이 남습니다.

유형 보정 끄기까지 누르면 2.2 %p까지 내려가지만 여전히 0은 아닙니다. 남은 몫은 480건이라는 표본이 만들어 내는 흔들림입니다. 건수를 60건으로 줄여 보면 50~60 % 칸의 격차가 +53.0 %p까지 튀는 것에서 같은 성질을 볼 수 있습니다.

정리하면 과신의 원인이 하나가 아니었습니다 — 기울기(모델의 성질) · 유형별 난이도(문제의 성질) · 표본 크기(재는 방식의 한계)가 겹쳐 있습니다. 하나만 고쳐서 0으로 만들 수 없다는 것이 이 반례의 뜻입니다.

4. 아래 다섯 가지 인공지능 결과물을 '반드시 검증'과 '초안으로 활용'으로 가르고, 여러분이 쓴 기준을 한 줄로 밝히시오.
① 동아리 모집 포스터의 문구 다듬기  ② 수행평가 보고서에 넣을 통계 수치  ③ 친구 생일 축하 메시지 초안  ④ 학교 누리집에 올릴 안내문의 법령 인용  ⑤ 파이썬 코드의 오류 원인 설명
📖 모범 답안

반드시 검증 — ② 통계 수치(숫자는 잘 틀리고, 보고서에 기록으로 남으며, 읽는 사람이 틀린 줄 알기 어렵다) · ④ 법령 인용(조문 번호는 형식이 뚜렷해 흉내 내기 쉽고, 게시되면 여러 사람이 영향을 받으며, 되돌리기 어렵다).

초안으로 활용 — ① 포스터 문구(틀렸다는 개념이 없고 고치면 그만) · ③ 축하 메시지(나 혼자 읽고 고친다). ⑤ 코드 오류 설명은 가운데입니다 — 다만 돌려 보면 즉시 판정되므로 검증 비용이 거의 0입니다. 확인이 이렇게 쉬우면 안 할 까닭이 없습니다.

기준의 예: "틀렸을 때 되돌릴 수 있고 나만 영향을 받으면 초안, 되돌릴 수 없거나 다른 사람이 영향을 받으면 반드시 검증한다." 기준이 정확도가 아니라 '누가 다치는가'라는 점이 답의 핵심입니다. 가른 결과가 조금 달라도, 기준을 한 줄로 댈 수 있으면 됩니다.

5. 자동화 편향이 "도구의 정확도가 높을수록 오히려 더 위험해진다"고 하는 까닭을 설명하시오. 그리고 "확신도 90 % 이상은 확인을 생략한다"는 규칙에 대해 오늘 데이터에서 반례를 찾아 제시하고, 그 규칙을 어떻게 고쳐 쓸지 한 문장으로 쓰시오.
📖 모범 답안

까닭. 확인에는 시간과 주의라는 대가가 듭니다. 도구가 정확할수록 확인해도 대부분 아무것도 나오지 않습니다. 우리 표에서 T=95 %일 때 사람이 본 410건 중 267건이 헛걸음이었지요. 헛걸음이 이어지면 확인은 형식이 되고, 형식이 된 확인은 사실상 확인이 아닙니다. 그리고 바로 그 상태에서 드물게 오는 오류가 지나갑니다. 게다가 드물수록 그 한 건이 걸러지지 않았을 때의 대가는 큽니다.

반례. 우리 480건에서 확신도 90 % 이상인데 틀린 응답이 31건 있었고, 그중에는 확신도 98 %짜리도 있었습니다. 90 % 이상 구간의 실제 정답률은 90 %가 아니라 77.5 %였습니다. "90 % 이상은 생략"이라는 규칙은 이 31건을 전부 그대로 내보냅니다.

고쳐 쓴 규칙의 예. "확신도와 무관하게, 틀렸을 때 되돌릴 수 없는 항목은 전부 확인한다. 나머지는 확신도가 낮은 것부터 우리가 쓸 수 있는 시간만큼 본다." 확신도를 확인을 생략하는 근거가 아니라 확인 순서를 정하는 근거로 쓰는 것이 핵심입니다.

6. 다음 두 물음에 답하시오.
(1) 손 활동에서 '△ 확인 불가'를 '× 틀림'과 다르게 세어야 하는 까닭은 무엇인가? 그럼에도 △가 많이 나왔다면 그것은 무엇을 뜻하는가?
(2) [O/X] 인공지능이 출처와 저자 이름까지 붙여 답하면 그 내용은 사실로 보아도 된다. 까닭과 함께 답하시오.
📖 모범 답안

(1) △는 인공지능의 성질이 아니라 우리의 확인 능력의 한계를 나타냅니다. ×는 "원출처를 찾았고 내용이 달랐다"이고, △는 "원출처에 닿지 못했다"입니다. 둘을 합쳐 세면 모델의 오류율과 우리의 조사 한계가 뒤섞여 어느 쪽 숫자인지 알 수 없게 됩니다. 그래서 따로 세고, 보고할 때는 ×만 센 값과 △를 ×로 센 값을 함께 적어 범위로 말합니다.

그럼에도 △가 많다면 두 가지 중 하나입니다 — 확인할 수 있는 자료가 세상에 없거나(출처를 댈 수 없는 주장), 우리가 접근할 수 없거나. 어느 쪽이든 실무에서는 나쁜 신호입니다. 확인할 수 없는 주장은 확인된 주장처럼 쓸 수 없습니다. △가 많은 유형은 애초에 인공지능에게 맡기기에 알맞지 않은 자리라는 뜻이기도 합니다.

(2) X. 출처와 저자 이름은 형식이 뚜렷해서 오히려 흉내 내기 쉬운 자리입니다. 여는 장면의 판례 여섯 건은 사건 번호와 인용 형식을 다 갖추고 있었지만 전부 존재하지 않았습니다. 출처가 붙어 있다는 것은 "확인할 수 있게 되었다"는 뜻이지 "확인되었다"는 뜻이 아닙니다. 붙은 출처는 검증의 끝이 아니라 시작입니다. 출처를 붙이도록 설계한 상용 법률 도구에서도 환각률이 0이 아니었다는 조사가 있습니다 (17~33 %, Stanford RegLab, 2024 — 1절에서 본 논쟁 중인 추정치입니다).

🔁 되돌아보기

오늘 우리는 확신도의 눈금이 11.4 %p 어긋나 있는 것을 직접 재고, 문턱을 옮기며 사람이 볼 건수와 남는 오류가 반대로 움직이는 것을 확인했습니다. 그리고 손으로 12건을 검증해 가정이 아니라 확인에서 나온 숫자를 하나 만들었습니다. 다음 시간에는 오류가 누구에게 몰려 있는가를 묻고, 8차시에서는 오늘의 문턱 표를 근거로 우리 반 규약을 씁니다.

🔎

더 알아보기

확신도의 눈금을 먼저 재어 온 사람들, 눈금을 고치는 방법, 그리고 '마지막 확인자'라는 일

서류철이 꽂힌 선반 아래 여러 대의 모니터에 기상 레이더 영상을 띄워 놓고 앉아 있는 예보관
역사

확률을 말하고 날마다 채점받는 직업 — 일기예보

오늘 그린 보정 곡선은 인공지능 연구에서 처음 나온 도구가 아닙니다. 이 물음을 가장 먼저 진지하게 다룬 곳은 기상 예보였어요. "내일 비 올 확률 30 %"라는 예보는 하루만 보고는 맞았는지 틀렸는지 가릴 수 없습니다. 비가 와도, 안 와도 30 %는 틀린 말이 아니니까요. 그래서 30 %라고 말한 날들을 모아 실제로 비가 온 날이 얼마였는지를 셉니다 — 오늘 우리가 확신도 구간마다 정답률을 센 것과 똑같은 방법입니다.

1950년 미국 기상학자 글렌 브라이어(Glenn W. Brier)는 확률 예보를 채점하는 점수를 내놓았습니다. 말한 확률과 실제 결과(비가 왔으면 1, 안 왔으면 0)의 차이를 제곱해 평균 내는 방식인데, 지금도 브라이어 점수라는 이름으로 인공지능 모델의 확신도를 평가하는 데 쓰입니다. 구간마다 점을 찍어 대각선과 견주는 그림 역시 기상학에서 먼저 널리 쓰였습니다.

눈여겨볼 것은, 기상학 연구들이 사람 예보관의 강수 확률 예보가 대각선에 꽤 가깝다고 보고해 왔다는 점입니다(Murphy & Winkler, 1977). 비결은 타고난 감각이 아니라 되먹임입니다. 예보관은 날마다 확률을 말하고, 곧바로 결과로 채점을 받습니다. 눈금은 저절로 맞지 않고 재고 고치는 절차가 있어야 맞는다 — 오늘 차시의 결론과 같은 이야기입니다.

사진: 미국 국립기상청(NWS) 플래그스태프 예보실의 예보관 · 출처: Bill Morrow, Wikimedia Commons (CC BY 2.0)
점수 그대로 (T = 1) 점수를 2로 나눔 (T = 2) 84 % 11 % 4 % 63 % 23 % 14 % 고양이 개 여우 고양이 개 여우 1등은 그대로 고양이 — 정확도는 그대로, 확신도만 내려온다
원리 더 깊이

눈금을 고치는 가장 단순한 방법 — 온도 스케일링

2017년 궈(Chuan Guo) 등의 연구진은 논문 「현대 신경망의 보정에 관하여」(On Calibration of Modern Neural Networks)에서, 층이 깊고 넓은 최신 신경망이 예전 신경망보다 정확도는 높지만 더 과신한다고 보고했습니다. 정확도가 오른 것보다 확신도가 더 크게 올라, 오늘 우리 표처럼 점들이 대각선 아래로 처진 것이지요.

연구진이 권한 처방은 놀랍도록 단순합니다. 모델이 확신도를 만들기 직전의 점수(로짓)를 숫자 하나 T로 나누는 것입니다. T가 1보다 크면 점수 사이의 간격이 좁아져 1등의 확신도가 내려오고 나머지가 조금씩 올라갑니다. 그림은 세 후보의 점수 3, 1, 0을 2로 나눈 경우로, 84 %였던 '고양이'가 63 %로 내려옵니다. T는 학습에 쓰지 않은 검증 데이터에서 보정 오차가 가장 작아지는 값으로 고릅니다.

이 방법은 순위를 바꾸지 않습니다. 모든 점수를 같은 수로 나누면 가장 큰 점수는 여전히 가장 크니까요. 그래서 정확도는 한 건도 바뀌지 않고 눈금만 바뀝니다 — 본문의 말로 하면 "신호는 그대로 두고 눈금만 고친다"입니다. 다만 검증 데이터와 성격이 다른 입력이 들어오면 맞춰 둔 눈금이 다시 어긋날 수 있고, 생성형 언어 모델처럼 문장 전체가 맞는지를 숫자 하나로 보정하는 일은 훨씬 어렵습니다. 그래서 사람이 서는 자리는 여전히 필요합니다.

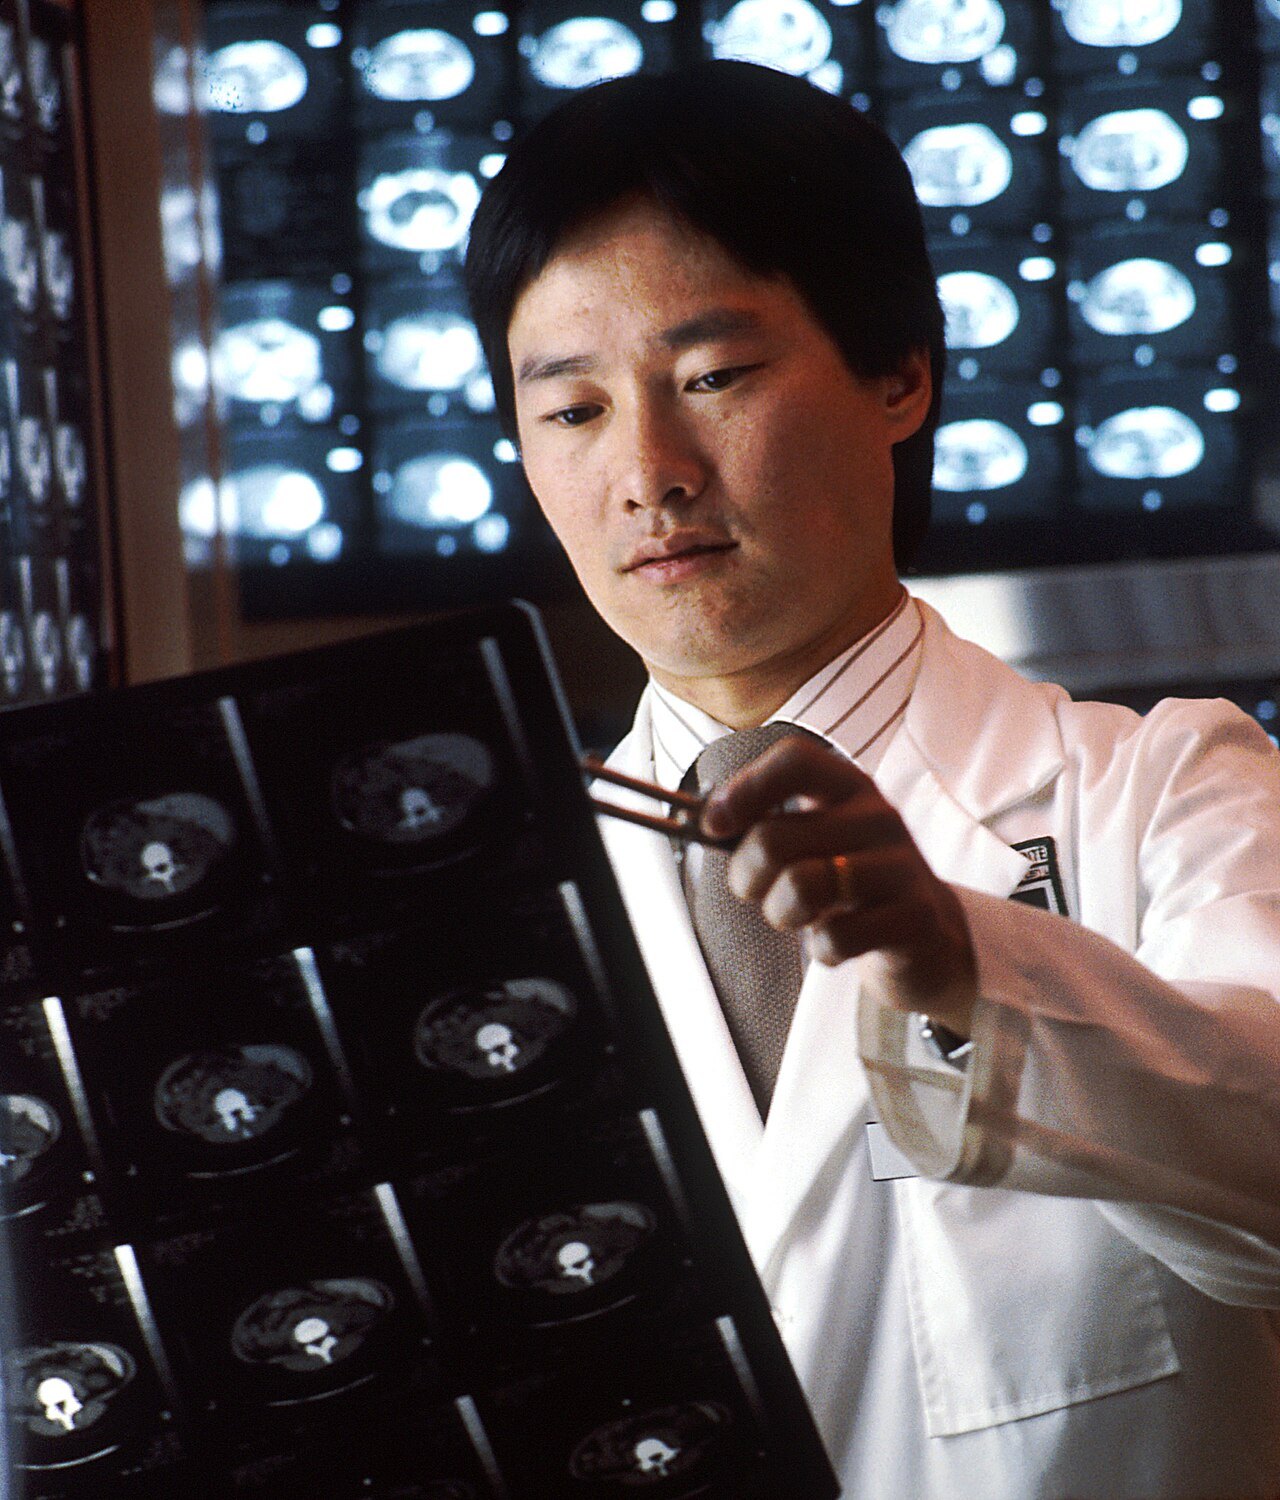
흰 가운을 입은 의사가 CT 단면이 여러 장 인쇄된 필름을 들고 살펴보고, 뒤쪽 조명판에도 CT 필름이 걸려 있는 모습
진로

마지막 확인자라는 일 — 확인을 하는 사람, 확인을 설계하는 사람

사진은 CT 단면이 인쇄된 필름을 들고 살펴보는 영상의학과 의사입니다. 지금은 필름 대신 모니터로 읽고, 곳곳에서 인공지능이 의심 부위를 먼저 표시해 주는 도구도 쓰이지만, 판독 결과에 이름을 걸고 책임지는 것은 여전히 의사입니다. 오늘 배운 자동화 편향이 가장 현실적인 문제가 되는 자리이기도 하지요.

인공지능이 널리 쓰일수록 이런 '마지막 확인자'의 일은 여러 분야로 번집니다. 기사와 공문서의 사실을 원출처까지 되짚는 팩트체커와 편집자, 판례와 조문을 확인하는 법률 전문가, 모델이 틀리는 자리를 일부러 찾아내는 인공지능 평가자와 레드팀이 그렇습니다. 공통점은 오늘의 네 단계 — 출처 되짚기 · 교차 확인 · 반대 증거 찾기 · 직접 확인 — 를 몸에 익혀 두었다는 것입니다.

한 걸음 더 나아가면, 확인을 하는 사람만큼 확인을 설계하는 사람이 중요합니다. 문턱을 어디에 둘지, 한 사람이 하루에 몇 건을 볼지, 헛걸음이 이어질 때 주의를 어떻게 지킬지를 정하는 일이지요. 인간-컴퓨터 상호작용(HCI) · 인간공학 · 품질 관리 같은 분야가 이 물음을 다룹니다. 오늘 계산한 문턱표는 그 일의 가장 작은 견본입니다.

사진: CT 필름을 살펴보는 영상의학과 의사 · 출처: Bill Branson (photographer), Wikimedia Commons (Public domain)