단원 홈
3단원 · 2차시

95% 맞히는 AI를 마을에 놓았더니
규모가 만드는 오류

12차시에서 우리는 예측 결과를 네 칸으로 갈랐습니다. 그때 그것은 비율이었지요. 오늘 그 네 칸에 사람 수를 넣습니다. 같은 정확도라도 1,000명 앞에 놓느냐 5,000만 명 앞에 놓느냐에 따라 전혀 다른 일이 벌어집니다.

성취기준 12인기03-01
규모기저율(유병률) 양성예측도오경보 선별과 확진다섯 축
🎯 학습 목표
  • 같은 정확도의 판정기라도 인구 규모가 커지면 틀린 사람 수가 함께 커진다는 것을 직접 계산해 표로 보일 수 있다.
  • 성능이 그대로여도 기저율(유병률)이 낮으면 양성예측도가 무너지는 것을 내가 만든 숫자로 설명할 수 있다.
  • 사회문제에 인공지능을 대기 전에 다섯 축으로 따져 보고, 어디에 배치할 것인지가 얼마나 정확한지만큼 결정적임을 사례로 말할 수 있다.
🤔

여는 장면 — 양성이라고 뜬 100명 중 진짜는 몇 명일까

1차시에서 우리는 하루 동안 나에게 닿는 인공지능의 접점을 하나씩 세었습니다. 오늘은 그중 하나를 골라 마을 전체에 놓아 봅니다. 한 사람이 쓰는 것과 십만 명에게 한꺼번에 대는 것은 같은 일이 아니거든요.

가정은 이렇습니다. 결핵을 찾아내는 X선 판독 AI가 하나 있습니다. 환자를 환자라고 맞히는 힘(민감도)이 95%, 멀쩡한 사람을 정상이라고 맞히는 힘(특이도)이 90%입니다.

⚠️ 이 두 숫자는 사실이 아니라 가정입니다

② 가정민감도 95% · 특이도 90%는 우리가 이야기를 위해 정한 값입니다. 어떤 실제 제품의 성능도 아닙니다. 오늘 본문에는 두 종류의 숫자가 섞여 나옵니다 — ① 사실은 조사나 발표에 실려 출처를 댈 수 있는 숫자이고, ② 가정은 우리가 정해 놓고 계산한 숫자입니다. 읽을 때마다 어느 쪽인지 확인하세요. 이 둘을 섞으면 계산이 아니라 거짓말이 됩니다.

이 검사를 인구 1만 명인 작은 읍에 한 번 돌렸습니다. 그 읍에 결핵을 앓는 사람이 100명(전체의 1%) 있다고 두겠습니다. 결과가 나왔습니다 — 1,085명이 “양성입니다”라는 통보를 받았습니다.

🎯 오늘의 물음

95% 맞히는 검사가 ‘양성’이라고 부른 100명 중, 실제 환자는 몇 명일까?
종이에 먼저 적어 보세요. 계산은 뒤에서 함께 합니다.

많은 사람이 “95명쯤”이라고 답합니다. 검사가 95% 맞힌다고 했으니까요. 뒤에서 손으로 세어 보면 답은 9명이 채 되지 않습니다. 검사가 거짓말을 한 것도, 우리가 계산을 틀린 것도 아닙니다. ‘95%’가 재는 것과 ‘양성 100명 중 진짜’가 재는 것이 애초에 다른 값일 뿐입니다.

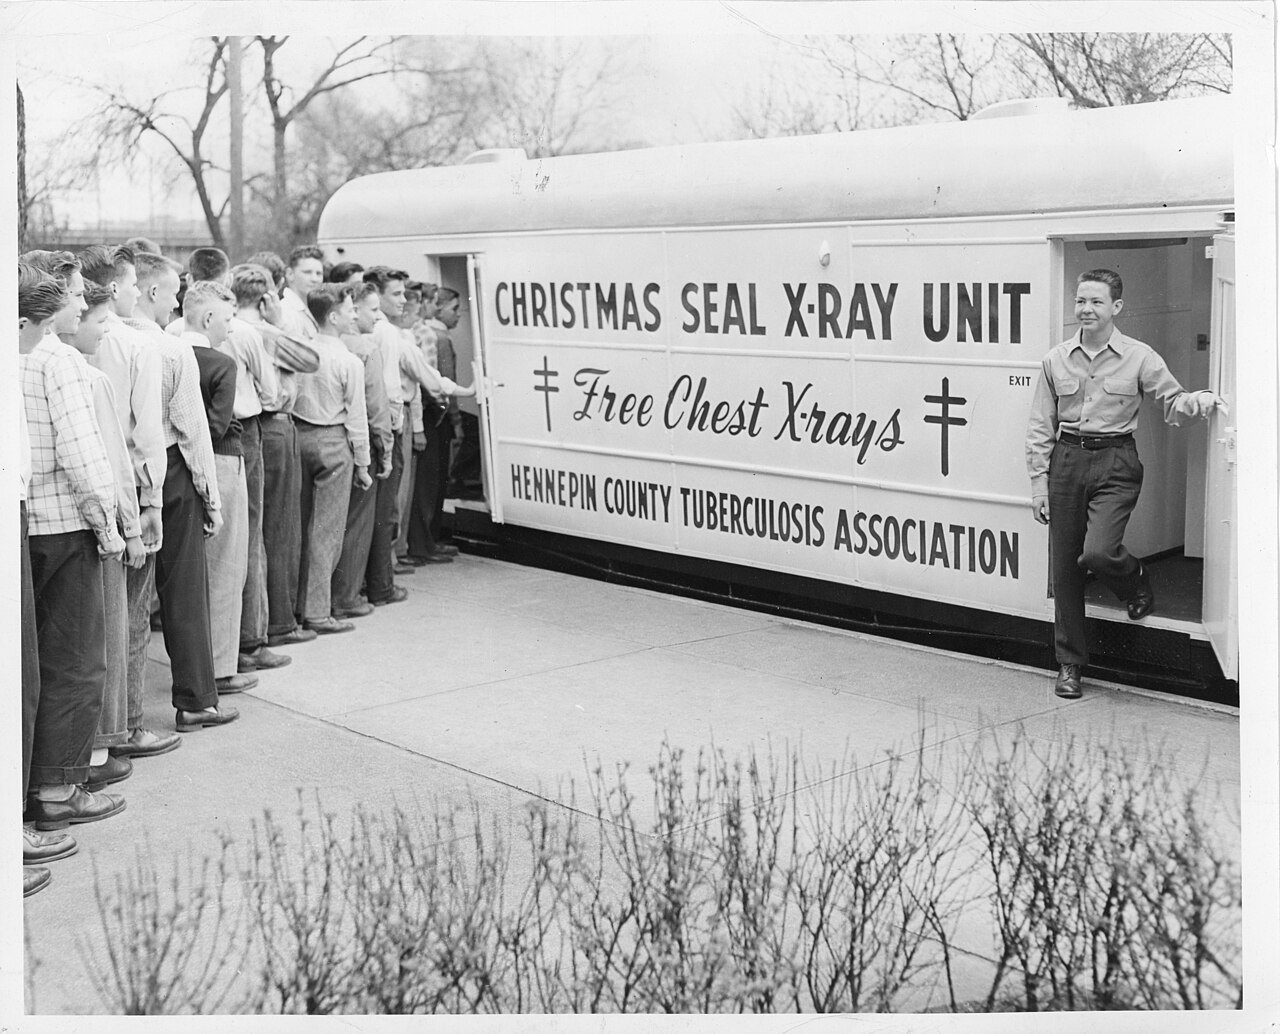
'CHRISTMAS SEAL X-RAY UNIT · Free Chest X-rays · HENNEPIN COUNTY TUBERCULOSIS ASSOCIATION'이라고 적힌 검진 차량 옆에 젊은 남자들이 길게 줄을 서 있고, 촬영을 마친 한 사람이 오른쪽 끝 출구 문으로 내려오는 흑백 사진
20세기 중반 미국 미니애폴리스에서 결핵협회가 돌리던 무료 흉부 X선 검진 차량입니다. 젊은이들이 앞쪽 문으로 차례로 들어가 찍고, 오른쪽 끝 출구로 나옵니다 — 선별검사는 이렇게 한 사람이 아니라 줄 전체를 봅니다. 오늘 배울 두 가지 — 규모와 기저율 — 는 한 사람만 볼 때는 보이지 않다가 이 줄이 길어질 때 비로소 나타납니다. 출처: MPLSArchives, Wikimedia Commons (CC BY 2.0)

오늘 우리는 자를 두 개 만듭니다.

  • 규모 자 — 정확도는 비율입니다. 거기에 인구를 곱하면 실제로 몇 사람이 억울해지는지가 나옵니다. 같은 99.9%가 학교에서는 1명, 나라에서는 5만 명입니다.
  • 기저율 자 — 찾으려는 것이 드물수록 양성 판정의 대부분이 헛것이 됩니다. 검사를 한 글자도 고치지 않았는데 마을만 바꾸면 성적표가 무너집니다.

그리고 마지막에 물음 하나가 남습니다. 그래서 이 AI를 어디에 놓을 것인가. 이 물음에 답하는 것이 오늘 수업의 본체이고, 4단원에서 여러분이 만들 제안서가 서는 자리이기도 합니다.

1

비율에서 사람 수로 — 규모가 만드는 오류

12차시를 떠올려 봅시다. 보건실에 검사 기록 1,000명분이 쌓였고 그중 20명이 실제 환자였습니다. “누가 와도 정상입니다”라고만 답하는 한 줄짜리 프로그램이 정확도 98.0%를 받았지요. 우리는 그 프로그램을 재현율 0.0%로 반박했습니다.

그때 우리가 다룬 것은 전부 비율이었습니다. 98.0%, 0.0%, 70.0%. 비율은 편리합니다. 크기가 다른 것끼리 견줄 수 있으니까요. 그런데 비율에는 지워지는 것이 하나 있습니다. 몇 사람인가.

💡 오늘 새로 붙이는 한 줄

비율 × 사람 수 = 사람 수. 너무 당연해 보이지만, 이 곱셈을 실제로 해 보기 전에는 아무도 규모를 실감하지 못합니다. 오늘 우리가 하는 일은 12차시의 네 칸에 인구를 곱하는 것입니다.

같은 판정기, 다른 마을

정확도가 아주 높은 판정기를 하나 가져왔다고 합시다. 99.9%. 1,000명 중 999명을 맞힙니다. 이 판정기를 크기가 다른 곳에 차례로 놓아 보겠습니다. 계산은 한 줄입니다 — 틀린 사람 수 = 인구 × (1 − 정확도).

어디에 놓나인구90.0%95.0%99.0%99.9%
작은 학교 한 곳1,000 100명50명10명1명
작은 읍10,000 1,000명500명100명10명
중소 도시100,000 10,000명5,000명1,000명100명
광역시 하나5,000,000 500,000명250,000명50,000명5,000명
나라 전체50,000,000 5,000,000명2,500,000명500,000명50,000명
② 가정인구 다섯은 이야기를 위해 잡은 ‘규모 단계’이고, 네 열의 정확도도 우리가 정한 값입니다. 칸 안의 수는 틀린 사람 수입니다.

표의 오른쪽 아래 칸을 보세요. 같은 99.9%짜리 판정기가 학교에서는 1명, 나라에서는 50,000명을 틀립니다. 판정기는 바뀌지 않았습니다. 코드도, 성능도 그대로입니다. 바뀐 것은 줄의 길이뿐입니다.

“99.9%면 충분하지 않나요?”라는 말은 어디에 놓는지를 말하지 않은 문장입니다. 학교에 놓으면 충분할 수 있고, 나라에 놓으면 한 번 돌릴 때마다 5만 명이 잘못된 통보를 받습니다. 성능을 말할 때는 늘 규모를 함께 말해야 합니다.

같은 판정기 · 같은 0.1% — 바뀐 것은 줄의 길이뿐이다 작은 학교 — 1,000명 ↑ 붉은 0.1%가 너무 얇아 안 보인다. 왼쪽 끝 2%만 50배로 늘리면 0.1% 정확도 99.9% → 틀린 사람 1명 담임 선생님이 한 사람씩 확인할 수 있다 나라 전체 — 5,000만 명 ↑ 여기도 똑같이 얇다. 같은 자리를 같은 배율로 늘리면 0.1% 정확도 99.9% → 틀린 사람 50,000명 한 사람씩 확인하려면 사람과 시간이 따로 필요하다 확대한 띠에서 두 붉은 폭은 똑같다. 달라진 것은 막대가 뜻하는 사람 수뿐이다.
② 가정두 막대에서 0.1%에 해당하는 붉은 부분은 폭이 같습니다. 비율이 같으니까요. 다만 0.1%는 눈에 띄지 않을 만큼 얇아서 아래에 왼쪽 끝 2%만 50배로 늘려 함께 그렸습니다 — 보이지 않을 만큼 얇다는 것 자체가 오늘의 함정입니다. 그런데 왼쪽 막대는 1,000명을, 오른쪽 막대는 5,000만 명을 뜻합니다. 비율이 같다는 말은 사람 수가 같다는 말이 아닙니다.

진짜 인구를 넣어 본다 — 출처가 있는 숫자만

위 표의 다섯 인구는 우리가 이야기를 위해 잡은 값입니다. 이번에는 실제로 조사된 인구를 넣어 보겠습니다. 아래 넷은 전부 ① 사실이고, 출처와 그 출처를 얼마나 확인했는지까지 함께 적었습니다.

어디인구출처와 확인 등급 99.0%면 틀리는 사람99.9%면
대한민국약 5,100만 행정안전부 주민등록인구통계(2025년) — 검색 요약으로만 확인 511,550명51,155명
경상북도2,594,539 경상북도 누리집 시·군별 주민등록 인구현황(2025.12.31, 외국인 포함) — 원문 확인 25,945명2,595명
경북 영주시98,465 주민등록 인구(2025년 3월) — 2차 출처, 재확인 필요 985명98명
고등학교 한 학급23 2024 교육기본통계 학급당 학생 수 23.4명(교육부·한국교육개발원, 2024.8.29) — 원문 확인 0명0명
인구는 ① 사실, 정확도 99.0%·99.9%는 ② 가정입니다. 두 종류가 한 표에서 만나는 자리이니 어느 열이 어느 쪽인지 확인하세요. ‘약 5,100만’처럼 반올림해 적은 것은 출처를 검색 요약으로만 확인했기 때문입니다.

맨 아랫줄을 보세요. 우리 반 23명에게 정확도 99.0%짜리 판정기를 대면 틀리는 사람은 0.23명입니다. 표에는 ‘0명’이라고 적혀 있지만 이것은 ‘한 명도 안 틀린다’가 아니라 ‘반올림해서 0명’입니다. 같은 판정기가 나라 전체에서는 511,550명을 틀립니다.

ℹ️ 23명과 23.4명

2024 교육기본통계가 발표한 고등학교 학급당 학생 수는 23.4명입니다 (① 사실). 계산에는 정수 23명을 넣었습니다. 이 단원에서 ‘우리 반’이라는 말은 차시마다 인원이 다릅니다 — 1차시는 25명, 3차시는 30명, 8차시는 28명을 가정합니다. 그중 조사된 실제 값은 이 23.4명 하나뿐입니다. ‘우리 반’이라는 말이 나오면 인원이 몇 명인지, 그것이 조사값인지 가정값인지 확인하는 습관을 들이세요.

⚠️ 여기까지의 ‘정확도’는 아직 반쪽입니다

이 절에서 쓴 정확도는 전체 오분류율입니다. “5,000만 명 중 50,000명이 틀렸다”까지는 알려 주지만, 그 50,000명이 누구인지는 알려 주지 않습니다. 병을 안고 집으로 돌아간 사람인지, 멀쩡한데 놀라서 병원에 다시 온 사람인지 — 정확도 하나로는 갈라낼 수 없습니다. 그것을 보려면 12차시의 네 칸이 필요합니다. 다음 절이 그 일을 합니다.

2

검사는 그대로인데 마을이 바뀌면 — 기저율의 함정

이제 여는 장면의 1만 명 읍으로 돌아갑니다. 손으로 세어 보겠습니다. 계산에 필요한 것은 넷뿐입니다 — 인구, 유병률, 민감도, 특이도.

  • 인구 10,000명 중 실제 환자는 1%이므로 100명, 멀쩡한 사람은 9,900명입니다.
  • 환자 100명 중 민감도 95%가 잡아내니 95명을 맞히고 5명을 놓칩니다.
  • 멀쩡한 9,900명 중 특이도 90%가 통과시키니 8,910명이 정상 판정, 나머지 990명이 헛되이 양성 판정을 받습니다.
  • 양성이라고 뜬 사람은 95 + 990 = 1,085명. 그중 진짜 환자는 95명입니다.
참양성 tp — 환자를 환자라고 95명

12차시의 TP입니다. 제때 치료로 이어집니다.

오경보 fp — 멀쩡한데 환자라고 990명

12차시의 FP(거짓양성)이고, 다른 데서는 오검출이라고도 부릅니다. 이 차시는 ‘헛되이 불러낸다’는 뜻이 드러나게 오경보로 부르겠습니다. 여기가 오늘의 문제입니다.

놓침 fn — 환자인데 정상이라고 5명

12차시의 FN입니다. 병을 안고 집으로 돌아갑니다.

참음성 tn — 멀쩡한 사람을 정상이라고 8,910명

12차시의 TN입니다. 아무 일도 일어나지 않습니다.

양성 판정을 받은 1,085명 중 진짜 환자는 95명. 나눠 보면 8.76%입니다. 여는 장면의 물음에 대한 답이 이것입니다 — 양성이라고 뜬 100명 중 진짜 환자는 9명이 채 되지 않습니다. 이 값에는 이름이 있습니다 — 양성예측도. 그리고 이것은 12차시의 정밀도와 완전히 같은 나눗셈입니다. TP ÷ (TP + FP) — 부르는 이름만 분야에 따라 다릅니다.

⚠️ 95%와 8.76%는 둘 다 참입니다

민감도 95%는 환자 100명 중 95명을 잡았다는 뜻입니다(분모가 환자 전체). 양성예측도 8.76%는 양성이라 부른 1,085명 중 95명이 진짜였다는 뜻입니다(분모가 양성 판정 전체). 분자는 똑같이 95인데 분모가 다릅니다. 12차시에서 정밀도와 재현율을 갈라 놓았던 그 구조 그대로입니다. “95% 정확한 검사”라는 말만 듣고 “양성이면 95% 확률로 환자”라고 읽는 것 — 이것이 가장 흔한 오독입니다.

왜 이렇게 벌어졌을까요? 숫자 두 개를 나란히 놓으면 보입니다. 진짜 환자 95명 대 오경보 990명. 오경보가 진짜 환자를 10.4배로 덮어 버렸습니다. 멀쩡한 사람이 9,900명이나 되니, 그중 10%만 헛짚어도 990명이 되는 것입니다.

유병률만 낮춰 본다 — 검사는 한 글자도 안 고치고

이제 실험을 하나 합니다. 민감도 95% · 특이도 90%는 그대로 두고, 같은 검사를 유병률이 다른 마을에 차례로 가져갑니다. 유병률은 검사의 성질이 아니라 마을의 성질입니다.

유병률참양성오경보놓침양성 판정 수양성예측도
10.0%95090050.0 1,85051.35%
5.0%47595025.0 1,42533.33%
1.0%959905.0 1,0858.76%
0.1%109990.5 1,0080.94%
② 가정인구 10,000명 고정. 민감도 95% · 특이도 90% 고정. ‘놓침’ 열만 소수 한 자리로 적었습니다 — 맨 아랫줄의 0.5명을 0명으로 읽으면 ‘한 명도 안 놓친다’가 되어 버리기 때문입니다.

검사는 한 글자도 바뀌지 않았습니다. 바뀐 것은 마을뿐입니다. 그런데 양성예측도는 51.35%에서 0.94%로 떨어졌습니다. 55분의 1입니다.

기전은 오경보 열에 있습니다. 유병률이 10%에서 0.1%로 백 분의 일이 되는 동안 오경보는 900명에서 999명으로 거의 그대로입니다. 멀쩡한 사람의 수가 9,000명에서 9,990명으로 조금 늘었을 뿐이니까요. 반면 참양성은 950명에서 10명으로 95분의 1이 되었습니다. 분모는 그대로인데 분자만 무너진 것입니다.

양성 판정 1,000명 남짓 — 그 안의 구성이 뒤집힌다 유병률 10% — 양성 1,850명 참양성 950명 오경보 900명 51.35% 유병률 1% — 양성 1,085명 95 오경보 990명 8.76% 유병률 0.1% — 양성 1,008명 오경보 999명 ← 참양성 10명 0.94%
② 가정세 막대의 붉은 칸은 거의 같은 길이입니다(900 → 990 → 999명). 줄어든 것은 초록 칸뿐입니다(950 → 95 → 10명). 오른쪽 끝의 백분율이 양성예측도입니다.

이렇게 기저율(찾으려는 것이 원래 얼마나 흔한가)을 빼놓고 검사 성능만 보는 것을 기저율 무시라고 부릅니다. 사람이 흔히 저지르는 잘못이고, 여러분도 여는 장면에서 “95명쯤”이라고 답했다면 같은 길로 간 것입니다.

그럼 99%짜리 검사라면 괜찮을까 — 한 번에 둘을 바꾸지 않기

그럼 검사를 더 좋게 만들면 되지 않을까요? 민감도도 특이도도 99%인 검사를 유병률 0.1%인 지역, 인구 10만 명에게 돌려 봅시다.

참양성오경보놓침참음성양성 판정양성예측도
99999198,901 1,0989.02%
② 가정인구 100,000명 · 유병률 0.1% · 민감도 99% · 특이도 99%.

양성이라고 뜬 100명 중 실제 환자는 9명입니다. 나머지 91명은 오경보입니다. 앞의 1만 명 읍에서 8.76%였던 것이 여기서 9.02%이니, 검사를 95/90에서 99/99로 올렸는데 제자리걸음을 한 것처럼 보입니다.

⚠️ 여기서는 두 가지가 함께 바뀌었습니다

검사만 바뀐 것이 아닙니다. 마을도 바뀌었습니다 — 유병률 1%에서 0.1%로. 두 변화를 하나씩 떼어 계산기로 확인해 보세요.

  • 마을은 그대로 두고(1만 명 · 유병률 1%) 검사만 99/99로 올리면 → 양성예측도 50.00%
  • 검사는 그대로 두고(95/90) 마을만 유병률 0.1%로 옮기면 → 양성예측도 0.94%

둘을 한꺼번에 바꾸니 한 변화가 다른 변화를 거의 지워 9.02%가 되었습니다. “99%로 올렸는데도 소용없다”고 읽으면 틀립니다 — 마을을 그대로 두었다면 50%까지 올랐습니다. 한 번에 하나만 바꾸어야 무엇이 무엇을 움직였는지 알 수 있습니다. 이것이 앞 절에서 ‘검사는 한 글자도 안 고치고’를 굳이 밝힌 까닭입니다.

그래도 남는 사실이 있습니다. 유병률 0.1% 마을에서는 99%짜리 검사조차 양성 100명 중 9명밖에 맞히지 못합니다. 성능만 말한 문장도, 마을만 말한 문장도 답이 되지 못합니다. 둘을 함께 말해야 뜻이 생깁니다.

그럼 민감도를 올릴까, 특이도를 올릴까

같은 마을(유병률 0.1%)에 성능만 바꿔 가며 놓아 봅니다. 이 표가 오늘 가장 중요한 표입니다.

민감도 / 특이도양성 판정진짜 환자양성예측도놓친 환자
90.0% / 90.0%10,080900.89%10
95.0% / 90.0%10,085950.94%5
95.0% / 95.0%5,090951.87%5
99.0% / 99.0%1,098999.02%1
99.0% / 99.9%1999949.77%1
② 가정인구 100,000명 · 유병률 0.1% 고정. 첫 두 줄은 민감도만 90→95로 올린 것이고, 마지막 두 줄은 특이도만 99→99.9로 올린 것입니다. 가운데 셋째 줄에서 넷째 줄로 갈 때는 둘이 함께 오르니, 여기서는 무엇이 값을 움직였는지 가려낼 수 없습니다.

이번에는 마을을 고정해 두었으니, 한 번에 하나씩만 바뀌는 줄끼리 견주면 됩니다. 첫 두 줄은 민감도만 90% → 95%로 올린 것입니다. 양성예측도는 0.89% → 0.94%, 거의 움직이지 않습니다. 마지막 두 줄은 특이도만 99% → 99.9%로 올린 것입니다. 이번에는 9.02% → 49.77%로 뜁니다. 드문 병에서는 ‘놓치지 않는 힘’이 아니라 ‘헛되이 부르지 않는 힘’이 값을 정합니다.

💡 왜 그럴까 — 분모를 보면 알 수 있습니다

양성예측도의 분모는 참양성 + 오경보인데, 드문 병에서는 이 분모가 거의 전부 오경보입니다(999 대 99). 민감도는 분자(참양성)에만 손을 대고, 특이도는 분모의 큰 쪽(오경보)에 손을 댑니다. 큰 쪽을 건드려야 비율이 움직입니다. 이것이 다음 절에서 다룰 ‘배치’의 근거가 됩니다.

3

그래서 어디에 놓을 것인가 — 배치가 성능만큼 결정적이다

이제 진짜 숫자를 하나 넣어 보겠습니다. 우리나라의 결핵 통계입니다.

ℹ️ ① 사실 2024년 결핵환자 신고 현황

2024년 한 해 동안 신고된 결핵환자는 17,944명, 인구 10만 명당 35.2명입니다. 그중 신규 환자만 세면 14,412명, 10만 명당 28.2명입니다.

출처: 질병관리청 「2024년 결핵환자 신고현황」(2025년 3월 24일 보도자료)

⚠️ 이 35.2명을 유병률 자리에 넣는 것은 ‘가정’입니다

35.2명은 발생률입니다 — 한 해 동안 새로 신고된 사람의 수이지, 지금 이 순간 병을 가진 사람의 비율(유병률)이 아닙니다. 선별검사 계산에는 원래 유병률을 넣어야 합니다. 그런데 우리나라 결핵 유병률은 공개된 수치를 찾지 못했습니다. 그래서 아래 계산은 ② 가정 “발생률을 유병률 대신 넣으면”이라는 가정 위에 서 있습니다. 이 단서를 빼고 결과만 옮기면, 조사된 사실과 우리가 만든 계산을 섞은 것이 됩니다.

가정을 밝혔으니 계산합니다. 전국 인구 약 5,100만 명에게 민감도 95% · 특이도 90%짜리 검사를 한 번 돌리면 이렇게 됩니다.

양성 판정그중 진짜 환자양성예측도놓친 환자
5,130,804명17,106명 0.333%900명
인구는 ① 사실(약 5,100만 명, 행정안전부 주민등록 기준), 성능 95/90과 ‘발생률을 유병률로’는 ② 가정입니다. 인구를 반올림해 적는 까닭은 이 통계를 검색 요약으로만 확인했기 때문입니다 — 자릿수까지 못 박으려면 원문을 열어야 합니다.

양성 300명 중 1명만 진짜 환자입니다. 나머지 299명은 다시 불려 옵니다. 513만 명에게 “양성입니다”라는 통보가 나가고, 그 사람들이 전부 병원에 다시 와야 합니다.

이 숫자는 “그러니 AI를 쓰면 안 된다”는 뜻이 아닙니다. 실제 결핵 검진도 X선 한 장으로 끝내지 않습니다. X선은 선별검사이고, 확진은 객담검사가 맡습니다. 선별과 확진은 원래 역할이 다릅니다. ‘어디에 배치하느냐’가 ‘얼마나 정확하냐’만큼 결정적이라는 말이 이 뜻입니다.

사람을 2단계로 붙이면 — 나아진 것과 새로 치르는 값

다시 1만 명 읍으로 돌아옵니다. AI가 양성이라고 부른 1,085명을 의사가 다시 판독하는 단계를 붙여 보겠습니다. 의사의 재판독 성능은 민감도 98% · 특이도 99%로 두겠습니다(② 가정).

단계양성 판정그중 진짜 환자양성예측도
1차 — AI1,085명95명8.8%
2차 — 의사 재판독103명93명90.4%
② 가정인구 10,000명 · 유병률 1% · AI 95/90 · 의사 98/99.

양성예측도가 8.8%에서 90.4%로 열 배 넘게 좋아졌습니다. “양성입니다”를 받은 103명 중 93명이 진짜 환자이니, 이제 그 통보가 뜻을 갖습니다. 그리고 사람이 봐야 할 사진이 10,000장에서 1,085장으로 줄었습니다 — 선별 AI가 실제로 해 주는 일이 바로 이것입니다.

그런데 치르는 값도 함께 세야 합니다.

  • 재판독 1,085건. 이 일은 사람이 합니다. 시간과 인건비가 새로 듭니다.
  • 1차에서 놓친 환자 5명. 이 사람들은 AI가 음성이라고 했으니 의사에게 아예 가지 않습니다. 2단계를 붙여도 구할 수 없습니다.
  • 2차에서 새로 놓친 환자 1.9명. 1차 양성이었는데 의사가 정상으로 판독한 사람입니다. 의사도 민감도 98%이지 100%가 아니니까요.
  • 끝내 놓친 환자 = 5 + 1.9 = 6.9명. 실제 환자 100명 중 6.9%입니다. 2단계를 붙이자 놓친 환자가 5명에서 6.9명으로 늘었습니다.
⚠️ ‘사람이 확인하면 오류가 사라진다’는 참이 아닙니다

2단계는 공짜가 아닙니다. 양성예측도를 열 배로 올리는 대신 재판독 1,085건과 끝내 놓친 6.9명을 치렀습니다. 사람을 붙이면 오경보는 크게 줄지만, 놓침은 오히려 늘어납니다. 6차시에서 ‘언제 사람이 확인할 것인가’를 다룰 때 이 6.9명을 다시 꺼내게 됩니다.

그러면 재판독을 여러 번 반복하면 어떻게 될까요? 실제로 돌려 보면 이렇습니다.

재판독 횟수양성예측도끝내 놓친 환자
0회 (AI만)8.76%5.0명
1회90.39%6.9명
2회99.89%8.8명
3회100.00%10.6명
② 가정매 단계 민감도 98% · 특이도 99%인 사람이 앞 단계의 양성만 다시 봅니다. 정밀해질수록 사람이 빠져나갑니다. 100.00%는 ‘완벽’이 아니라 ‘남은 사람이 거의 다 환자’라는 뜻이고, 그 대가로 10.6명이 문 밖에 있습니다.

그럼 특이도를 얼마나 올려야 하나

“오경보가 문제라면 특이도를 올리면 되지 않나”는 당연한 반문입니다. 얼마나 올려야 하는지 거꾸로 풀어 보겠습니다. 유병률 0.1% · 민감도 99%로 고정하고, 목표 양성예측도에 필요한 특이도를 구합니다.

목표 양성예측도필요한 특이도허용되는 오경보율
10%99.1081%0.8919%
30%99.7688%0.2312%
50%99.9009%0.0991%
90%99.9890%0.0110%
② 가정유병률 0.1% · 민감도 99% 고정. 식을 특이도에 대해 푼 값입니다. 같은 답을 0.001%p씩 훑어서 찾아도 99.9010%가 나옵니다(그때 양성예측도 50.03%).

양성 판정의 절반만 진짜이게 하려면 특이도를 99.00%에서 99.90%까지 올려야 합니다. 말을 바꾸면 오경보를 10분의 1로 줄이라는 뜻입니다. “민감도를 99%로!”는 쉬운 구호지만, 드문 병에서 승부는 특이도에서 납니다.

ℹ️ 그럼 유병률이 얼마여야 이 검사가 쓸 만할까

민감도 95% · 특이도 90%인 검사로 양성예측도 50%를 넘기려면 유병률이 9.6% 이상이어야 합니다(0.1%p씩 올려 가며 찾은 값, ② 가정). 그런데 열 명 중 한 명이 앓는 병이라면 굳이 선별검사를 돌릴 이유가 없습니다. 선별이 필요한 병은 늘 드물다는 것 — 이 딜레마가 이 절의 핵심입니다.

💡 배치를 설계한다는 것

지금까지 나온 조절 손잡이를 모으면 넷입니다. ① 어느 무리에 돌릴 것인가(전 국민이냐, 위험군이냐 — 유병률을 바꾼다) · ② 무엇을 우선할 것인가(놓침이냐 오경보냐 — 기준점을 옮긴다) · ③ 뒤에 무엇을 붙일 것인가(확진 검사, 사람 재판독) · ④ 결과를 어떻게 통보할 것인가(‘양성’이냐 ‘추가 검사가 필요합니다’냐). 성능을 올리는 것은 이 넷 중 하나도 아닙니다. 해법 설계의 본체는 배치입니다.

4

다섯 축 — 이 문제에 인공지능을 대도 되는가

“이 사회문제를 AI로 풉시다”라는 제안을 받았을 때 무엇을 물어야 할까요? 다섯 가지로 정리해 두면 발표가 장밋빛으로 흐르는 것을 막을 수 있습니다.

① 데이터가 있는가

이미 쌓여 있는가, 새로 모아야 하는가. 모을 수 있다 해도 그 과정이 정당한가.

② 패턴이 있는가

과거가 미래를 알려 주는 문제인가. 규칙이 자주 바뀌면 학습한 것이 곧 낡습니다.

③ 정답을 정의할 수 있는가

무엇이 ‘맞음’인지 사람들이 합의할 수 있는가. 이름표를 붙일 수 없으면 배울 수 없습니다.

④ 틀렸을 때 비용을 누가 지는가

오류의 재검사 비용을 시스템이 나눠 지는가, 한 사람이 혼자 떠안는가.

⑤ 가치 판단이 얼마나 걸려 있는가

이 축만 낮을수록 좋습니다. 문제의 본체가 ‘무엇이 옳은가’라면 계산으로 옮길 수 없습니다.

다섯 축에 0~2점을 매겨 봅니다. 다섯째 축만 뒤집어 세어(2점이면 0점으로) 10점 만점을 만듭니다.

사회문제데이터패턴정답비용가치합계
결핵 X선 선별2222010 / 10
산불 조기 감지222109 / 10
농작물 병해 진단122209 / 10
학생 자퇴 위험 예측111023 / 10
형량을 정하는 AI100021 / 10
② 가정이 점수는 우리가 매긴 것이지 판정 결과가 아닙니다. 여러분이 다르게 매길 수 있고, 그 차이를 놓고 이야기하는 것이 이 표의 쓰임새입니다.

형량을 정하는 AI가 걸려 넘어지는 곳은 ‘데이터가 없어서’가 아닙니다. 판결문은 오히려 많이 쌓여 있습니다. 무너지는 곳은 다른 셋입니다 — 적정 형량이라는 정답을 정의할 수 없고, 틀렸을 때 비용을 피고인 혼자 지고, 가치 판단이 문제의 본체입니다. 세 축이 동시에 0~1점입니다.

⚠️ 10점을 받아도 그대로 놓아서는 안 됩니다

결핵 X선 선별은 이 표에서 10점 만점에 10점입니다. 그런데 우리는 방금 그것이 전국 규모에서 양성예측도 0.333%로 무너지는 것을 보았습니다. 다섯 축을 통과한다는 것은 ‘풀 수 있다’는 뜻일 뿐, ‘그대로 배치해도 된다’가 아닙니다. 다섯 축은 문 앞에서 묻는 것이고, 배치 설계는 문 안에서 하는 일입니다.

ℹ️ 이 다섯 축이 놓치는 것

점수표는 예언이 아니라 생각을 정리하는 도구입니다. 놓치는 것도 있습니다 — 점수는 시간에 따라 바뀝니다(데이터가 쌓이면 ①이 오릅니다). 같은 문제라도 어디에 놓느냐에 따라 ④가 달라집니다(전 국민 검진과 위험군 검진은 비용을 지는 사람이 다릅니다). 그리고 점수를 매기는 사람에 따라 갈립니다 — 특히 ⑤는 거의 언제나 갈립니다. 합계가 몇 점인지보다 어느 축에서 갈렸는지가 8차시 토론의 재료가 됩니다.

마스크를 쓴 사람들이 빽빽하게 무리 지어 도심의 횡단보도를 건너는 모습
일본 도쿄 시부야 교차로. 신호 한 번에 횡단보도 하나를 건너는 사람만 해도 이만큼입니다. 이런 줄이 하루 종일, 나라 곳곳에서 이어집니다. 여기에 판정기를 하나 놓으면 0.1%도 사람 수로는 큰 무리가 됩니다. 오늘의 계산은 결국 이 장면을 숫자로 옮긴 것입니다. 출처: Dick Thomas Johnson, Wikimedia Commons (CC BY 2.0)
💻

손으로 ① — 규모 계산기

이제 여러분이 직접 돌릴 차례입니다. 아래 계산기는 파이썬을 부르지 않고 브라우저가 그 자리에서 계산합니다. 자가 두 개 들어 있습니다.

  • ① 규모 자 — 인구와 정확도를 밀면 틀린 사람 수가 사람 그림으로 채워집니다. 이 자는 ‘몇 명이 틀렸나’까지만 알려 줍니다.
  • ② 기저율 자 — 유병률 · 민감도 · 특이도를 밀면 그 틀린 사람들이 놓친 환자인지 오경보인지 갈라집니다. 12차시의 네 칸이 사람 수로 돌아오는 자리입니다.

먼저 [📌 본문 1만 명 마을]을 눌러, 앞 절에서 손으로 센 95 / 990 / 5 / 8,910과 양성예측도 8.76%가 그대로 나오는지 확인하세요. 계산기가 본문과 같은 값을 낸다는 것을 한 번 확인하고 나면, 그다음부터 나오는 숫자를 믿을 수 있습니다.

👥 규모 계산기 — 비율을 사람 수로 되돌린다 INTERACTIVE

사람 그림 한 칸이 몇 명을 뜻하는지는 인구에 따라 달라집니다(그림 위에 적힙니다). 인구가 1,000명 이하면 한 칸이 정확히 한 사람입니다. 아래 [▶ 재생]을 누르면 슬라이더가 저절로 움직이면서 그림과 곡선이 함께 변합니다.

틀린 사람 맞힌 사람
인구10,000명
정확도99.0%
틀린 사람 수100명
맞힌 사람 수9,900명
사람 그림 한 칸10명

⚠ 두 자를 섞지 마세요. ① 규모 자의 ‘정확도’는 전체 오분류율이라 누가 틀렸는지를 말해 주지 않습니다. 그것을 보려면 ② 기저율 자로 넘어가야 합니다.

[안내] 슬라이더를 밀어 보세요. [📌 본문 1만 명 마을]을 누르면 교과서 본문과 같은 값이 나옵니다.

과제 ① — 표를 채운다 (규모 자)

정확도를 99.9%로 고정하고 인구만 바꿔 가며 ‘틀린 사람 수’를 적으세요. 마지막 칸에는 그 수를 보고 든 생각을 한 줄로 씁니다.

인구틀린 사람 수한 칸이 몇 명이 수를 한 사람씩 확인할 수 있는가
1,000
10,000
100,000
5,000,000
50,000,000

그림을 잘 보세요. 인구를 키워도 붉은 칸의 개수는 거의 그대로입니다. 비율이 같으니까요. 달라지는 것은 그림 위에 적힌 ‘한 칸 = 몇 명’뿐입니다. 이것이 오늘 그림이 하려는 말입니다 — 같은 그림, 다른 사람 수.

과제 ② — 문턱을 찾는다 (기저율 자)

② 기저율 자로 넘어가서 인구 10,000명 · 민감도 95% · 특이도 90%로 두고, 유병률만 한 칸씩 내려 보세요. 네 자리에서 숫자를 적고, 양성예측도가 처음으로 10% 아래로 떨어지는 유병률에 동그라미를 치세요.

유병률참양성오경보놓침양성 판정 수양성예측도
10%
5%
1%
0.1%

과제 ③ — 반례를 만든다

🎯 민감도를 무력하게 만드는 마을을 만들어라

민감도를 99.9%까지 올려도 양성예측도가 1%를 넘지 못하는 설정을 만들어 보세요. 인구 100,000명 · 특이도 90%에 두고, 유병률을 어디에 놓아야 하는지 찾으면 됩니다. 찾았으면 민감도만 80% → 99.9%로 밀어 보고 양성예측도 두 값을 적으세요.

이번에는 반대로 민감도를 80%에 묶어 두고 특이도만 90% → 99.9%로 밀어 보세요. 양성예측도가 얼마에서 얼마로 갑니까? 두 실험을 나란히 놓고, 왜 민감도는 힘을 못 쓰고 특이도만 듣는지 한 문장으로 쓰세요. 힌트는 앞 절에 있습니다 — 양성예측도의 분모를 보세요.

이 세 과제의 결과가 오늘의 확인 문제 2번 · 3번의 답이 됩니다. 숫자를 공책에 옮겨 적어 두세요.

💻

손으로 ② — 파이썬으로 마을을 만든다

계산기는 슬라이더가 정해 준 눈금 위에서만 움직입니다. 파이썬으로 옮기면 눈금 밖의 값을 넣을 수 있고, 우리 시 인구처럼 내가 고른 숫자를 넣을 수 있습니다.

오늘의 부품은 함수 둘입니다. 이름과 인자 순서를 바꾸지 마세요 — 아래 두 칸이 이 서명 그대로 씁니다.

  • screen(pop, prev, sens, spec) → (tp, fp, fn, tn, ppv) — 인구 pop명에게 유병률 prev, 민감도 sens, 특이도 spec인 검사를 한 번 돌려 네 칸과 양성예측도를 돌려줍니다.
  • wrong_people(pop, acc) — 정확도 acc인 판정기를 pop명에게 돌렸을 때 틀린 사람 수를 돌려줍니다.
⚠️ 빈칸 ④에서 가장 많이 틀립니다

양성예측도를 tp / (tp + fn)으로 쓰면 오류가 나지 않고 95%라는 그럴듯한 값이 나옵니다. 그건 민감도입니다. 검산하는 법: 분모가 ‘양성이라고 뜬 사람 수’(1,085)와 같은지 보세요. 오류를 안 내는 실수가 가장 무섭습니다.

여기까지 나온 숫자가 본문의 표와 같은지 맞춰 보세요. 다르다면 빈칸을 잘못 채운 것입니다 — 8.8%와 990이 검산 지점입니다.

다음 칸은 실제 통계를 넣고, 사람을 2단계로 붙이고, 특이도를 거꾸로 풀고, 마지막에 다섯 축으로 판정합니다.

🎯 여기서부터가 여러분의 몫입니다

① 우리 동네를 넣으세요. 맨 아래 TOWN_NAME과 TOWN_POP 두 줄을 자기 시·군으로 바꾸고 다시 실행하세요. 인구는 출처를 확인할 수 있는 것으로 넣고, 어디서 가져왔는지 주석에 적어 두세요.

② 유병률은 바꾸지 마세요. 산불이나 농작물 병해로 문제를 바꾸고 싶어도, 그 유병률을 아는 사람은 이 교실에 없습니다. 모르는 값을 지어내 넣는 순간 계산 전체가 지어낸 이야기가 됩니다. 바꿀 수 있는 것은 인구 두 줄뿐입니다.

③ 다섯 축은 다시 매기세요. CASES에 여러분이 관심 있는 사회문제를 한 줄 더 넣고 0~2점을 매겨 보세요. 짝과 점수가 갈리는 축이 나오면, 그 축이 8차시 토론에서 여러분이 들고 갈 논거입니다.

📖

정리 — 오늘 손에 남은 것

오늘 우리는 12차시의 네 칸을 사람 수로 되돌렸습니다. 남는 문장은 셋입니다.

  • 정확도는 비율이고, 피해는 사람 수다. 같은 99.9%가 학교에서는 1명, 나라에서는 50,000명이었습니다. 성능을 말할 때 규모를 함께 말하지 않으면 아무 말도 하지 않은 것입니다.
  • 검사 성능이 같아도 마을이 바뀌면 성적표가 바뀐다. 민감도 95% · 특이도 90%를 한 글자도 안 고쳤는데 양성예측도는 51.35%에서 0.94%가 되었습니다. 드문 것을 찾을수록 양성 판정의 대부분은 오경보입니다.
  • 해법 설계의 본체는 성능이 아니라 배치다. 어느 무리에 돌릴지, 뒤에 무엇을 붙일지, 결과를 어떻게 통보할지 — 여기서 결정이 납니다. 그리고 사람을 붙이는 것에도 대가가 있습니다(끝내 놓친 6.9명).
오늘 만든 자무엇을 재나이 자가 못 재는 것
규모 자
인구 × (1 − 정확도)
몇 사람이 틀렸나 그 사람들이 놓친 환자인지 오경보인지
기저율 자
양성예측도 = tp ÷ (tp + fp)
양성 판정 중 진짜의 비율 그 통보가 사람에게 무엇을 일으키는지
다섯 축 이 문제에 AI를 댈 수 있는가 대도 되는가 — 그건 배치와 토론이 정한다
세 번째 열이 다음 차시들로 이어집니다. 6차시가 ‘언제 사람이 확인할 것인가’를, 7차시가 ‘누구에게 더 자주 틀리는가’를, 8차시가 ‘그래서 우리는 어떻게 할 것인가’를 맡습니다.
ℹ️ 오늘 넘기는 숫자 — 8차시 토론에서 쓰입니다

양성예측도 8.76%(1만 명 · 유병률 1%) · 전국 규모의 0.333% · 2단계 뒤에도 끝내 놓친 6.9명 · 같은 99.9%가 만드는 1명과 50,000명. 전부 ② 우리가 만든 계산이니, 인용할 때는 “민감도 95% · 특이도 90%를 가정하면”을 반드시 붙이세요. 가정을 빼고 숫자만 옮기면 그 순간 지어낸 사실이 됩니다.

다음 시간에는 이 계산을 다른 양에 대 봅니다. 오늘 우리는 사람 수를 세었는데, 3차시에서는 전기와 탄소를 셉니다. 규모를 곱하는 감각은 그대로 쓰입니다 — 한 번의 질문이 쓰는 전기는 아주 적지만, 그것을 몇 억 번 곱하면 이야기가 달라지니까요.

✅

확인 문제

✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.

1. “민감도 95%”와 “양성이라고 뜬 사람 중 95%가 진짜 환자”는 왜 다른 말인가요? 1만 명 마을의 네 칸 숫자를 들어 설명하세요.
📖 모범 답안

분자는 같고 분모가 다릅니다. 1만 명 마을(유병률 1% · 민감도 95% · 특이도 90%)의 네 칸은 참양성 95 · 오경보 990 · 놓침 5 · 참음성 8,910이었습니다.

민감도는 95 ÷ (95 + 5) = 95%입니다. 분모가 실제 환자 100명이지요. 양성예측도는 95 ÷ (95 + 990) = 8.76%입니다. 분모가 양성이라고 뜬 1,085명입니다. 둘 다 분자는 95인데, 앞의 것은 ‘환자를 얼마나 잡았나’를, 뒤의 것은 ‘부른 사람 중 진짜가 얼마나 되나’를 잽니다.

12차시의 말로 옮기면 민감도는 재현율, 양성예측도는 정밀도입니다. 같은 네 칸에서 나온 서로 다른 두 나눗셈이라 둘 다 참일 수 있습니다. “95% 정확한 검사”라는 한 마디만 듣고 “양성이면 95% 확률로 환자”라고 읽는 것이 가장 흔한 오독입니다.

2. (오늘 돌린 결과) 규모 계산기의 ① 규모 자에서 정확도를 99.9%로 고정하고 인구를 1,000 → 10,000 → 100,000 → 5,000,000 → 50,000,000으로 바꿔 틀린 사람 수를 적으세요. 그리고 화면의 붉은 칸 개수는 왜 변하지 않았는지 쓰세요.
📖 모범 답안

틀린 사람 수: 1 · 10 · 100 · 5,000 · 50,000명 (② 가정 정확도 99.9%). 50,000배 커진 인구에 오류도 정확히 50,000배가 되었습니다.

붉은 칸이 늘 하나인 까닭: 그림은 전체를 1,000칸으로 나눠 그립니다. 0.1%는 1,000칸 중 1칸이라서, 인구가 얼마든 붉은 칸은 하나입니다. 달라진 것은 그림 위에 적힌 ‘한 칸 = 몇 명’뿐입니다 — 1명 / 10명 / 100명 / 5,000명 / 50,000명.

이것이 오늘의 핵심입니다. 비율만 보면 다섯 상황이 똑같아 보입니다. 그림도 똑같습니다. 그런데 오른쪽 끝의 5만 명은 담임 선생님이 한 사람씩 확인할 수 있는 수가 아닙니다. “정확도 99.9%”는 어디에 놓는지를 말하지 않은 문장입니다.

3. (오늘 돌린 결과) ② 기저율 자에서 인구 10,000명 · 민감도 95% · 특이도 90%로 두고 유병률만 10% → 5% → 1% → 0.1%로 내렸을 때 참양성과 오경보가 각각 어떻게 변했는지 적고, 양성예측도가 무너지는 까닭을 그 두 열로 설명하세요.
📖 모범 답안

참양성: 950 → 475 → 95 → 10명 (95분의 1로 줄었습니다). 오경보: 900 → 950 → 990 → 999명 (거의 그대로, 오히려 조금 늘었습니다). 양성예측도는 51.35% → 33.33% → 8.76% → 0.94%로 55분의 1이 되었습니다.

까닭: 양성예측도의 분모는 참양성 + 오경보인데, 드문 병에서는 이 분모가 거의 전부 오경보입니다. 오경보의 크기를 정하는 것은 ‘멀쩡한 사람 수 × (1 − 특이도)’인데, 유병률이 내려가면 멀쩡한 사람 수는 9,000명에서 9,990명으로 거의 안 변합니다. 반대로 참양성은 환자 수에 그대로 비례하니 유병률과 함께 무너집니다. 분모는 그대로인데 분자만 줄어드니 비율이 무너지는 것입니다.

검사는 한 글자도 고치지 않았다는 점을 꼭 함께 적으세요. 바뀐 것은 마을뿐입니다.

4. 드문 병을 찾는 선별용 AI를 개선할 예산이 딱 한 번 있습니다. 민감도와 특이도 중 어느 쪽을 올려야 할까요? 본문의 교차표를 근거로 답하고, 그 선택으로 무엇을 포기하게 되는지까지 쓰세요.
📖 모범 답안

양성예측도를 올리는 것이 목표라면 특이도입니다. 유병률 0.1%인 마을에서 민감도만 90% → 95%로 올리면 양성예측도는 0.89% → 0.94%로 거의 움직이지 않습니다. 그런데 특이도를 99% → 99.9%로 올리면 9.02% → 49.77%로 뜁니다. 큰 쪽(오경보)을 건드려야 비율이 움직이기 때문입니다.

포기하는 것 ①: 같은 표의 맨 오른쪽 열을 보세요. 민감도를 90% → 95%로 올렸을 때 놓친 환자는 10명에서 5명으로 줄었습니다. 특이도를 올리는 선택은 이 절반을 포기하는 것입니다. 선별검사의 목적이 ‘놓치지 않는 것’이라면 답이 달라질 수 있습니다.

포기하는 것 ②: 특이도 99.90%는 오경보를 지금의 10분의 1로 줄이라는 뜻입니다. 그만한 성능을 얻으려면 더 좋은 장비나 추가 검사가 필요하고, 그 비용은 어딘가에서 나와야 합니다.

덧붙일 것: 우리 계산기는 민감도와 특이도를 따로 밀 수 있게 만들었지만, 실제 모델에서는 12차시에서 본 대로 기준점 하나를 옮기면 둘이 반대로 움직입니다. 특이도를 올리려고 기준점을 올리면 민감도가 함께 내려갑니다. 그래서 현실의 선택은 ‘둘 중 하나’가 아니라 ‘어느 쪽 실수를 더 아프게 볼 것인가’입니다.

5. AI 뒤에 사람 재판독 단계를 붙였을 때 나아진 것과 새로 든 값을 각각 한 줄로 쓰세요. 그리고 “사람이 확인하면 오류가 사라진다”는 말이 왜 참이 아닌지 숫자로 반박하세요.
📖 모범 답안

나아진 것: 양성예측도가 8.8% → 90.4%로 열 배 넘게 올랐습니다. “양성입니다”를 받은 103명 중 93명이 진짜 환자입니다. 사람이 봐야 할 사진도 10,000장에서 1,085장으로 줄었습니다.

새로 든 값: 재판독 1,085건을 사람이 떠안았고, 끝내 놓친 환자가 5명에서 6.9명으로 늘었습니다.

반박: 6.9명은 두 조각입니다. ① 1차에서 AI가 음성이라고 한 5명은 의사에게 아예 가지 않습니다. 뒤에 사람을 아무리 붙여도 이 사람들은 만날 수 없습니다. ② 의사도 민감도 98%이지 100%가 아니라, 1차 양성이던 진짜 환자 중 1.9명을 새로 놓칩니다.

재판독을 3회까지 반복하면 양성예측도는 100.00%가 되지만 끝내 놓친 환자는 10.6명이 됩니다. 정밀해질수록 사람이 빠져나갑니다. 사람을 붙이는 것은 오류를 없애는 것이 아니라 오류의 종류를 바꾸는 것입니다.

6. 다섯 축 표에서 ‘형량을 정하는 AI’가 걸려 넘어지는 축은 어디이고 왜인가요? 그리고 ‘결핵 X선 선별’은 10점 만점에 10점인데도 왜 그대로 배치할 수 없었나요? 마지막으로 여러분이 고른 사회문제 하나에 다섯 축을 매기고, 가장 낮은 축을 적으세요.
📖 모범 답안

형량 AI가 걸리는 축은 셋입니다(우리가 매긴 점수 기준). ③ 정답을 정의할 수 없습니다 — ‘적정 형량’이 무엇인지 사람들이 합의하지 못합니다. ④ 틀렸을 때 비용을 피고인 혼자 집니다. ⑤ 가치 판단이 문제의 본체입니다. 데이터(판결문)는 오히려 많습니다 — ‘데이터가 없어서’가 아니라는 점이 중요합니다.

결핵 선별이 10점인데도 무너진 까닭: 다섯 축은 ‘풀 수 있는 문제인가’를 묻는 자입니다. 그런데 전국 규모로 돌리자 양성예측도가 0.333%가 되어, 양성 300명 중 1명만 진짜 환자였습니다. 다섯 축을 통과한다는 것은 ‘풀 수 있다’는 뜻일 뿐 ‘그대로 배치해도 된다’가 아닙니다. 다섯 축은 문 앞에서 묻는 것이고, 배치 설계는 문 안에서 하는 일입니다.

세 번째는 정답이 없습니다. 다만 이렇게 적어야 답이 됩니다 — ⑴ 다섯 축의 점수와 ⑵ 가장 낮은 축, 그리고 ⑶ 그 축을 올리려면 무엇이 필요한지. 짝과 점수가 갈렸다면 어느 축에서 갈렸는지 적어 두세요. 8차시 토론에서 그대로 쓰입니다.

🔁 되돌아보기

오늘 12차시의 네 칸에 인구를 곱해 사람 수로 되돌렸고, 같은 검사가 마을에 따라 전혀 다른 성적표를 받는 것을 직접 만들어 보았다. 다음 시간에는 같은 ‘규모를 곱하는 눈’으로 전기와 탄소를 센다 — 한 번의 질문은 아주 적은 전기를 쓰지만, 그것도 몇 억 번 곱하면 이야기가 달라진다.

🔎

더 알아보기

X선 줄은 왜 짧아졌나, 사람 수로 세면 왜 쉬워지나, 그리고 ‘다시 오세요’ 뒤에서 일하는 사람들

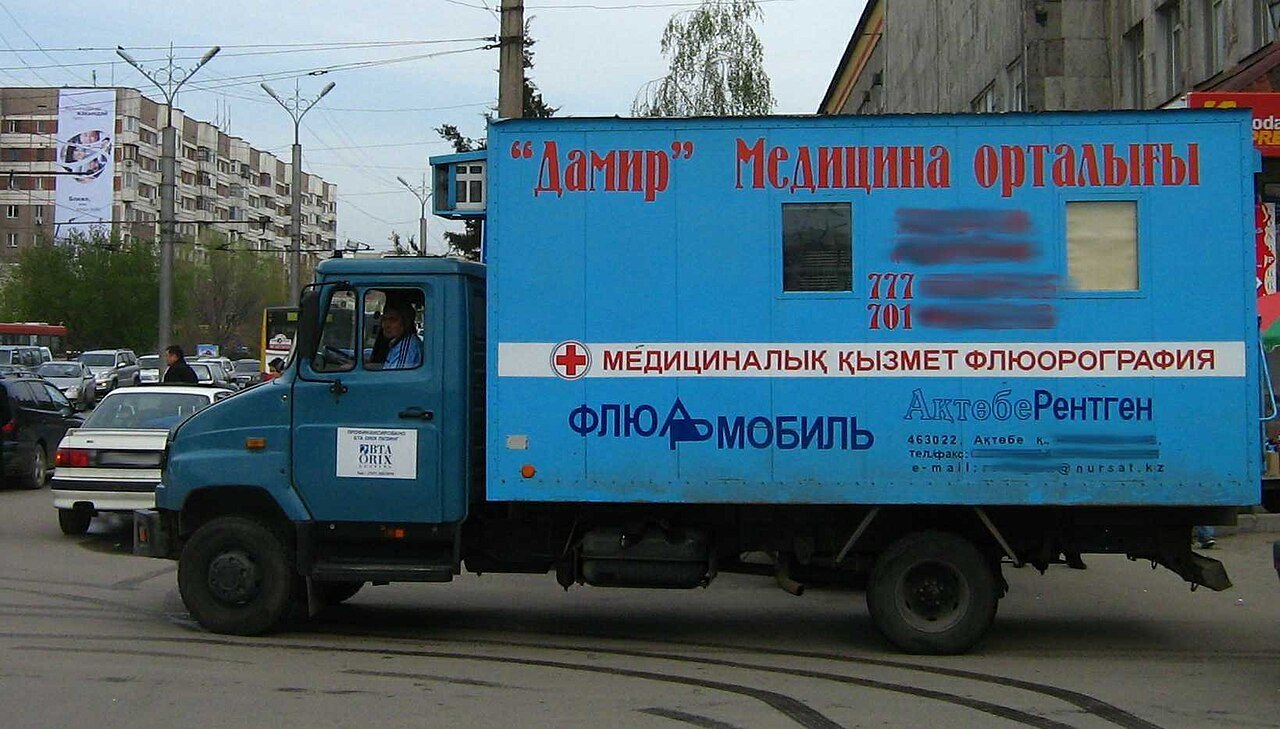
짐칸 옆면에 키릴 문자로 '형광 촬영(флюорография)'과 '플류모빌'이라고 적힌 파란 검진 트럭이 아파트가 늘어선 도심 도로에 서 있고, 운전석에 사람이 앉아 있는 모습
역사

X선 차가 마을을 돌던 시절 — 대량 검진이 물러난 까닭

1930년대에 브라질의 의사 마노엘 지 아브레우(Manoel de Abreu)가 X선 형광 화면을 작은 필름에 옮겨 찍는 간접 촬영법을 내놓자, 흉부 사진 한 장을 찍는 값이 크게 내려갔습니다. 그 뒤 여러 나라가 X선 장비를 차에 싣고 공장·학교·마을을 돌며 증상이 없는 사람을 줄 세워 찍었습니다. 본문 첫 사진의 검진 차량이 바로 그 흐름에 있습니다.

그런데 결핵이 줄어들자 오늘 우리가 계산한 일이 실제로 벌어졌습니다. 유병률이 내려가니 수천 장을 판독해도 찾아내는 환자는 점점 줄고, 다시 불려 오는 사람과 드는 비용은 그대로였습니다. 세계보건기구(WHO) 결핵 전문가 위원회는 1970년대에 이동식 X선 차로 대상을 가리지 않고 훑는 검진을 그만두라고 권고했습니다.

차가 아주 사라진 것은 아닙니다. 사진처럼 이동 촬영 차량을 굴리는 곳은 여전히 있습니다. 다만 쓰임새가 달라져, 이제는 결핵이 더 흔한 무리를 골라 찾아가 검진하는 데 주로 씁니다. 전 국민에서 위험군으로 — 본문의 손잡이 ①(어느 무리에 돌릴 것인가)을 실제로 돌린 것입니다.

사진: 카자흐스탄 악퇴베의 이동 흉부 형광 촬영 차량 · 출처: Ds02006, Wikimedia Commons (Public domain)
1만 명 1% 99% 환자 100명 멀쩡한 사람 9,900명 95% 5% 10% 90% 참양성 95명 놓침 5명 오경보 990명 참음성 8,910명 양성 1,085명 중 진짜 95명 = 8.76% (양성예측도) 퍼센트 대신 ‘몇 명 중 몇 명’으로 두 번 나누면 끝
원리 더 깊이

퍼센트 대신 사람 수로 — 자연 빈도와 베이즈 정리

오늘 1만 명 마을을 손으로 센 방법에는 이름이 있습니다. 확률을 ‘몇 명 중 몇 명’으로 바꿔 세는 것을 자연 빈도라고 합니다. 그림처럼 1만 명을 두 번만 나누면 양성 1,085명 중 진짜 환자가 95명이라는 것이 곧장 눈에 들어옵니다.

같은 문제를 “유병률 1%, 민감도 95%, 특이도 90%일 때 양성이면 환자일 확률은?”처럼 퍼센트로만 내면, 의사를 포함해 많은 사람이 여는 장면의 “95명쯤” 쪽으로 크게 틀린다는 연구가 여럿 있습니다. 독일의 심리학자 게르트 기거렌처(Gerd Gigerenzer)는 같은 문제를 자연 빈도로 바꿔 주기만 해도 맞히는 사람이 크게 늘어난다는 것을 실험으로 보였습니다. 오늘 본문이 비율을 사람 수로 되돌린 까닭이 이것입니다.

수학 쪽 이름은 베이즈 정리입니다. 검사 전 확률(유병률 1%)이 ‘양성 판정’이라는 증거를 만나 검사 후 확률(양성예측도 8.76%)로 바뀝니다. 1%가 8.76%로 올랐으니 양성 판정은 분명히 정보를 줍니다 — 다만 95%까지 올려 주지는 못할 뿐입니다. 본문의 2단계 재판독은 8.76%에서 출발해 이 갱신을 한 번 더 한 것이고, 그래서 90.4%까지 올라갔습니다.

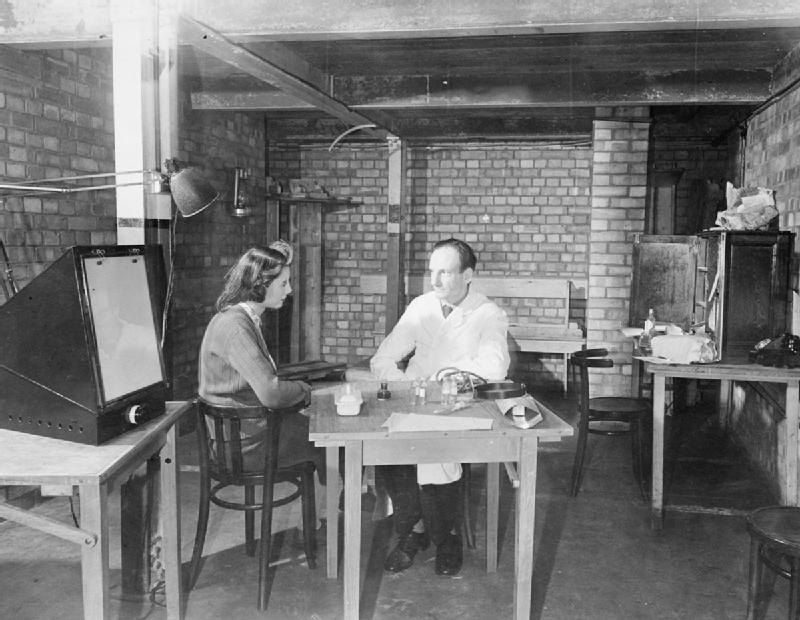
벽돌 벽으로 둘러싸인 임시 진료실에서 흰 가운을 입은 의사와 여성이 탁자를 사이에 두고 마주 앉아 이야기하는 흑백 사진. 왼쪽 탁자에는 비스듬한 화면이 달린 상자가 놓여 있다
진로

‘다시 오세요’라는 통보 뒤에서 — 선별을 설계하는 사람들

사진은 1943년 영국 런던의 한 공장 대피소에 차린 임시 결핵 검진실입니다. 흉부 X선을 찍은 노동자가 재촬영 통보를 받고 다시 불려 와 의사와 이야기하고 있습니다. 이 사람이 참양성인지 오경보인지는 사진만으로 알 수 없습니다 — 오늘 표의 오경보 990명이 모두 한 번씩 이 의자에 앉는다고 생각하면 규모가 실감 납니다.

이런 통보를 누구에게 몇 명이나 보낼지, 재검을 누가 맡을지를 정하는 것이 선별 프로그램을 설계하는 사람들의 일입니다. 역학자와 의료 통계학자는 유병률·양성예측도·재검 비용을 계산해 검진 대상과 간격을 정하고, 영상의학과 의사는 AI가 올린 양성을 다시 읽는 2차 판독을 맡습니다.

의료 인공지능 쪽에도 자리가 생겼습니다. 세계보건기구는 2021년 결핵 선별 지침에서, 선별이 권고되는 집단의 15세 이상이라면 디지털 흉부 X선을 사람 대신 컴퓨터 보조 판독(CAD) 소프트웨어가 읽어도 된다고 (조건부로) 권고했고, 우리나라에서도 흉부 X선 판독을 돕는 AI가 식품의약품안전처의 의료기기 허가를 받아 쓰이고 있습니다. 이런 제품을 만들고 검증하는 사람에게는 모델을 짜는 솜씨만큼 ‘어느 마을에 놓이면 몇 명이 다시 불려 오는가’를 계산하는 눈이 필요합니다. 확률과 통계, 생명과학, 프로그래밍을 함께 쌓으면 이 길로 이어집니다.

사진: 재촬영 통보를 받고 다시 온 노동자와 의사(런던, 1943) · 출처: Ministry of Information Photo Division Photographer, Wikimedia Commons (Public domain)