2차시에서 모은 급식 기록도, 3차시에서 갈라 본 사진 데이터도
실제로 열어 보면 깨끗하지 않습니다. 오늘 우리 앞에 놓인 표에는
빈칸이 여덟 자리 있고, 키가 1750cm라고 적힌 줄이 하나 있습니다.
지우는 게 나을까요, 채우는 게 나을까요 — 그리고 그 결정이 평균을 얼마나 바꿀까요?
성취기준 12인기02-02
결측치이상치사분위 범위(IQR)z 점수가림(masking)전처리 순서
🎯 학습 목표
값이 왜 비었는지를 세 가지로 나누고, 그 까닭마다 처방이 달라져야 하는 이유를 설명할 수 있다.
IQR 1.5배 규칙과 z 점수 3 규칙으로 이상치를 판정하고,
두 기준이 서로 다른 답을 내는 값을 직접 찾아 그 까닭을 말할 수 있다.
처리 방식을 바꿔 가며 평균·중앙값·표준편차를 다시 재고,
지우기에도 대가가 있다는 것을 숫자로 보일 수 있다.
🤔
여는 장면 — 여덟 명짜리 표 하나
체육 시간에 반 학생 여덟 명의 키와 하루 걸음 수를 적었습니다.
표는 이렇게 생겼습니다. 눈으로 한 번 훑어보세요.
번호
키(cm)
걸음 수
1
168
8200
2
(빈칸)
7400
3
172
9100
4
1750
6800
5
161
7900
6
175
10200
7
169
7700
8
166
7000
체육 시간에 손으로 적은 여덟 명의 키와 하루 걸음 수. 오늘은 키 열만 봅니다.
표에서 이상한 곳 두 군데가 바로 보입니다.
2번은 키 칸이 비어 있고, 4번은 1750cm라고 적혀 있습니다.
1750cm는 17.5미터입니다. 5층 건물 높이지요. 아마 175.0을 적으려다
소수점을 빠뜨렸을 것입니다.
그런데 이 표를 그대로 컴퓨터에 넘기면 어떻게 될까요.
컴퓨터는 "이상하다"고 생각하지 않습니다. 그냥 더하고 나눕니다.
빈칸을 뺀 일곱 명의 키 평균은 이렇습니다.
손대지 않고 그냥 평균
(168+172+1750+161+175+169+166) ÷ 7
394.4 cm
반 평균 키가 3미터 94센티입니다.
이 반에 3미터가 넘는 학생은 한 명도 없는데도 그렇습니다.
1750 하나만 빼고 평균
(168+172+161+175+169+166) ÷ 6
168.5 cm
이제야 사람 키처럼 보입니다.
값 하나가 평균을 225.9cm 끌어올리고 있었습니다.
같은 표에서 중앙값도 재 봅시다. 중앙값은 크기순으로 줄을 세웠을 때
한가운데 있는 값입니다. 일곱 명을 줄 세우면
161 · 166 · 168 · 169 · 172 · 175 · 1750 이고 한가운데는 169.0입니다.
1750을 빼면 여섯 명이 되는데, 짝수라 한가운데가 없습니다.
이럴 때는 한가운데에 걸친 두 값 168과 169의 평균을 씁니다.
168.5입니다.
⚠️ 오늘의 물음
1750 하나 때문에 평균은 225.9cm 움직였는데 중앙값은 0.5cm 움직였습니다.
그렇다면 우리는 저 1750을 지워야 할까요, 고쳐야 할까요, 그냥 두어야 할까요?
그리고 2번의 빈칸은 버려야 할까요, 채워야 할까요?
오늘은 이 두 물음에 숫자로 답합니다. 취향이 아니라 결과를 재서 고릅니다.
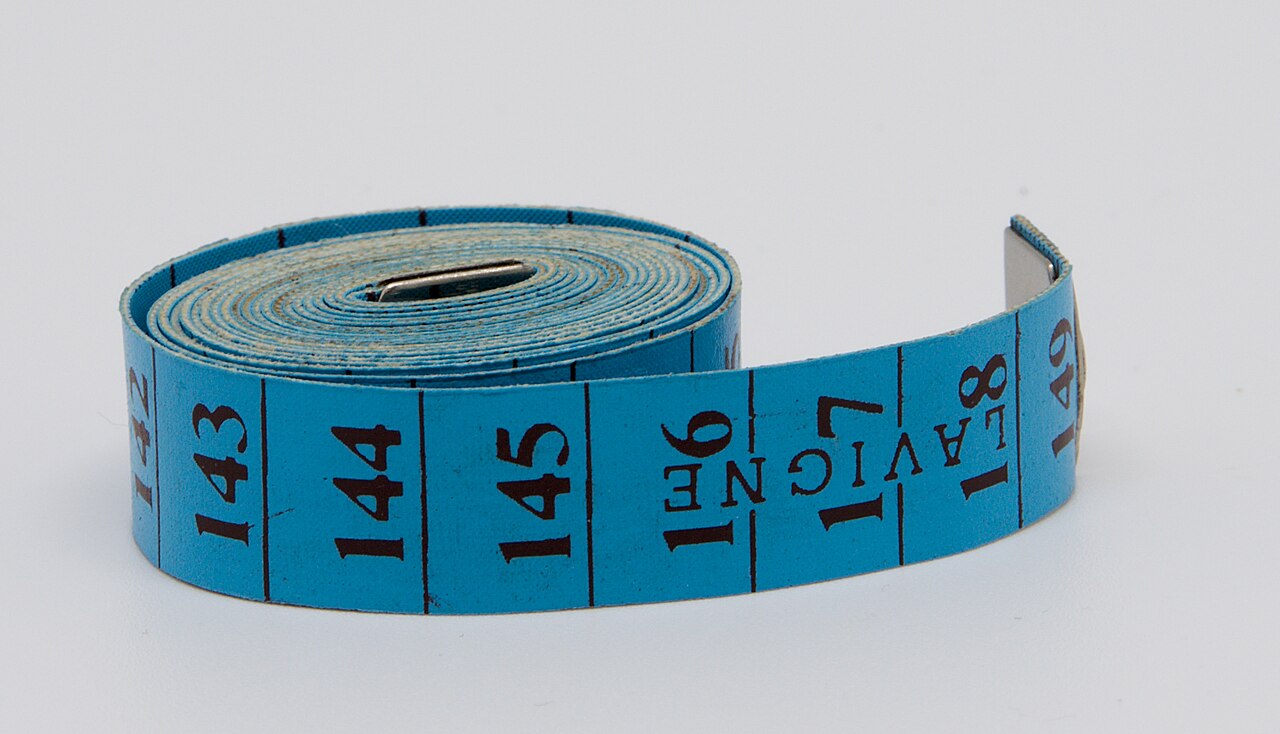
줄자의 눈금은 175.0과 1750을 구분해 주지 않습니다 —
구분은 그것을 표에 옮겨 적는 사람이 합니다. 데이터의 오류는 대개 세상이 아니라
기록하는 자리에서 생깁니다.
출처: Clément Bucco-Lechat, Wikimedia Commons (CC BY-SA 3.0)
1
빈칸을 채우기 전에 — 왜 비었는지부터 묻는다
값이 비어 있는 것을 결측치(missing value)라고 합니다.
많은 사람이 결측치를 보면 곧바로 "그럼 평균으로 채우자"고 합니다.
그런데 채우는 방법을 고르기 전에 물어야 할 것이 하나 있습니다.
이 칸은 왜 비었을까요?
까닭은 크게 셋으로 나뉘고, 셋에 맞는 처방이 서로 다릅니다.
📝
① 기록을 빠뜨렸다
값은 세상에 있었는데 적는 사람이 놓쳤습니다. 종이가 젖었거나, 줄을 건너뛰었거나,
센서가 잠깐 꺼졌습니다. 비어 있다는 사실 자체에는 뜻이 없습니다.
→ 채워도 됩니다. 남은 값들의 대표값으로 메우는 것이 이 경우에 가장 잘 맞습니다.
🙅
② 답하기를 거부했다
몸무게를 묻는 칸을 일부러 비운 사람들이 있습니다. 소득을 안 적은 사람들도 그렇습니다.
비어 있다는 사실이 곧 정보입니다. 대개 한쪽으로 치우쳐 있습니다.
→ 평균으로 채우면 그 정보가 사라집니다. 차라리 '무응답'이라는
별도의 표시를 하나 더 두는 편이 낫습니다.
🚫
③ 애초에 해당이 없다
'마지막 아르바이트 시급' 칸이 비어 있는 사람은 아르바이트를 한 적이 없는 사람입니다.
값이 없는 게 아니라 값이 있을 자리가 아닙니다.
→ 채우면 안 됩니다. 채우는 순간 하지도 않은 아르바이트를 한 것으로
만들어 버립니다.
같은 빈칸이라도 ①이면 채우고, ②면 표시를 남기고, ③이면 손대지 않습니다.
그런데 표만 봐서는 셋을 구별할 수 없습니다. 구별하려면 데이터가 어떻게 걷혔는지를
알아야 합니다. 3차시에서 밝은 털 강아지 사진만 잔뜩 모았을 때 무슨 일이 났는지 떠올려 보세요.
데이터를 어떻게 걷었는가가 데이터의 성질을 정한다는 그 이야기가 여기서 다시 돌아옵니다.
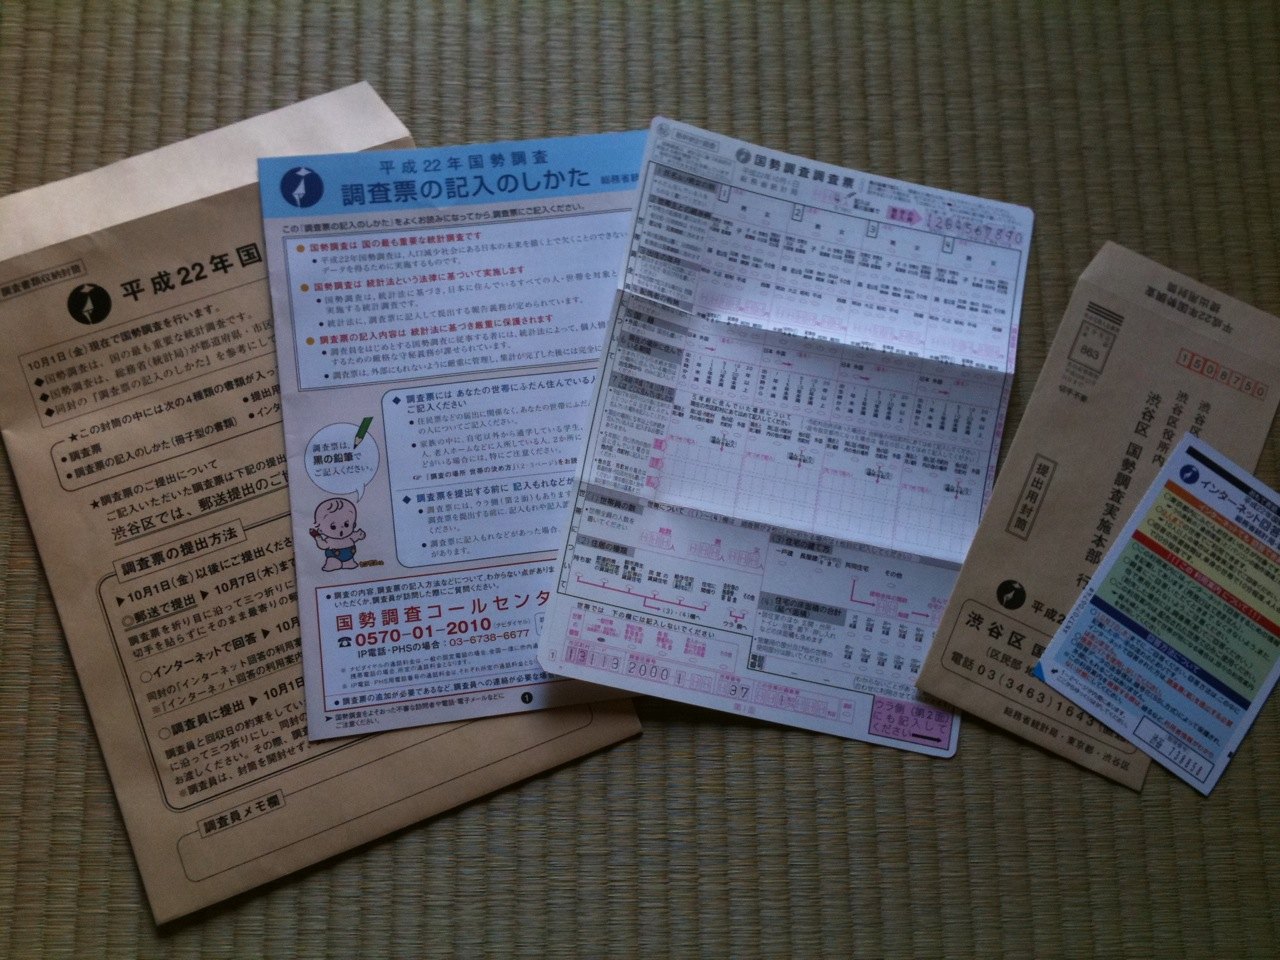
일본 2010년 인구 조사(국세조사)의 서류 묶음입니다. 봉투와 함께 조사표 기입 안내서가 따로 들어 있을 만큼 칸이 많지요.
이런 조사표의 빈칸은 세 얼굴을 하고 있습니다 — 못 본 칸, 일부러 넘긴 칸, 자기와 상관없어 넘어간 칸.
표에 옮겨 담으면 셋이 똑같은 빈칸이 됩니다. 구별은 표가 아니라 조사를 설계하고 걷은 사람만 할 수 있습니다.
출처: Tatsuo Yamashita, Wikimedia Commons (CC BY 2.0)
⚠️ 빈칸을 0으로 바꾸지 마세요
가장 흔하고 가장 조용한 사고입니다.
표를 정리하다가 빈칸에 0을 적어 넣는 것이지요. 하지만 둘은 다른 뜻입니다.
0은 "0이라고 적혀 있다"는 뜻이고,
빈칸은 "아무것도 적혀 있지 않다"는 뜻입니다.
키 칸에 0을 넣으면 키가 0cm인 학생이 생깁니다. 뒤에서 볼 52명 표에서 실제로 해 보면
평균이 190.18cm가 되고, 더 우스운 일이 벌어집니다 —
0 자신이 이상치로 잡힙니다. 없던 이상치를 내 손으로 만든 것입니다.
파이썬에서는 0이 아니라 None으로 둡니다.
2
무엇으로 채울 것인가 — 평균은 끌려가고 중앙값은 버틴다
①번, 그러니까 "채워도 되는" 빈칸이라고 판단했다고 합시다.
무엇으로 채울까요? 실제로 쓰이는 방법은 다섯 가지쯤 됩니다.
각각 성질이 다릅니다.
채우는 방법
언제 쓰나
약점
평균
숫자 열이고, 값들이 고르게 퍼져 있을 때
이상치 하나에 통째로 끌려갑니다. 오늘 배울 사고가 여기서 납니다
중앙값
숫자 열인데 튀는 값이 섞여 있을 때
값들의 미세한 차이를 무시합니다. 순위만 보기 때문입니다
최빈값
범주형 열(성별·요일·메뉴 이름 등)
가장 흔한 값 쪽으로 데이터가 더 쏠립니다
앞뒤 값
시간 순서가 있는 열(기온·주가·걸음 수 기록)
순서가 없는 데이터에 쓰면 아무 뜻이 없습니다
다른 특성으로 예측
키가 비면 몸무게·나이로 키를 추정하기
가장 정교하지만, 추정의 오차가 뒤로 번집니다
다섯 가운데 앞의 둘, 평균과 중앙값의 차이가 오늘의 주인공입니다.
평균과 중앙값은 둘 다 "가운데쯤"을 가리키는 값인데, 튀는 값 하나 앞에서
정반대로 행동합니다. 왜 그럴까요?
평균 — 모든 값을 더한다
평균은 값 자체를 전부 더해서 개수로 나눕니다.
그래서 값 하나가 엄청나게 크면 그 크기가 그대로 합계에 들어갑니다.
1750은 175보다 1575만큼 큽니다. 일곱 명으로 나누면
1575 ÷ 7 ≒ 225. 여덟 명 표에서 평균이 225.9cm 올라간 것이
바로 이 계산입니다. 한 명이 나머지 여섯을 이깁니다.
중앙값 — 줄만 세운다
중앙값은 순위만 봅니다. 1750이든 175든 10000이든,
"제일 큰 값"이라는 자리는 똑같습니다.
그래서 맨 끝의 값을 아무리 크게 만들어도 한가운데 값은 꿈쩍하지 않습니다.
이런 성질을 튼튼하다(robust)고 합니다.
52명 표에서 다시 재 본다
여덟 명은 눈으로 따라가기 좋았지만, 진짜 데이터는 더 큽니다.
오늘 우리가 쓸 표는 52명 × 5열입니다 —
번호 · 키 · 몸무게 · 걸음 수 · 수면 시간. 두 학급쯤 되는 크기입니다.
이 표에는 빈칸이 여덟 자리(키 2 · 몸무게 2 · 걸음 수 3 · 수면 1) 있고,
17번의 키가 1750.0으로 적혀 있습니다.
빈칸이 하나라도 있는 행은 8행, 52행 중 15.4%입니다.
"빈칸 있는 줄은 다 버리자"고 하면 열 명 중 한 명 반이 사라진다는 뜻입니다.
키 열에서 빈칸을 뺀 50개 값으로 세 통계를 재 보겠습니다.
1750을 넣은 채 잰 것과, 1750만 뺀 49개로 잰 것을 나란히 놓습니다.
잰 것
1750을 넣은 채 (50개)
1750을 뺀 뒤 (49개)
얼마나 움직였나
평균
197.79
166.11
31.68 cm
중앙값
167.45
167.4
0.05 cm
표준편차
221.89
8.06
27.5배
키 열 50개 값. 1750 하나를 넣고 빼는 것만으로 잰 값입니다.
숫자를 천천히 읽어 보세요. 50명 가운데 단 한 명, 2%짜리 실수입니다.
그런데 평균은 30cm 넘게 움직였습니다. 표준편차는 8.06에서 221.89로,
27.5배가 되었습니다. 표준편차가 221이라는 말은 "이 반 학생들의 키는
평균에서 대략 221cm씩 흩어져 있다"는 뜻인데, 물론 사실이 아닙니다.
반면 중앙값은 0.05cm 움직였습니다.
1750을 넣든 빼든 한가운데 자리에 서 있는 사람은 거의 바뀌지 않기 때문입니다.
ℹ️ 표준편차가 커지면 무엇이 문제인가
표준편차는 "값들이 평균에서 얼마나 흩어져 있나"를 재는 자입니다.
그런데 이 자는 다음 단계에서 도구로 쓰입니다.
5차시에서 배울 정규화도, 잠시 뒤에 볼 z 점수 판정도 표준편차를 씁니다.
망가진 자로 재면 그다음 것이 전부 망가집니다.
1750 한 줄이 위험한 진짜 이유는 평균이 이상해져서가 아니라,
그 뒤의 모든 계산이 오염되기 때문입니다.
💡 그럼 항상 중앙값을 쓰면 되나요?
아닙니다. 중앙값은 순위만 보기 때문에
값들이 정직하게 퍼져 있을 때는 평균보다 정보를 덜 씁니다.
예를 들어 시험 점수 100명이 고르게 퍼져 있다면 평균이 더 많은 것을 말해 줍니다.
중앙값이 좋은 것은 "오염이 있을 수 있다"고 의심할 때입니다.
어느 쪽이 좋은지는 데이터를 보고 정하는 것이지 미리 정해 두는 것이 아닙니다.
3
튀는 값을 무엇으로 판정할까 — 두 기준은 다른 답을 낸다
다른 값들과 크게 동떨어진 값을 이상치(outlier)라고 합니다.
1750cm는 누가 봐도 이상치입니다. 그런데 "누가 봐도"에 기대면 안 됩니다.
까닭이 둘 있습니다.
사람마다 답이 다릅니다. 196.0cm는 이상치인가요?
누구는 "너무 크다"고 하고 누구는 "농구부에는 있다"고 합니다. 기준이 없으면 다툼만 남습니다.
눈으로 볼 수 있는 크기가 아닙니다. 오늘 표는 52줄이라 눈으로 되지만,
실제 데이터는 수십만 줄입니다. 사람이 아니라 규칙이 훑어야 합니다.
그래서 통계에는 이상치를 판정하는 규칙이 있습니다. 널리 쓰이는 것이 둘인데,
오늘 우리는 두 규칙이 같은 데이터에서 서로 다른 답을 내는 것을 보게 됩니다.
그게 오늘 수업의 핵심 장면입니다.
기준 ① — 사분위 범위(IQR) 1.5배 규칙
값을 크기순으로 줄 세운 다음, 4등분하는 자리 세 곳을 표시합니다.
아래에서 4분의 1 되는 자리를 Q1(1사분위수), 한가운데를 중앙값,
4분의 3 되는 자리를 Q3(3사분위수)라고 합니다.
Q1과 Q3 사이에는 전체의 정확히 절반이 들어 있습니다. 이 폭을
사분위 범위(IQR, Interquartile Range)라고 합니다.
상자그림(box plot)의 해부도입니다. 상자는 가운데 절반, 수염은 울타리 안에 있는
가장 바깥 값까지, 울타리 밖의 점이 이상치입니다.
우리 52명 키 데이터에서는 Q1 161.15 · Q3 169.75 · IQR 8.6이고,
울타리는 148.25 ~ 182.65입니다.
왜 하필 1.5배일까요? 딱 떨어지는 이유는 없습니다.
오랫동안 써 보니 적당했던 관습입니다. 그래서 이 숫자는 우리가 돌려 볼 수 있는 손잡이입니다.
잠시 뒤 시뮬레이터에서 직접 돌려 보겠습니다.
이 규칙으로 우리 키 열 50개를 판정하면 이렇게 나옵니다.
기준
계산에 쓴 값
정상 범위
이상치라고 잡은 값
IQR 1.5배
Q1 161.15 · Q3 169.75 IQR 8.6
148.25 ~ 182.65
147.2 · 147.8 · 196.0 · 1750.0 (넷)
z 점수 3
평균 197.79 표준편차 221.89
−467.87 ~ 863.45
1750.0 (하나)
같은 50개 값에 두 규칙을 댄 결과입니다. 넷과 하나 — 답이 다릅니다.
기준 ② — z 점수 3 규칙
z 점수는 "이 값이 평균에서 표준편차 몇 개만큼 떨어져 있나"를 재는 값입니다.
식은 간단합니다.
ℹ️ z 점수
z = | 값 − 평균 | ÷ 표준편차
z가 3보다 크면 이상치로 봅니다.
키가 평균에서 표준편차 세 개만큼 떨어져 있다는 뜻이니, 꽤 드문 값이라는 이야기지요.
그런데 위 표를 보세요. z 규칙은 1750 하나만 잡았습니다.
196.0cm도, 147.2cm도 "정상"이라고 했습니다. 정상 범위가 −467.87cm에서 863.45cm까지라니,
음수 키까지 정상으로 보고 있습니다. 무엇이 잘못된 걸까요?
가림 — 이상치가 이상치 찾는 규칙을 망가뜨린다
z 점수의 식을 다시 보세요. 평균과 표준편차가 들어갑니다.
그런데 그 평균과 표준편차는 1750이 들어 있는 채로 잰 값입니다.
197.79와 221.89 말이지요. 즉 찾아내려는 그 값이 자를 먼저 망가뜨려 놓았습니다.
결과가 이렇습니다. 196.0cm 학생의 z 점수를 계산해 보면 —
z = |196.0 − 197.79| ÷ 221.89 = 0.008
거의 0입니다. 196cm인 학생이 "평균에서 거의 벗어나지 않은
아주 평범한 값"으로 보입니다. 평균이 197.79cm니까 실제로 그렇게 보이는 게 맞기도 합니다 —
다만 그 평균이 거짓일 뿐이지요.
1750 하나만 먼저 걷어내고 다시 재면 어떻게 될까요.
평균 166.11 · 표준편차 8.06으로 자가 제자리를 찾고, 196.0의 z 점수는
0.008에서 3.708로 뜁니다. 이제야 걸립니다.
이것을 가림(masking)이라고 합니다.
큰 이상치 하나가 평균과 표준편차를 부풀려, 정작 찾아야 할 다른 값을 숨겨 버리는 현상입니다.
아래 그림에서 정상 범위가 좁아지자 196.0이 밖으로 밀려납니다.
IQR 규칙은 순위만 보므로 이런 일이 거의 없습니다 — 1750을 걷어내도 울타리가
148.25~182.65에서 147.85~182.65로 거의 움직이지 않습니다.
z 규칙에는 천장이 있다 — 작은 표에서는 아예 작동하지 않는다
여기 놀라운 사실이 하나 있습니다. 값이 n개일 때 z 점수는 아무리 커도
√(n−1)을 넘을 수 없습니다. 수학적으로 정해진 천장입니다.
값 하나를 아무리 크게 만들어도, 그 값이 평균과 표준편차를 함께 끌어올리기 때문에
z 점수는 그 위로 못 올라갑니다.
데이터
값의 개수 n
천장 √(n−1)
실제로 나온 최대 z
z > 3 규칙이 잡는가
여는 장면의 여덟 명 표
7
2.4495
2.4494
1750조차 못 잡는다
52명 표(키 열)
50
7.0
6.9955
1750만 잡는다
실제로 나온 최대 z가 천장에 소수점 넷째 자리까지 붙어 있습니다.
여덟 명 표에서 1750의 z 점수는 2.4494입니다. 3을 넘을 수가 없습니다.
즉 여덟 명짜리 표에서는 z > 3 규칙이 1750cm조차 잡아내지 못합니다.
일반적으로 값이 10개보다 적으면(√9 = 3) 이 규칙은 무엇도 잡지 못합니다.
규칙이 틀린 답을 내는 게 아니라 규칙 자체가 죽어 있는 것입니다.
⚠️ 판정은 통계가 하고, 결정은 사람이 한다
IQR 규칙은 넷을 잡았습니다 — 147.2 · 147.8 · 196.0 · 1750.0.
그런데 이 중 셋은 지우면 안 되는 진짜 값입니다.
147.2cm와 147.8cm는 실제로 키가 작은 학생이고, 196.0cm는 실제로 키가 큰 학생입니다.
지워 버리면 우리 반에서 가장 작은 학생과 가장 큰 학생이 사라집니다.
규칙은 "여기를 한번 봐라"까지만 말해 줍니다.
지울지 고칠지 그대로 둘지는 그 데이터가 무엇인지 아는 사람이 정합니다.
연봉 데이터에서 억대 연봉은 IQR 규칙에 반드시 걸리지만 진짜 값입니다.
지우는 순간 "이 회사에는 고액 연봉자가 없다"는 거짓말이 만들어집니다.
1750cm와 억대 연봉의 차이는 통계가 아니라 상식이 가릅니다.
🧪
손으로 ① — 표를 직접 고쳐 가며 두 기준을 본다
이제 52명 표를 여러분이 직접 만지는 차례입니다.
아래 시뮬레이터는 표의 어느 칸이든 고칠 수 있습니다. 칸을 하나 바꾸면
평균 · 중앙값 · 표준편차 · 사분위수 · 두 기준의 이상치 명단 · 상자그림이
그 자리에서 다시 계산됩니다.
💡 화면이 두 층으로 나뉘어 있습니다
① 판정 칸은 원래 표의 값으로 잽니다.
빈칸을 채우거나 행을 버리기 전의 값이지요. 이상치 명단은 여기서 나옵니다.
② 처리 결과 칸은 고른 방식대로 만든 열을 잽니다.
방식을 바꾸면 개수 · 평균 · 표준편차가 달라집니다.
상자그림은 ②의 값을 그리고, ①의 울타리를 선으로 얹습니다.
📋 데이터 표 편집기 — 빈칸과 이상치를 손으로 다뤄 본다INTERACTIVE
위 그림은 전체 범위, 아래 그림은 가운데를 확대한 것입니다.
같은 데이터를 다른 배율로 두 번 그렸습니다 — 1750이 들어 있으면 위 그림에서는
나머지 49명이 왼쪽 끝에 뭉쳐 아무것도 안 보이기 때문입니다.
파란 점선은 IQR 울타리, 노란 점선은 z 경계입니다.
초록 삼각형(▼)이 평균, 상자 안 흰 선이 중앙값입니다.
정상 값두 기준 다 잡음IQR만 잡음z만 잡음내가 채워 넣은 값IQR 울타리z 경계
① 판정 — 원래 표의 값으로 잰다 (처리 방식과 무관)
Q1 · Q3—
IQR—
IQR 울타리—
z 경계—
IQR이 잡은 값—
z가 잡은 값—
두 기준이 갈리는 값—
가장 큰 z (천장 √(n−1))—
② 처리 결과 — 고른 방식대로 만든 열
남은 값 개수—
평균—
중앙값—
표준편차—
[안내]표의 칸을 고치거나 손잡이를 돌리면 여기에 무슨 일이 일어났는지 적힙니다.
표를 직접 고치세요 — 빈칸으로 두려면 칸을 비우면 됩니다
번호
키(cm)
걸음 수
✍️ 과제 ① — 네 설정을 돌려 표를 채우세요
잴 열은 키(cm)로 두고 처리 방식만 바꿉니다.
② 처리 결과 칸의 세 숫자를 공책에 옮겨 적으세요. 네 번째 줄만 표를 직접 고쳐야 합니다.
설정
남은 값 개수
평균
표준편차
① 그대로 두기
② 행 버리기
③ 평균으로 채우기
④ 17번 칸에 175.0을 쳐 넣고 중앙값으로 채우기
네 줄을 다 적었으면 물음 하나에 답해 보세요 —
①과 ④의 평균 차이와 ③과 ④의 평균 차이 중 어느 쪽이 더 큰가요?
그 답이 "이 데이터의 진짜 문제가 무엇인가"를 말해 줍니다.
🔎 과제 ② — 손잡이를 돌려 문턱을 찾으세요
(가) IQR 배수. 1.5에서 0.1씩 올리며
「IQR이 잡은 값」 칸을 보세요. 명단이 바뀌는 배수가 세 번 있습니다.
196.0이 명단에서 빠지는 첫 배수는 얼마인가요?
반대로 1.5에서 내리면 무엇이 새로 잡히는지도 적으세요.
(나) z 컷. 3.0에서 1.0까지 내려 보세요.
명단이 바뀌나요? 바뀌지 않습니다. 왜 그런지 설명해 보세요.
이번엔 위로 올려서 아무것도 안 잡히는 첫 값을 찾으세요.
그 값이 어디서 왔는지 「가장 큰 z」 칸을 보면 알 수 있습니다.
(다) 반례 만들기.🔀 17번 키를 1750 ↔ 175.0 단추를 눌러 오타를 고쳐 보세요.
두 기준의 명단이 어떻게 달라집니까? 거의 같아집니다.두 기준이 다투었던 진짜 이유는 규칙이 달라서가 아니라 1750이 있었기 때문이라는 것을
여기서 확인할 수 있습니다.
ℹ️ 걸음 수 열로도 해 보세요
「잴 열」을 걸음 수로 바꾸면 같은 갈림이 다시 일어납니다.
IQR 규칙은 1870과 41000 둘을 잡고, z 규칙은 41000 하나만 잡습니다.
1870걸음은 47번 학생이 아팠던 날이고,
41000걸음은 12번 학생이 자전거 대회에 나간 날입니다.
둘 다 진짜 값입니다. 규칙은 여기서도 "봐라"까지만 말합니다.
4
지우기에도 대가가 있다 — 순서, 성능, 그리고 새로 생기는 편향
시뮬레이터에서 네 방식을 돌려 보았습니다. 결과를 한자리에 모으면 이렇습니다.
마지막 줄은 여러분이 17번 칸에 175.0을 직접 쳐 넣고 만든 줄입니다.
처리 방식
남은 개수
평균
중앙값
표준편차
① 행 버리기
46
166.27
167.45
5.89
② 평균으로 채우기
52
197.79
167.65
217.58
③ 중앙값으로 채우기
52
196.62
167.45
217.66
④ 그대로 두기
50
197.79
167.45
221.89
⑤ 오타를 고치고 중앙값으로 채우기
52
166.34
167.45
7.92
52명 표의 키 열을 다섯 방식으로 처리한 결과입니다. ②③④는 1750이 그대로 남아 있어 평균과 표준편차가 무너져 있습니다.
빈칸을 무엇으로 채우느냐가 평균을 바꾼 폭 : 1.17cm 1750을 손보느냐 마느냐가 평균을 바꾼 폭 : 30.29cm 26.0배입니다.
전처리를 처음 배우면 대개 "빈칸을 무엇으로 채울까"에 시간을 다 씁니다.
그런데 이 데이터의 진짜 문제는 빈칸이 아니라 1750 한 줄입니다.어디에 힘을 쓸지를 고르는 것도 전처리의 일부입니다.
그러면 ⑤가 정답일까요? 평균 166.34cm는 그럴듯해 보입니다.
하지만 "그럴듯해 보인다"는 것은 근거가 아닙니다.
전처리의 진짜 목적은 예쁜 평균을 얻는 것이 아니라 뒤에 오는 예측을 잘하게 만드는 것이니까요.
그건 잠시 뒤 코드에서 재 보겠습니다.
전처리에는 순서가 있다
우리는 두 가지 일을 합니다 — 빈칸 채우기와 이상치 걷어내기.
두 일을 다 한다면 어느 쪽을 먼저 해도 같지 않을까요? 해 보면 다릅니다.
순서 A — 걷어낸 다음 채운다
먼저 울타리 밖을 걷어냅니다. 남은 46개의 평균은 166.27.
그 값으로 빈칸 두 자리를 채웁니다.
남은 학생 48명 · 평균 166.27 · 표준편차 5.77
순서 B — 채운 다음 걷어낸다
먼저 빈칸을 채웁니다. 50개의 평균은 197.79.
그 값을 빈칸 두 자리에 부어 넣고, 그다음에 울타리를 다시 잡아 걷어냅니다.
남은 학생 46명 · 평균 166.27 · 표준편차 5.89
하는 일은 똑같은데 남은 학생이 48명에서 46명으로 줄었습니다.
두 명이 어디로 갔을까요? 순서 B는 197.79cm라는 있을 수 없는 값을
빈칸 두 자리에 부어 넣었습니다. 그리고 새로 잡은 울타리(148.68 ~ 183.28) 밖으로
그 두 값이 곧바로 밀려났습니다. 없던 이상치를 내 손으로 만들어 내고, 그것을 다시 버린 것입니다.
키를 안 적은 9번과 23번 학생은 그렇게 통계에서 사라졌습니다.
같은 실험을 중앙값으로 하면 두 순서가 48명 / 48명으로 똑같고
평균도 같습니다. 중앙값은 1750에 흔들리지 않으니 무엇을 먼저 하든 채우는 값이
167.45로 같기 때문입니다.
💡 순서를 타지 않는 방법이 더 안전한 방법이다
여기서 얻을 교훈은 "A가 옳고 B가 틀렸다"가 아닙니다.
어떤 방법은 순서를 타고 어떤 방법은 안 탄다는 것입니다.
여러 사람이 같은 데이터를 만지는 현장에서는 순서를 항상 지킬 수가 없습니다.
그럴 때 순서를 타지 않는 방법을 고르는 것이 실수를 줄입니다.
같은 이유로 5차시에서도, 11차시에서도 "무엇을 먼저 하느냐"가 다시 문제가 됩니다.
행을 버리면 누가 사라지는가
가장 손쉬운 처리는 "빈칸 있는 줄은 다 버리기"입니다.
52행 중 8행, 15.4%만 잃으면 되니까요.
그런데 잃는 것이 정말 15.4%뿐일까요?
수면 시간 열로 확인해 봅시다. 버려진 여덟 명이 어떤 사람들인지 보는 것입니다.
누구
인원
수면 시간 평균
전부 다
51명
6.804 시간
빈칸 있는 행을 버린 뒤 남은 쪽
44명
6.905 시간
버려진 쪽
7명
6.171 시간
수면 시간을 적지 않은 31번은 이 계산에서 빠져 51명 · 7명이 됩니다.
남은 쪽과 버려진 쪽의 차이는 0.733시간, 다시 말해 44분입니다.
버려진 사람들은 우연히 뽑힌 사람들이 아닙니다.
버려진 여덟 명을 하나씩 보면 이유가 보입니다.
걸음 수를 안 적은 세 명(5번 · 28번 · 50번)의 수면 시간이
4.6 / 4.9 / 5.1시간입니다. 표에서 가장 적게 자는 학생들입니다.
걸음 수를 재는 앱을 켜 두는 것도, 그 기록을 옮겨 적는 것도 잊게 만드는 무언가가
이 학생들에게 있었던 것이지요.
⚠️ 3차시의 편향이 여기서 다시 태어난다
3차시에서 우리는 학습 데이터가 한쪽으로 치우치면
어두운 털 강아지 정확도가 20.0%에 머무는 것을 보았습니다.
그때의 치우침은 데이터를 모을 때 생긴 것이었습니다.
오늘 본 것은 다릅니다. 데이터는 고르게 모였는데
내가 정리하면서 한쪽을 잘라 냈습니다.
'기록을 안 한 것'과 '잠이 부족한 것'이 함께 간다면, 빈칸 있는 행을 버리는 순간
잠 못 자는 학생들이 통째로 사라집니다. 그렇게 만든 모델은
"우리 학교 학생은 평균 6.9시간 잔다"고 말하겠지요.
표집 편향을 전처리 단계에서 내 손으로 새로 만든 것입니다.
💻
손으로 ② — 52명을 코드로 훑는다
시뮬레이터는 손잡이를 돌려 보는 도구였습니다. 이제 같은 계산을 직접 짜 봅니다.
규칙을 손으로 짜 보면 "IQR 규칙"이라는 말이 세 줄짜리 산수였다는 것을 알게 됩니다.
먼저 몸을 풉니다. 여는 장면의 여덟 명 표입니다. 실행 단추만 누르면 됩니다.
394.4와 168.5가 찍혔나요? 그리고 중앙값 줄이
169.0 → 168.5로 0.5cm밖에 안 움직인 것을 확인하세요.
같은 값 하나를 뺐는데 평균은 225.9cm를 움직였습니다.
⚠️ 아래 프로그램에는 빈칸이 네 곳 있습니다
전부 통계의 정의를 그대로 옮겨 적는 자리입니다.
채우지 않고 실행하면 SyntaxError가 납니다 — 정상입니다.
① median() — 개수가 짝수라 한가운데가 없을 때.
힌트: 가운데에 걸친 두 값 s[n//2 - 1]과 s[n//2]의 평균
② stdev() — 흩어진 정도.
힌트: 평균과의 차를 제곱해 모두 더하고, 개수로 나눈 뒤, 제곱근
③ zscore() — 표준편차 몇 개만큼 떨어졌나.
힌트: 평균과의 차의 절댓값을 표준편차로 나눈다
④ iqr_rule() — 정상으로 볼 범위 두 자리.
힌트: Q1에서 IQR의 1.5배만큼 아래, Q3에서 1.5배만큼 위
💡 출력이 132줄입니다 — 이 넷을 먼저 찾으세요
【3】 평균이 31.68cm 움직이고 중앙값이 0.05cm 움직인 줄.
시뮬레이터에서 본 것과 같은 숫자입니다.
【4】 두 기준이 갈리는 값 [147.2, 147.8, 196.0]과
196.0의 z 점수 0.008. 그리고 1750을 걷어낸 뒤 3.708로 뛰는 줄.
【6】 처리 방식이 예측 성능을 얼마나 바꾸는지 — 아래에서 자세히 봅니다.
【8】 버려진 일곱 명의 수면 시간 목록. 5번 · 28번 · 50번을 찾아보세요.
【6】이 말하는 것 — 그럴듯한 평균과 좋은 처리는 다르다
앞에서 미뤄 둔 물음이 있었지요. "⑤가 정답인가?"
코드의 여섯 번째 단계가 그것을 잽니다. 방법은 이렇습니다.
52명 중 5의 배수 번호 열 명(5 · 10 · … · 50)을 시험지로 미리 떼어 둡니다.
이 열 명에게는 어떤 손질도 하지 않습니다.
나머지 42명에게만 다섯 가지 처리를 각각 해 봅니다.
처리한 42명으로 키에서 몸무게를 맞히는 직선을 하나씩 긋습니다.
그 직선으로 손대지 않은 열 명의 몸무게를 맞혀 보고, 몇 kg씩 틀리는지 잽니다.
처리 방식
훈련 행
기울기
테스트 평균 오차
① 행 버리기
34
0.6013
4.254 kg
② 평균으로 채우기
42
0.0053
6.314 kg
③ 중앙값으로 채우기
42
0.0054
6.317 kg
④ 그대로 두기
38
0.0053
6.343 kg
⑤ 오타를 고치고 중앙값
42
0.745
3.785 kg
기울기 = 키가 1cm 늘 때 몸무게가 몇 kg 느는가. 오차는 손대지 않은 열 명에게서 잰 값입니다.
먼저 기울기 칸을 보세요. 1750이 훈련 데이터에 남아 있는 ②③④는
기울기가 0.005입니다. 거의 0이지요. "키가 10cm 커져도 몸무게는 0.05kg 는다"는
말이 됩니다. 직선이 1750이라는 한 점에 끌려가 옆으로 누워 버린 것입니다.
42명 중 한 명이 나머지 41명을 이겼습니다.
다음으로 ①과 ⑤를 견주어 보세요. 둘 다 1750을 없앴는데
오차가 4.254kg과 3.785kg으로 갈립니다.
왜일까요? ①은 IQR이 잡은 147.2 · 147.8 · 196.0까지 함께 버렸기 때문입니다.
가장 작은 학생과 가장 큰 학생을 빼고 나면 키의 폭이 좁아지고,
좁은 폭에서 그은 직선은 폭 넓은 시험지 앞에서 무뎌집니다.
ℹ️ 여기서 쓴 '직선 긋기'는 아직 배우지 않은 것입니다
점들에 가장 잘 맞는 직선을 찾는 방법은
9차시(경사하강법)와 10차시에서 제대로 배웁니다.
오늘은 그것을 자로만 썼습니다 — "전처리를 바꾸면 성능이 바뀐다"를 재는 자 말입니다.
기울기와 절편이 어떻게 정해지는지는 지금 몰라도 됩니다.
지금 알아야 할 것은 하나입니다. 전처리는 취향이 아니라 성능으로 고른다.
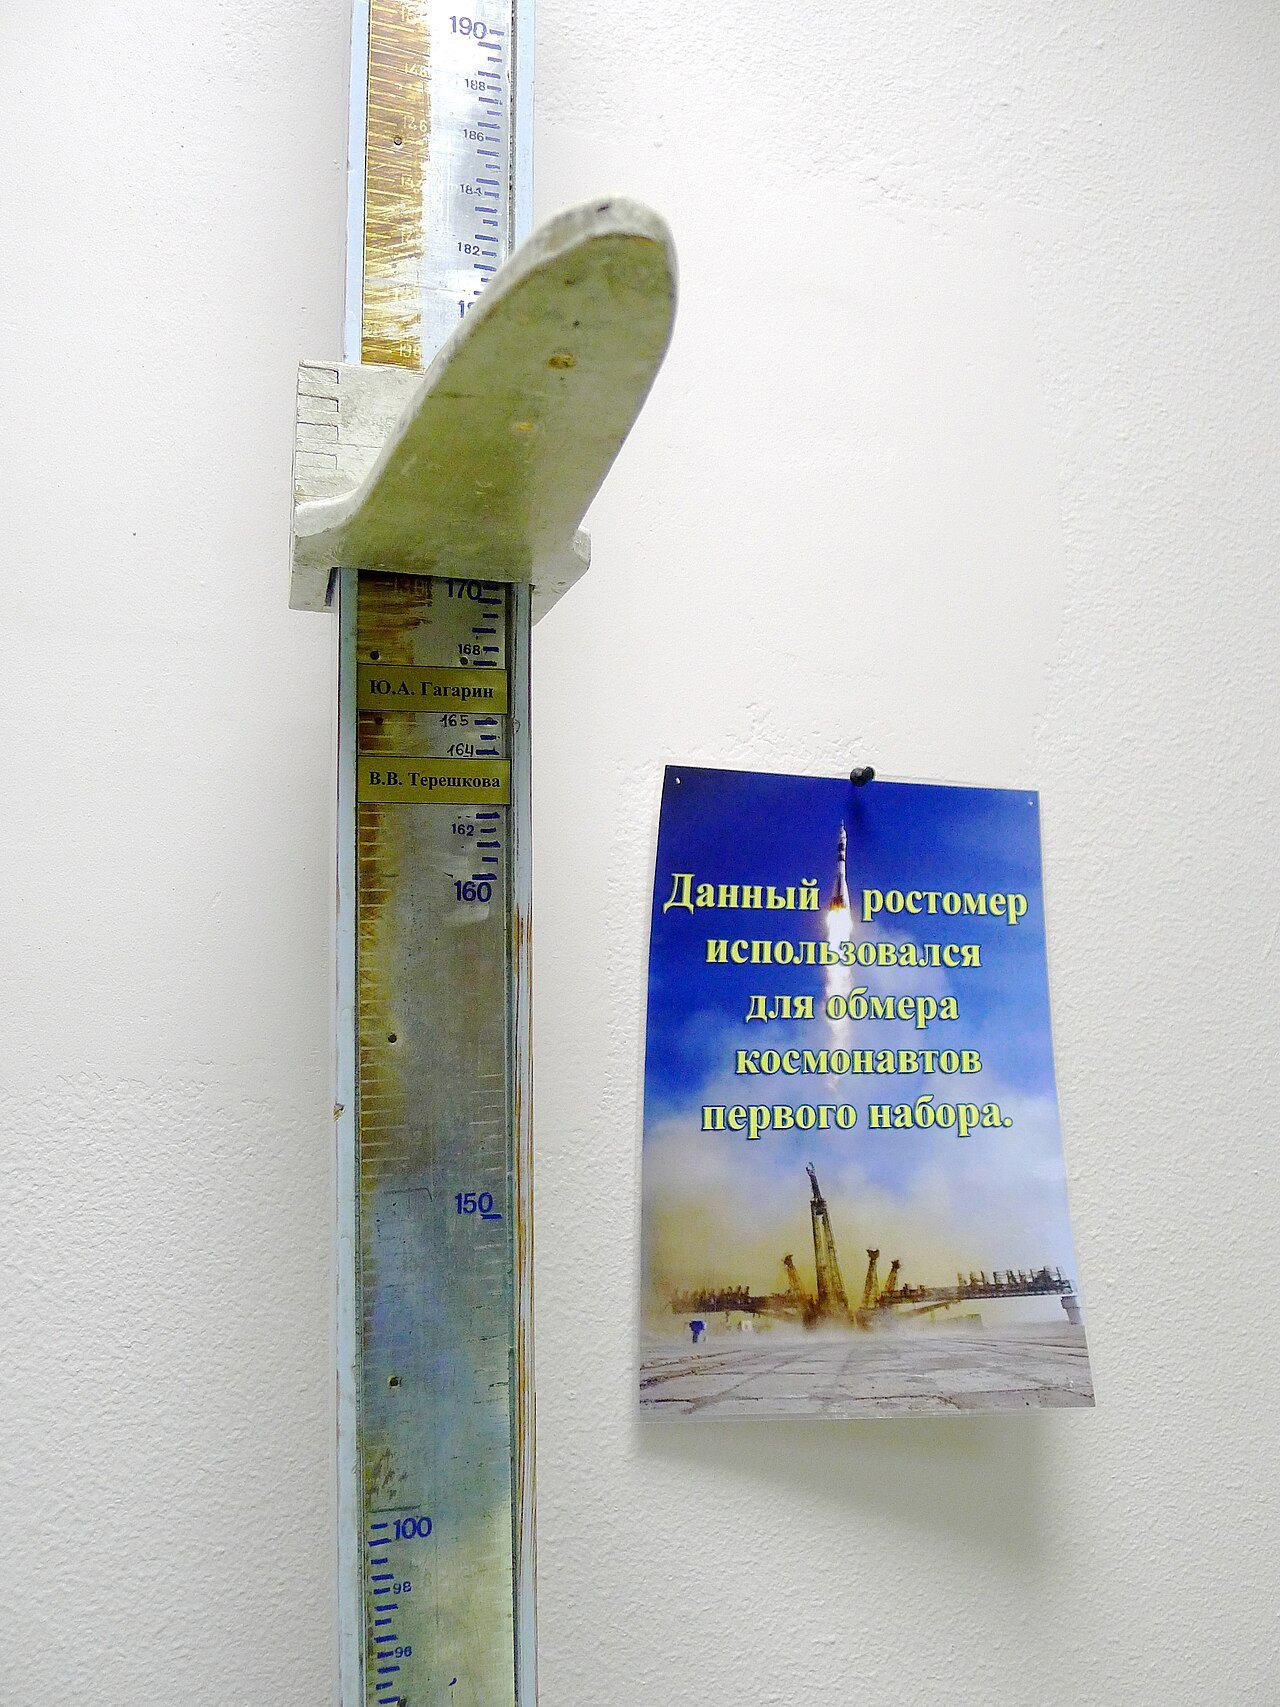
러시아의 우주복 제작사 즈베즈다에 남아 있는 신장계입니다. 옆의 안내문은 이 신장계로 첫 번째로 뽑힌 우주 비행사들의 키를 쟀다고 적고 있고,
눈금 160과 170 사이에 유리 가가린과 발렌티나 테레시코바의 이름판이 붙어 있습니다.
이 막대로는 1750이라는 값이 나올 수 없습니다 — 그런 숫자는 재는 자리가 아니라 표로 옮겨 적는 길에서 생깁니다.
전처리는 세상을 고치는 일이 아니라 옮겨 적힌 것을 고치는 일입니다.출처: Samantha Cristoforetti, Wikimedia Commons (CC BY 2.0)
🔧 코드를 고쳐 보는 도전 셋
빈칸을 0으로 채워 보세요.parse() 함수에서
float(cell) if cell else None의 None을 0.0으로 바꿉니다.
평균이 190.18이 되고, IQR 이상치 명단에 0.0이 들어옵니다.
없던 이상치가 생긴 것이지요.
※ 이때 【5】에서 ZeroDivisionError가 나며 프로그램이 멈춥니다. 고장이 아닙니다 —
빈칸이 하나도 남지 않아 "무엇으로 채우느냐가 평균을 바꾼 폭"이 0이 되고, 거기서 나눗셈을 하기 때문입니다.
빈칸을 0으로 메운 순간 빈칸을 어떻게 채울까라는 물음 자체가 사라졌다는 뜻입니다.
IQR 배수 1.5를 바꿔 보세요.iqr_rule() 안의 두 1.5를
100으로 바꿔 봅니다. 정상 범위가 -698.85 ~ 1029.75가 되는데도
1750은 여전히 잡힙니다. 진짜 오류는 어느 기준으로도 걸립니다.
z 컷 3.0을 1.0으로 낮춰 보세요.z_rule(vals, cut=3.0)의
기본값을 고칩니다. 명단이 늘어날 것 같지만 여전히 1750 하나뿐입니다.
나머지 49개의 z가 전부 0.24 아래이기 때문입니다.
손잡이를 돌려도 아무 일이 안 일어나는 실험도 훌륭한 실험입니다.
📖
정리 — 오늘 얻은 판단 기준
❓
빈칸은 까닭부터 묻는다
기록 누락이면 채우고, 응답 거부면 표시를 남기고, 해당 없음이면 손대지 않습니다.
0으로 바꾸는 것은 셋 다 아닙니다.
⚖️
평균은 끌려가고 중앙값은 버틴다
50명 중 한 명 때문에 평균은 31.68cm 움직이고 중앙값은 0.05cm 움직였습니다.
오염이 의심되면 중앙값입니다.
📏
판정 기준은 하나가 아니다
IQR은 넷을 잡고 z는 하나를 잡았습니다.
z는 이상치에 자가 망가지고(가림), 표가 작으면 아예 죽습니다(√(n−1) 천장).
채우는 방법이 바꾼 폭 1.17cm, 1750을 손본 것이 바꾼 폭 30.29cm — 26.0배입니다.
🕳️
버리기에는 대가가 있다
성능이 3.785에서 4.254kg으로 무뎌지고, 잠 못 자는 학생들이 통째로 사라집니다.
전처리가 새 편향을 만듭니다.
오늘 우리는 52명 표를 깨끗하게 만들었습니다.
빈칸을 어떻게 할지 정했고, 1750을 어떻게 할지 정했고,
그 결정이 뒤의 예측을 얼마나 바꾸는지 숫자로 확인했습니다.
그런데 이 표에는 아직 문제가 하나 더 남아 있습니다.
키는 147~196이고 걸음 수는 1870~41000입니다.
두 열을 나란히 놓고 "이 학생과 저 학생이 얼마나 비슷한가"를 재려고 하면
걸음 수가 키를 완전히 눌러 버립니다. 단위가 다르기 때문입니다.
다음 시간에는 서로 다른 단위의 열을 같은 자로 옮기는 법을 배웁니다.
✅
확인 문제
✍️ 문제마다 답을 쓰고 제출하기를 누르세요. 제출하면 모범 답안이 열리고, 제출한 답은 선생님께 전달됩니다.
1. 값이 비는 까닭 세 가지를 쓰고,
각각에 맞는 처방을 짝지으시오. 그리고 표만 보고는 셋을 구별할 수 없는 이유를 한 문장으로 쓰시오.
📖 모범 답안
① 기록을 빠뜨렸다 — 값은 세상에 있었는데 적는 사람이 놓친 경우.
비어 있다는 사실 자체에 뜻이 없으므로 남은 값의 대표값(평균·중앙값 등)으로 채워도 된다.
② 답하기를 거부했다 — 몸무게·소득처럼 일부러 비운 경우.
비어 있다는 사실이 곧 정보이고 대개 한쪽으로 치우쳐 있다.
평균으로 채우면 그 정보가 사라지므로 '무응답'이라는 표시를 따로 남기는 편이 낫다.
③ 애초에 해당이 없다 — '마지막 아르바이트 시급' 칸처럼 값이 있을 자리가 아닌 경우.
채우면 안 된다. 채우는 순간 하지도 않은 일을 한 것으로 만든다.
구별할 수 없는 이유: 셋 다 표에서는 똑같은 빈칸으로 보이기 때문이다.
까닭은 값이 아니라 데이터가 어떻게 걷혔는지에 들어 있고, 그건 표가 아니라 걷은 사람이 안다.
2. 설문에서 나이를 적지 않은 사람들의 빈칸을
전체 평균 나이로 채웠다. 무엇을 잃었는가?
그리고 이 처리가 통계에 어떤 흔적을 남기는지 함께 설명하시오.
📖 모범 답안
잃은 것 — "이 사람은 나이를 밝히지 않았다"는 사실 자체.
나이를 안 적는 사람들은 우연히 흩어져 있지 않고 대개 한쪽으로 몰려 있다
(예: 나이가 아주 많거나 아주 적은 쪽). 평균으로 채우면 그 사람들이
전부 '딱 평균 나이인 사람'으로 바뀌어 치우침의 증거가 지워진다.
흔적: 평균 자체는 거의 그대로인데 표준편차가 줄어든다.
평균과 똑같은 값이 여러 개 새로 생겼으니 흩어짐이 작아 보이는 것이다.
그러면 뒤에서 z 점수로 이상치를 찾을 때 자가 어긋나고,
"데이터가 아주 고르게 모였다"는 잘못된 인상을 준다.
또 하나 — 나이 히스토그램을 그리면 평균 자리에 있을 수 없는 뾰족한 봉우리가 생긴다.
3.오늘 시뮬레이터에서 직접 찾은 값을 쓰시오.
(가) 키 열에서 IQR 배수를 1.5부터 0.1씩 올릴 때 196.0이 이상치 명단에서 빠지는 첫 배수는 얼마인가?
(나) z 컷을 3.0에서 1.0까지 내려도 명단이 바뀌지 않는 까닭은 무엇인가?
(다) z 컷을 올릴 때 아무것도 잡히지 않는 첫 값은 얼마이며, 그 값은 어디서 왔는가?
📖 모범 답안
(가) 3.1이다. 위쪽 울타리는 Q3 + k × IQR = 169.75 + 8.6k이므로
k = 3.1이면 196.41이 되어 196.0을 넘어선다(k = 3.0에서는 195.55라 아직 잡힌다).
내리는 쪽으로는 1.1에서 151.5·179.9가 더해져 여섯 개가 되고,
0.5까지 내리면 154.2·174.5 같은
아주 평범한 키까지 열한 개가 잡힌다. 배수를 좁힐수록 진짜 값을 더 많이 버리게 된다는 뜻이다.
(나) 1750이 표준편차를 통째로 부풀려 놓았기 때문이다.
표준편차가 221.89라서 1750을 뺀 나머지 49개의 z 점수가 전부 0.24 아래에 눌려 있다.
컷을 1.0까지 내려도 그 아래로는 내려가지 않으므로 명단은 [1750.0] 하나 그대로다.
(다) 7.0이다. 값이 n개일 때 z 점수의 천장은 √(n−1)이고,
키 값이 50개이므로 √49 = 7.0이다. 실제로 나온 가장 큰 z는 6.9955로
천장에 붙어 있다. 컷이 7.0이 되는 순간 어떤 값도 그 위로 갈 수 없다.
4.오늘 코드를 실행해 얻은 숫자로 답하시오.
(가) 여덟 명 표에서 손질 전후 평균은 각각 얼마였고, 왜 그렇게 크게 달라졌는가?
(나) 52명 키 열의 Q1 · Q3 · 정상 범위를 적고, 두 판정 기준이 갈리는 값 셋을 쓰시오.
(다) 196.0cm 학생의 z 점수는 얼마였고, 1750을 걷어낸 뒤에는 얼마가 되었는가? 이 현상의 이름은?
📖 모범 답안
(가) 394.4cm → 168.5cm. 평균은 값을 전부 더해서 개수로 나눈다.
1750은 175보다 1575만큼 크고, 이 크기가 그대로 합계에 들어간다.
일곱 명으로 나누면 1575 ÷ 7 ≒ 225이니 평균이 그만큼 밀려 올라가는 것이다
(빈칸 뺀 일곱 명과 1750까지 뺀 여섯 명을 견주면 정확히는 225.9cm다).
같은 표에서 중앙값은 169.0에서 168.5로 0.5cm 움직였을 뿐이다 — 중앙값은 순위만 보기 때문이다
(여섯 명이 되어 한가운데가 168과 169 둘이라, 그 평균인 168.5가 중앙값이다).
(나) Q1 161.15 · Q3 169.75 · IQR 8.6 · 정상 범위 148.25 ~ 182.65.
IQR 규칙은 [147.2, 147.8, 196.0, 1750.0] 넷을 잡고
z 규칙은 [1750.0] 하나만 잡는다.
갈리는 값은 147.2 · 147.8 · 196.0 셋이며, IQR만 잡은 것이다.
(다) 0.008 → 3.708. 이 현상을 가림(masking)이라고 한다.
z 점수는 평균과 표준편차로 계산하는데, 그 둘이 1750에 오염되어 있었다
(평균 197.79 · 표준편차 221.89). 196.0은 그 거짓 평균 바로 옆이라 z가 거의 0이 된 것이다.
1750을 걷어내 평균 166.11 · 표준편차 8.06으로 자가 제자리를 찾자 z가 3.708로 뛰었다.
이상치를 찾는 규칙이 이상치 때문에 망가지는 것이 z 규칙의 약점이다.
5. 이상치로 판정되었지만 지우면 안 되는 값의 예를 하나 들고,
그것이 1750cm와 무엇이 다른지 설명하시오. 오늘 데이터 안에서도 하나 찾아 함께 쓰시오.
📖 모범 답안
예: 연봉 데이터의 억대 연봉. IQR 규칙에 반드시 걸리지만 진짜 값이다.
지우면 "이 회사에는 고액 연봉자가 없다"는 거짓말이 만들어지고,
임금 격차를 다루는 분석이라면 지운 값이 곧 분석 대상이었던 셈이 된다.
(같은 예: 지진 규모 기록의 대지진, 병원 데이터의 아주 드문 질환.)
1750cm와의 차이 — 세상에 있을 수 있느냐 없느냐.
1750cm인 사람은 존재할 수 없으므로 기록의 오류이고, 게다가 175.0의 자릿수를
잘못 친 것이라는 원인까지 짚을 수 있다. 억대 연봉은 드물 뿐 존재한다.
이 구별은 통계가 아니라 그 데이터가 무엇인지 아는 사람의 상식이 한다.
오늘 데이터 안의 예: IQR이 잡은 147.2 · 147.8 · 196.0은
셋 다 진짜 키다. 지우면 반에서 가장 작은 두 학생과 가장 큰 학생이 사라진다.
걸음 수 열에서는 41000(12번, 자전거 대회)과 1870(47번, 아픈 날)이
역시 진짜 값이다. 실제로 【6】에서 이 셋을 함께 버린 '행 버리기'가
오차 4.254kg으로 ⑤의 3.785kg보다 나빴다.
6. 어떤 학생이 "빈칸 있는 행은 전부 지우자"고 제안했다.
(가) 3차시에서 배운 어떤 문제가 새로 생길 수 있는지, 오늘 데이터의 숫자를 들어 설명하시오.
(나) 이 학생이 "그럼 평균으로 다 채우고 나서 이상치를 걷어내자"로 바꾸었다.
이 순서에 어떤 함정이 있는가?
📖 모범 답안
(가) 표집 편향이 전처리 단계에서 새로 생긴다.
빈칸 있는 8행을 버리면 52행 중 15.4%가 사라지는데, 사라지는 사람이 무작위가 아니다.
수면 시간 평균이 전체 51명 6.804시간 → 남은 44명 6.905시간으로 올라가고,
버려진 7명만 재면 6.171시간이다. 남은 쪽과 0.733시간, 44분 차이다.
특히 걸음 수를 안 적은 5 · 28 · 50번의 수면이 4.6 / 4.9 / 5.1시간으로
표에서 가장 적다. '기록을 안 한 것'과 '잠이 부족한 것'이 함께 가므로,
행을 버리는 순간 잠 못 자는 학생들이 통째로 사라진다.
3차시의 치우침은 데이터를 모을 때 생겼지만, 이것은 정리할 때 내 손으로 만든 것이다.
(나) 없던 이상치를 스스로 만들어 내고, 그것을 다시 버리게 된다.
1750이 섞인 채로 낸 평균은 197.79cm다. 그 값을 빈칸 두 자리에 부어 넣으면
197.79cm인 학생이 둘 생기고, 새로 잡은 울타리(148.68 ~ 183.28) 밖이라 곧바로 걷어내진다.
결과적으로 남은 학생이 48명(걷어내고 채우기)에서 46명(채우고 걷어내기)으로 줄고,
9번 · 23번은 키를 안 적었다는 이유만으로 통계에서 사라진다.
중앙값으로 채우면 두 순서가 48명 / 48명으로 같다 —
순서를 타지 않는 방법이 더 안전한 방법이다.
🔁 되돌아보기
오늘 우리는 빈칸 여덟 자리와 1750 한 줄을 다섯 가지 방식으로 처리해 보고
숫자로 골랐습니다. 그 과정에서 두 판정 기준이 서로 다른 답을 내는 것을 보았고,
지우기에도 대가가 있다는 것을 성능과 편향으로 확인했습니다.
다음 시간에는 147~196과 1870~41000처럼 폭이 전혀 다른 두 열을
하나의 자로 맞추는 법을 배웁니다. 그것을 정규화라고 합니다.
🔎
더 알아보기
튀는 값을 지우지 않아서 찾은 발견, 가림에 강한 자, 그리고 빈칸에 붙은 세 이름
역사
너무 낮은 오존 값 — 이상치일까, 발견일까
1985년 영국 남극조사단의 조지프 파먼, 브라이언 가디너, 조너선 섕클린은 남극 핼리 기지에서 땅 위의 관측 기구로
잰 오존 양이 봄철마다 크게 줄고 있다고 학술지 『네이처』에 발표했습니다. 이른바 오존 구멍의 발견입니다.
믿기 어려운 숫자였기에 연구팀은 발표 전에 관측 기구가 잘못된 것은 아닌지부터 거듭 확인했습니다. 오늘 우리가 1750cm를 보고 한 생각과 같은 순서지요.
같은 무렵 미국 항공우주국(NASA)은 1978년에 쏘아 올린 님버스 7호 위성으로 지구 전체의 오존을 재고 있었습니다.
흔히 "위성 프로그램이 너무 낮은 값을 이상치로 보고 지워 버려서 구멍을 놓쳤다"고 전해지지만, NASA 오존 자료 처리팀을 이끈 리처드 맥피터스가 통계학자 프리드리히 푸켈스하임에게 보낸 편지(1990년 논문에 소개)의 설명은 다릅니다.
처리 프로그램은 믿기 어려울 만큼 낮은 값에 '의심스럽다'는 표시를 붙였을 뿐 지우지 않았고,
연구자들은 그 값이 진짜인지 따져 보던 중이었다는 것입니다. 위성 자료는 뒤에 오존 구멍이 남극 대륙을 덮을 만큼 넓다는 것을 보여 주었습니다.
어느 쪽 이야기든 교훈은 오늘 차시와 같습니다. 규칙은 "여기를 봐라"까지만 말하고, 지울지 말지는 사람이 정합니다.
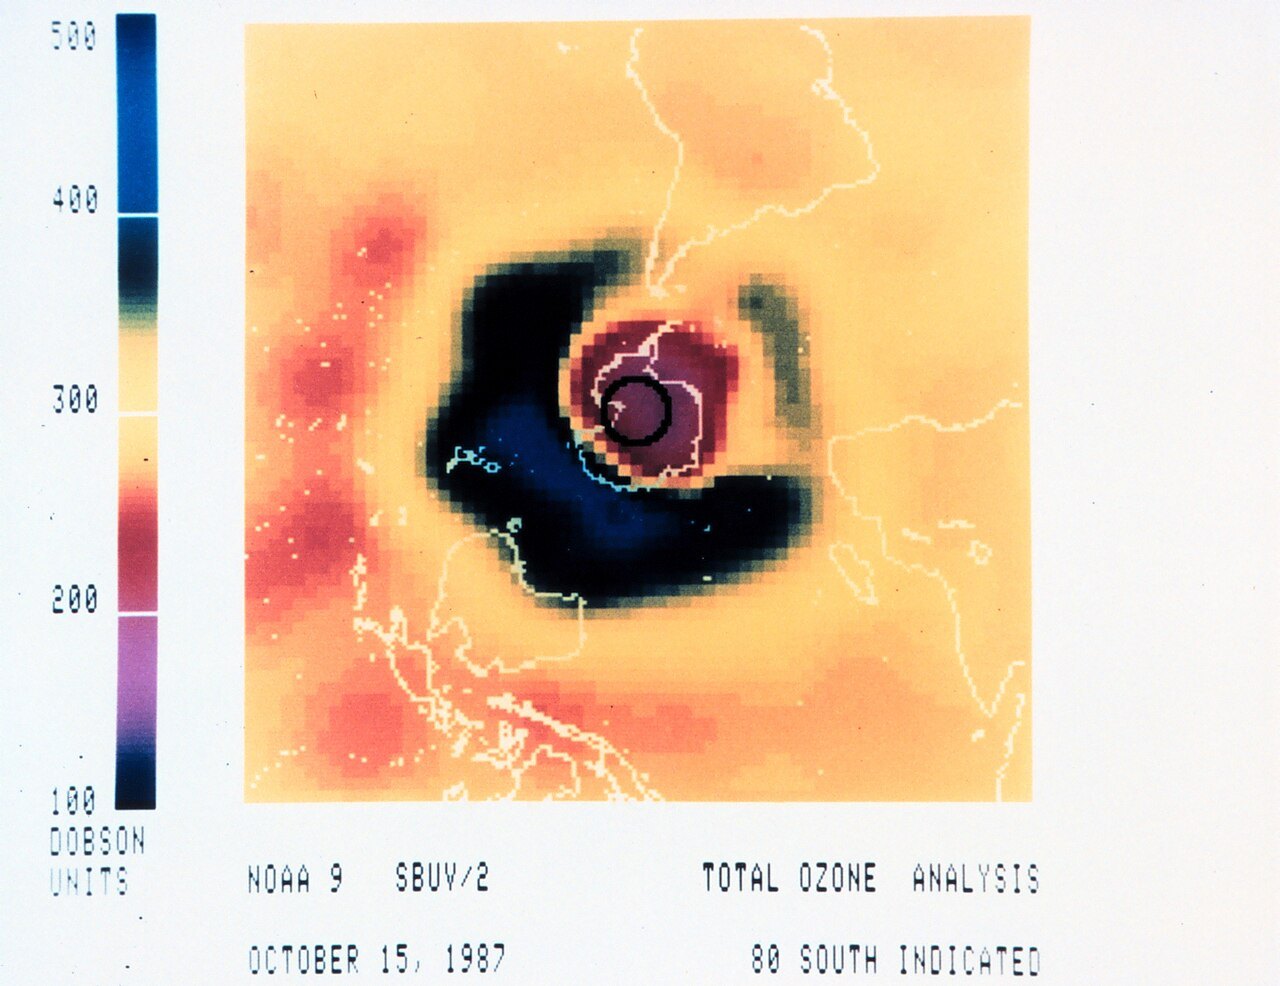
판정된 값을 지우지 않고 표시를 남겨 두었기에 다시 들여다볼 수 있었습니다. 사진은 1987년 10월 15일 NOAA-9 위성이 잰 남극 상공의 오존 지도로,
가운데가 주변보다 뚜렷이 낮습니다. 같은 해에 오존층을 파괴하는 물질을 줄이자는 몬트리올 의정서가 채택되었습니다.
사진: 남극 상공 오존 총량 지도(1987년 10월 15일, NOAA-9 SBUV/2) · 출처: National Oceanic & Atmospheric Administration (NOAA), Wikimedia Commons (Public domain) · 글: Pukelsheim, F. (1990), Robustness of statistical gossip and the Antarctic ozone hole, IMS Bulletin 19
원리 더 깊이
가림을 이기는 자 — 중앙값과 MAD로 만든 z 점수
오늘 z 규칙이 196.0을 놓친 까닭은 식 속의 평균과 표준편차가 1750에 끌려갔기 때문이었습니다.
그렇다면 자 자체를 튼튼한 것으로 바꾸면 어떨까요? 평균 대신 중앙값을, 표준편차 대신
MAD(Median Absolute Deviation, 중앙값 절대 편차)를 쓰는 것입니다.
MAD는 "각 값이 중앙값에서 떨어진 거리"를 모두 구한 뒤 그 거리들의 중앙값을 잡은 것입니다.
우리 52명 키 열(값 50개)에서 중앙값은 167.45, MAD는 2.95입니다. 1750은 거리 목록의 맨 끝 하나일 뿐이라
MAD를 거의 흔들지 못합니다. 식 앞의 0.6745는 데이터가 종 모양(정규분포)으로 퍼져 있을 때
이 값이 보통 z 점수와 같은 눈금이 되도록 맞추는 수이고, 통계학자 이글레비츠와 호글린은 이렇게 만든 값이
3.5를 넘으면 이상치로 의심하자고 제안했습니다.
직접 계산해 보면 196.0의 로버스트 z는 6.53으로 한 번에 잡히고, 명단은 147.2 · 147.8 · 151.5 · 196.0 · 1750.0 다섯이 됩니다.
1750을 빼고 다시 재도 196.0은 6.65로 거의 그대로입니다. 오늘 배운 두 교훈 — 평균은 끌려가고 중앙값은 버틴다,
판정은 통계가 하고 결정은 사람이 한다 — 가 이 자 하나에 함께 들어 있습니다. 147.2와 196.0은 여기서도 진짜 키입니다.
생각할 거리
빈칸에 붙은 세 이름 — MCAR · MAR · MNAR
개념 1에서 우리는 "이 칸은 왜 비었을까"를 먼저 물었습니다. 통계학자 도널드 루빈은 1976년 논문에서
이 물음을 빈칸이 무엇과 함께 움직이느냐로 바꾸어 나누었고, 지금도 데이터 분석에서 그 이름을 그대로 씁니다.
MCAR은 빈칸이 아무것과도 상관없는 경우, MAR은 표에 적힌 다른 열과 함께 움직이는 경우,
MNAR은 비어 있는 그 값 자체 때문에 비는 경우입니다.
오늘 【8】에서 본 5 · 28 · 50번이 좋은 예입니다. 걸음 수가 빈 학생들은 수면 시간이 4.6 · 4.9 · 5.1시간으로 가장 짧았지요.
빈칸이 표에 적힌 다른 열(수면)과 함께 가니 MAR에 가깝습니다. 이때 빈칸 있는 행을 버리면 오늘처럼 평균이 한쪽으로 밀립니다.
대신 수면 같은 다른 열을 단서로 빈칸을 추정하면 치우침을 상당 부분 되돌릴 수 있습니다. 개념 2 표의 '다른 특성으로 예측'이 이 방법입니다.
가장 까다로운 것은 MNAR입니다. 몸무게가 많이 나가는 사람일수록 몸무게 칸을 비운다면, 그 사실은 표 안의 어떤 숫자로도 확인할 수 없습니다 —
답이 바로 빈칸 속에 있으니까요. 이때는 조사를 설계한 사람의 지식이나 추가 조사가 필요합니다.
개념 1의 ③ '애초에 해당이 없다'는 셋 어디에도 들지 않습니다. 값이 빠진 것이 아니라 값이 있을 자리가 아니기 때문입니다.